突变率与变异效应预测:保守性偏差和真实的稳定性缓冲
Mutation rate heterogeneity biases variant effect prediction and reveals genuine mutational robustness
比较 50 种错义变异预测与保守性分数,并用 DMS 稳定性数据检验突变率依赖:多数分数把较难发生的替换预测得更有害,但真实稳定性缓冲只能解释其中一部分关联。
本文目录
全文解读|AJHG Article in Press,2026-09-03 在线发表,已同行评议。 本次阅读依据用户提供的 14 页 PDF(含 1 页封面),覆盖主文、Methods 和 Figures 1–5;附件未包含独立 supplemental text、Figures S1–S5 与 Tables S1–S10,相关补充分析仅按主文报告。封面与页脚的 2026-10-01 为卷期日期。论文 · 在线日期记录 · 作者代码
这篇论文检验一个容易被功能注释掩盖的问题:某种替换很少出现在自然序列中,既可能因为它受到强选择,也可能因为这种突变本来就很少发生。作者用生殖系突变率、50 种预测或保守性分数,以及两个已发表的深度突变扫描(DMS)数据集,把预测分数中的统计偏差与蛋白稳定性的真实生物学关联分开。这里的 VEP 指变异效应预测器,并非专指 Ensembl VEP 软件。
低突变率为什么会被误读成高功能重要性
系统发育方法将观察到的替换数与中性模型的期望比较。若中性模型主要表达全局平均的单核苷酸替换率,未充分表达 CpG、局部序列背景和区域突变率,同样少的替换在低突变率位点就可能被过度解释为选择约束。蛋白序列似然模型也有类似问题:自然序列中某个氨基酸替换很罕见,并不等价于其功能损害很大。监督预测器又可能通过保守性特征、其他预测器输出,或训练标签组之间不同的突变谱,继承这种关联。
另一个机制使方向更复杂。即便中性模型正确考虑突变率,在相同选择强度下,高突变率位点提供更多“本应发生却没有发生”的替换机会,因此约束检验具有更高功效,可能获得更极端的保守性显著性分数。分数与突变率正相关也未必代表更大的生物学效应;比对深度和位点集合的约束强度都能改变关联方向。
作者以四重简并同义替换作为近中性对照。Figure 1E 中,100-way vertebrate 与 470-way mammalian phyloP 对这类替换的突变率 Kendall’s 分别约为 和 。它们不能简单归因于氨基酸功能变化。四重简并位点仍可能承载剪接、表达等约束,因此这是有说服力的负对照,而非所有位点严格中性的证明。
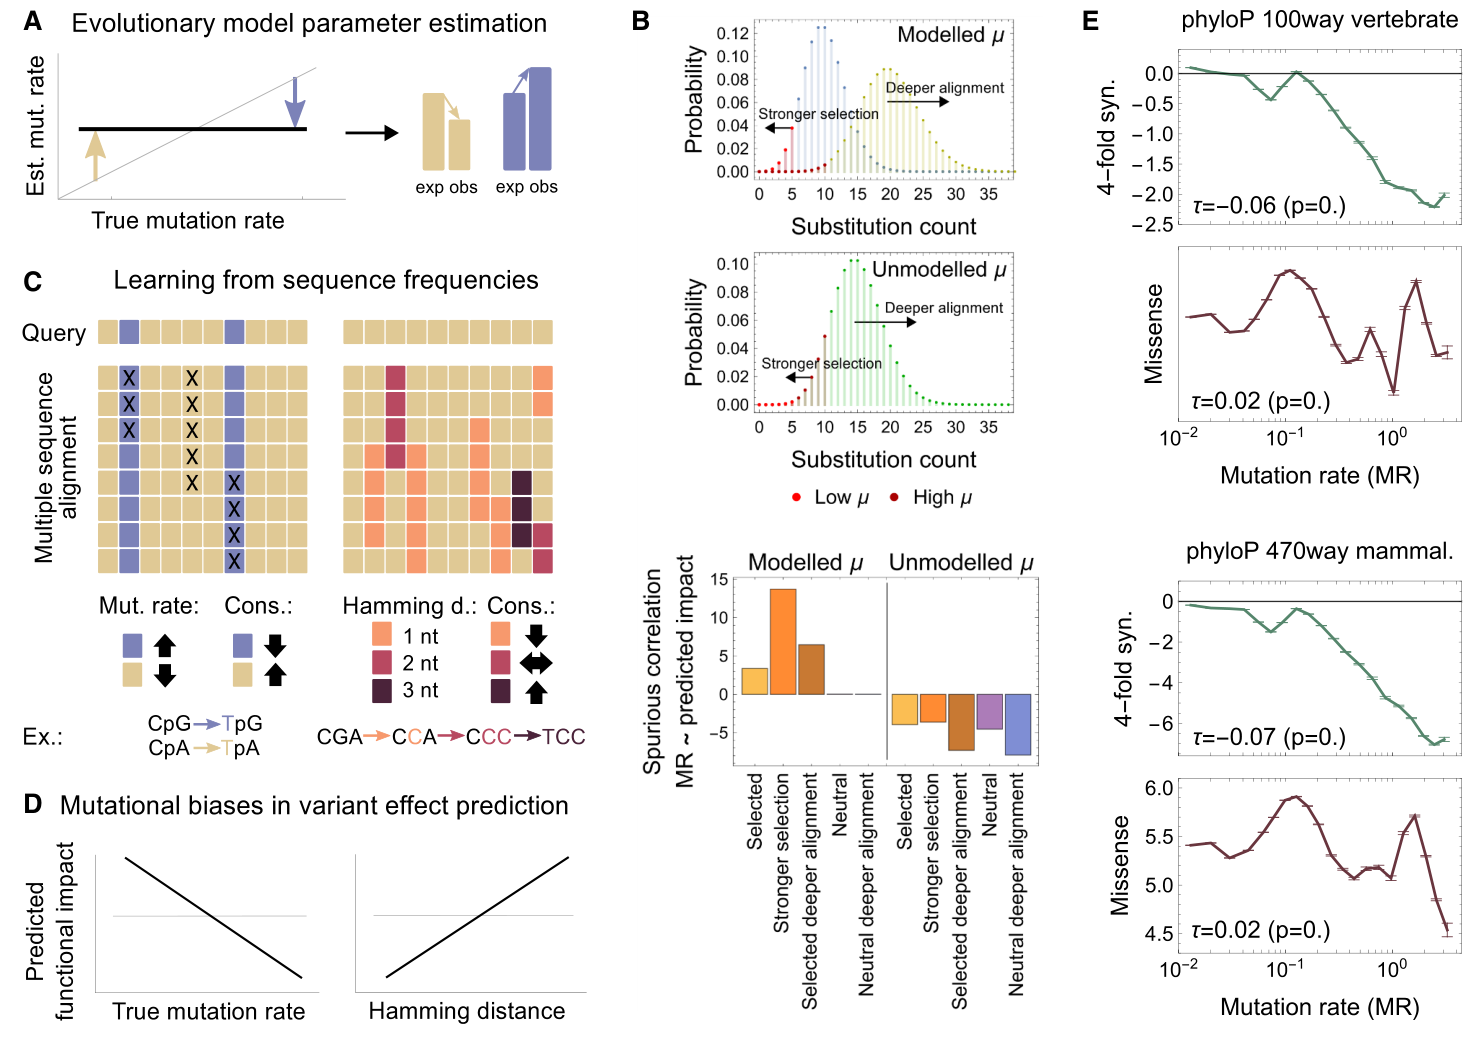
A–D 展示中性突变模型、序列频率与最小 Hamming distance 引入关联的机制;E 以四重简并同义替换作为近中性对照。忽略突变率异质性可造成负向偏差,而正确建模后的功效差异也可能产生正向关联。E 上半部原图标签为 phyloP 100-way vertebrate,英文原图注却写 17-way primate;此处按图内标签解读。原图完整保留 A–E 面板、图例及坐标轴。
Loay et al., The American Journal of Human Genetics (2026), Figure 1. © 2026 American Society of Human Genetics; published by Elsevier Inc. · All rights reserved · 原图未修改 · 原文图 · 放大突变率与 50 种分数实际比较了哪些变异
位点特异的当代人类生殖系突变率来自既有 Roulette 模型;本文没有重新从家系估计整套突变率。模型结合扩展五核苷酸背景与区域背景率,分析剔除标记为低质量的估计。独立敏感性分析使用 774,930 个 de novo 变异构建的三核苷酸平均突变率,以减少区域背景估计对结果的影响。
预测分数主要来自 dbNSFP 5.1a,另加入 EVE 和 pop-EVE;每个基因统一选 APPRIS 的第一个 principal transcript。主分析对象是人类参考基因组中单核苷酸替换能够产生的错义变异,并非 1,350 万名个体或 1,350 万个独立基因组位置。不同方法有约 4,014 万至 6,940 万条可用记录;公平比较限制到全部 50 种分数共同覆盖的 13,470,525 条变异记录、6,659 个基因。
作者统一分数方向,使较大数值表示更大预测影响,再计算与突变率的 Kendall’s 。82% 的分数呈负相关,AlphaMissense、EVE、pop-adjusted EVE、SIFT 属于负相关较明显的方法。需要保留多重检验口径:Figure 2A 明确列出 LIST-S2、phastCons470way mammalian、CADD phred 与 CADD raw 在 Bonferroni 校正后不显著,不能把正文的概括写成“全部 50 种均显著”。多数相关系数的绝对值不大,样本规模使很弱的关联也容易显著。
另一个分析扩展到不一定由单次核苷酸替换可达的氨基酸变化。Hamming distance 定义为编码参考与替代氨基酸的所有密码子组合中,最小的核苷酸差异数,取 1、2、3;并非某个变异实际经历的历史突变步数。AlphaMissense、ESM1v、EVE 等六组预测输出随这个距离增加而更倾向于给出高影响分数。
DMS 提示存在真实的突变缓冲,但效应很小
作者重分析 Beltran 等的蛋白结构域 DMS:先将实验片段精确匹配到 UniProt canonical 蛋白,再与选定转录本的错义注释对齐;移除序列不匹配、可匹配变异过少等结构域后,保留 416 个结构域。涉及 Roulette 的分析仅使用常染色体。实验读数表示稳定性相关影响,统一方向后,数值越大表示稳定性损失越大。
Figure 4A 的 134,863 条变异记录显示,稳定性损失与位点突变率仅有 ,。将区域突变率差异平均掉,改用三核苷酸 de novo 突变率后,Beltran 数据的 149,196 条记录得到 ,。图中的误差线是分箱均值的 SEM,不是单个变异效应的不确定区间。
独立的 Tsuboyama 稳定性数据经过单替换、密码子翻译和单核苷酸可达性检查后,在 Figure 4B 使用 51,202 条记录,得到 ,。这些结构域未能映射到统一的基因注释,所以只比较三核苷酸平均率,没有参加相同的位点特异 Roulette 或 dbNSFP 联合分析。三组结果支持“更容易发生的替换平均造成稍小的稳定性损失”,但不能把极小的秩相关写成强预测关系,也不能由此证明当代人类每个位点都经历了适应性的突变率调节。
Figure 4C 另用 522,366 条氨基酸替换记录,观察到最小 Hamming distance 越大,平均稳定性损失越大。这支持遗传密码对常见突变具有一定缓冲;单纯见到预测分数依赖突变率或距离,并不足以将全部关联判为算法偏差。
生物学预期本身也并非只有一种方向。作者讨论了 CpG→TpG 的正反向突变不对称:若一个易突变的状态在弱约束位置逐渐耗尽,仍保留该状态的位置可能反而偏向强约束,从而出现正关联。稳定性数据中的整体负关联不支持这种机制主导当前实验集合,但不能据此排除它在某些突变类别中的作用。
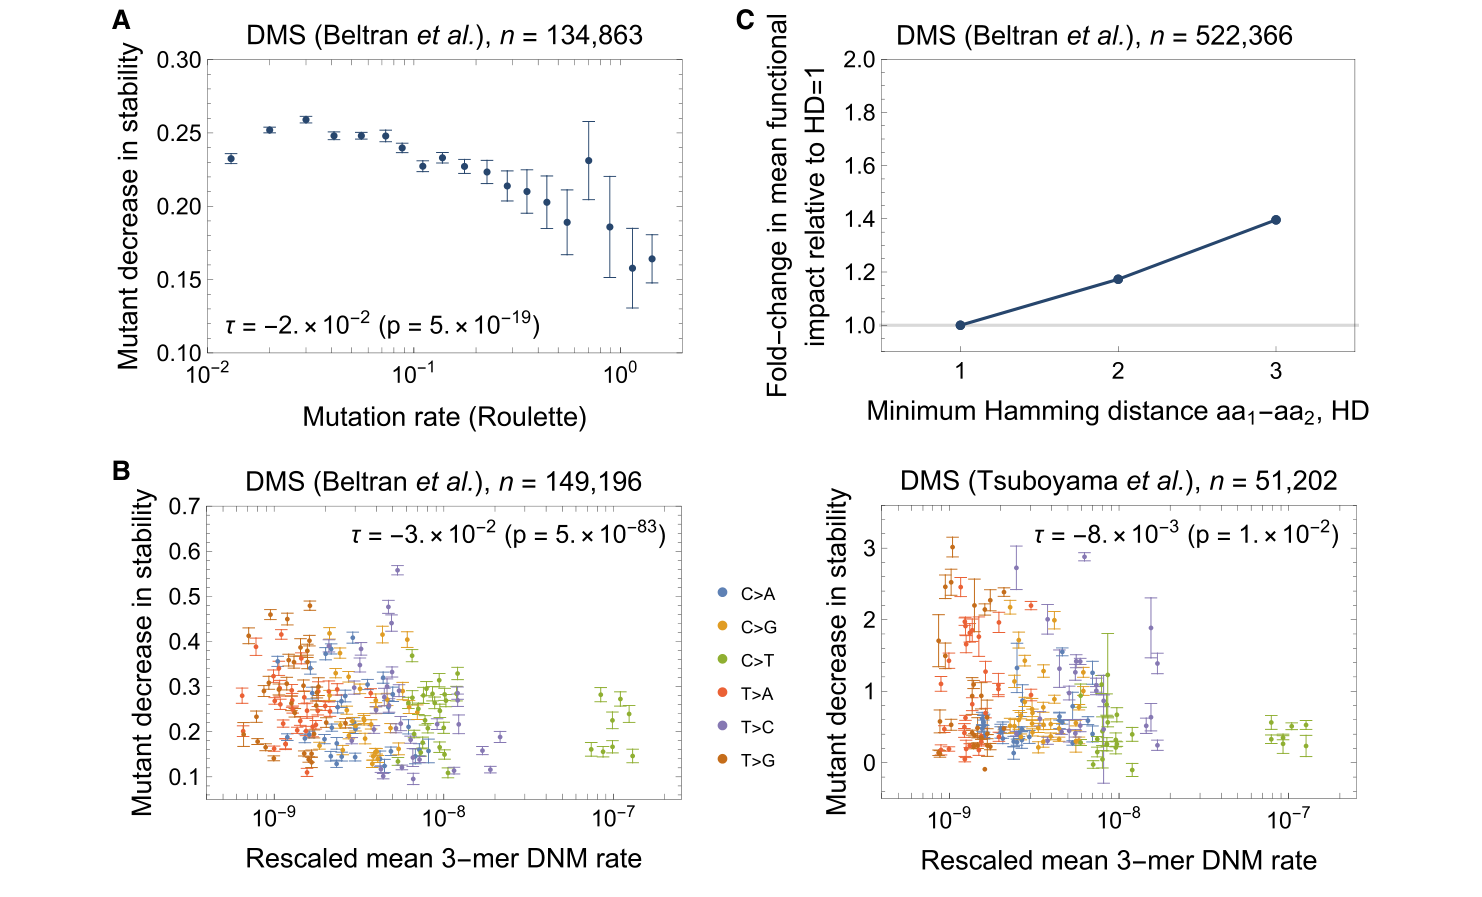
A 使用位点特异 Roulette 突变率;B 改用三核苷酸 de novo 平均率,并在独立的 Tsuboyama 稳定性数据中检验;C 比较不同最小 Hamming distance 的氨基酸替换。更容易产生的突变平均造成稍小的稳定性损失,但三组 Kendall 秩相关仅为 −0.02、−0.03 与 −0.008。各面板使用不同变异集合,样本数不可互换;误差线为分箱均值 SEM。原图完整保留 A–C、B 中两组数据、全部图例及坐标轴。
Loay et al., The American Journal of Human Genetics (2026), Figure 4. © 2026 American Society of Human Genetics; published by Elsevier Inc. · All rights reserved · 原图未修改 · 原文图 · 放大控制稳定性后,还剩下什么关联
作者使用基于秩的多元线性回归,可写为
其中 为预测分数、 为 DMS 影响、 为突变率,并用 HC3 标准误处理异方差。这里的“DMS 校正”是考察给定稳定性读数后的条件关联,并没有训练或推出一套新的、已校准的 VEP。
控制 DMS 后,25 种方法仍具有 Bonferroni 显著的负 ,18 种具有显著正系数。后者中 17 种直接使用核苷酸突变模型,或借用了采用此类模型的方法;所有序列频率类方法仍为负向。这与前述功效机制相容:在高度约束的实验结构域中,关联可能变弱甚至转正。结构域层面的补充分析中,45 种方法的 与独立基因约束指标正相关,其中 14 种经 FDR 校正显著。用最小 Hamming distance 替换突变率的回归,六组被检验的预测输出也都保留显著条件关联。
但 只能称为蛋白稳定性未解释的突变率关联。DMS 不覆盖催化活性、互作、剪接等所有致病机制;HC3 也只针对异方差,并不自动处理同一蛋白内多个变异的相关性。不能把残余系数直接解释成纯粹的预测误差或临床误分类概率。
此外,实验结构域本身较受约束,能同时获得全部 50 种分数的交集又是进一步筛选后的集合;主分析的 6,659 个基因、DMS 的 416 个结构域和最终比较的 121 个基因不能当成同一个样本。当前人类突变率也只是历史跨物种突变过程的代理。论文用三核苷酸平均率和独立 DMS 数据增强了证据,但尚未提供跨物种突变过程完全匹配的验证,或证明对每一类临床变异都能得到同样大小的偏差。
对功能注释与统计遗传学的启发
Figure 5 在 50 种方法共同覆盖的 29,399 条 DMS 变异上比较预测能力,并展示 121 个基因内的 Spearman 相关分布。总体相关约为 –,系统发育保守性指标相对较弱,蛋白语言模型与监督模型并没有清晰的整类优劣分界。一个分数存在突变率关联,不意味着它完全没有功能预测价值。
作者还对低/高突变率变异富集的基因做 GO 与 HPO 分析,提示 DNA 修复、纤毛、离子转运等功能组可能受到不均匀影响。这是“哪些基因更暴露于这种偏差”的分析,未直接测量这些疾病的临床误诊率。文中的 与 是所用 Roulette 数值尺度上的阈值,不能直接解释为每代 2% 或 100% 的突变概率。
对于把功能注释加入 SuSiE 先验,本文给出的启发是:应检查先验增益是否部分来自突变背景、序列约束与评价集组成,并通过独立数据考察可信集覆盖和概率校准。直接将注释对突变率残差化也不是本文已经验证的解决方案,因为这样可能同时去掉真实生物学信号。
本文评估的是以错义变异为核心的预测器,包含 AlphaMissense,未检验 AlphaGenome。不能据此断言调控序列模型受到同样大小或方向的偏差。进一步将 AlphaGenome 输出用于非编码 fine-mapping 时,可以把突变背景分层和实验效应对照作为研究设计,但这属于方法启发,而非论文已经完成的结论。