- 测序 / 测量方式
- 10x Chromium Next GEM 3′ v3.1(1,025,717 条)与 5′ v2(67,331 条);FACS/plate 的 SS2 为 41,501 条,SS3 标签为 1,669 条。SS3 在本研究卵巢样本中实际指 Smart-seq2.5 改良方案。约 2/3 器官经过细胞 compartment 富集;另有 9 个未经解离的整卵泡 bulk 表达谱,不能把全部板式记录机械视为单细胞。[1][12]
- 测序深度
- STAR Methods 明确:10x 在 Illumina NovaSeq 6000 S4 上测序,目标 50,000–75,000 reads/cell;SmartSeq 目标 1,000,000 reads/cell。均为设计深度,不能写成各文库实测均值。每器官通常两条 10x reactions、各加载约 7,000 cells,目标保留 10,000 个 QC-passed cells;也不是各组织实际达到的样本量。[1]
数据获取处理数据公开:Figshare 提供 28 个组织 H5AD(合计 57.14 GB / 53.21 GiB),CELLxGENE 提供 All Cells 及分组浏览/下载;GEO GSE306755 提供每细胞 CSV.gz 元数据等文件。只查看供体、组织、平台及注释分布时,可先下载约 42.46 MB 的元数据,无需整批下载表达矩阵。原始 reads 按官方流程签署 DTA;作者 paper2 目录提供分析代码。
数据构成与新增供体:完整图谱不是平衡的 24×28 设计展开收起
Tabula Sapiens 2.0 在第一版基础上新增 9 位供体与 4 种组织。新增供体中,TSP25、TSP27、TSP21、TSP26 分别贡献 20、18、15、2 种组织,其余五位各贡献一种。多器官配对使同一个体内的组织比较成为可能,但器官移植优先、供体病史和取材条件造成大量缺失组合。
计数单位需要区分:182 是完整元数据的精细细胞类型数,701 是细胞类型与组织来源的组合数。论文概述写 38 个大类,但完整 GEO broad_cell_class 实际有 40 类;10x 子集恰好是 175 个细类型、38 个大类。另两类 fat cell(39 条)和 follicle(9 条)只存在于板式数据,不能把完整数据与 TF 分析子集混为同一口径。
下列供体和组织计数来自作者 Figure 1 原始 CSV,并逐项核对 GEO 每细胞元数据。记录总数 1,136,218 与正文的 1,093,048 + 43,170 以及当前 CELLxGENE All Cells 一致;记录包含不同取材、富集和平台,不代表对人体细胞的等概率抽样。
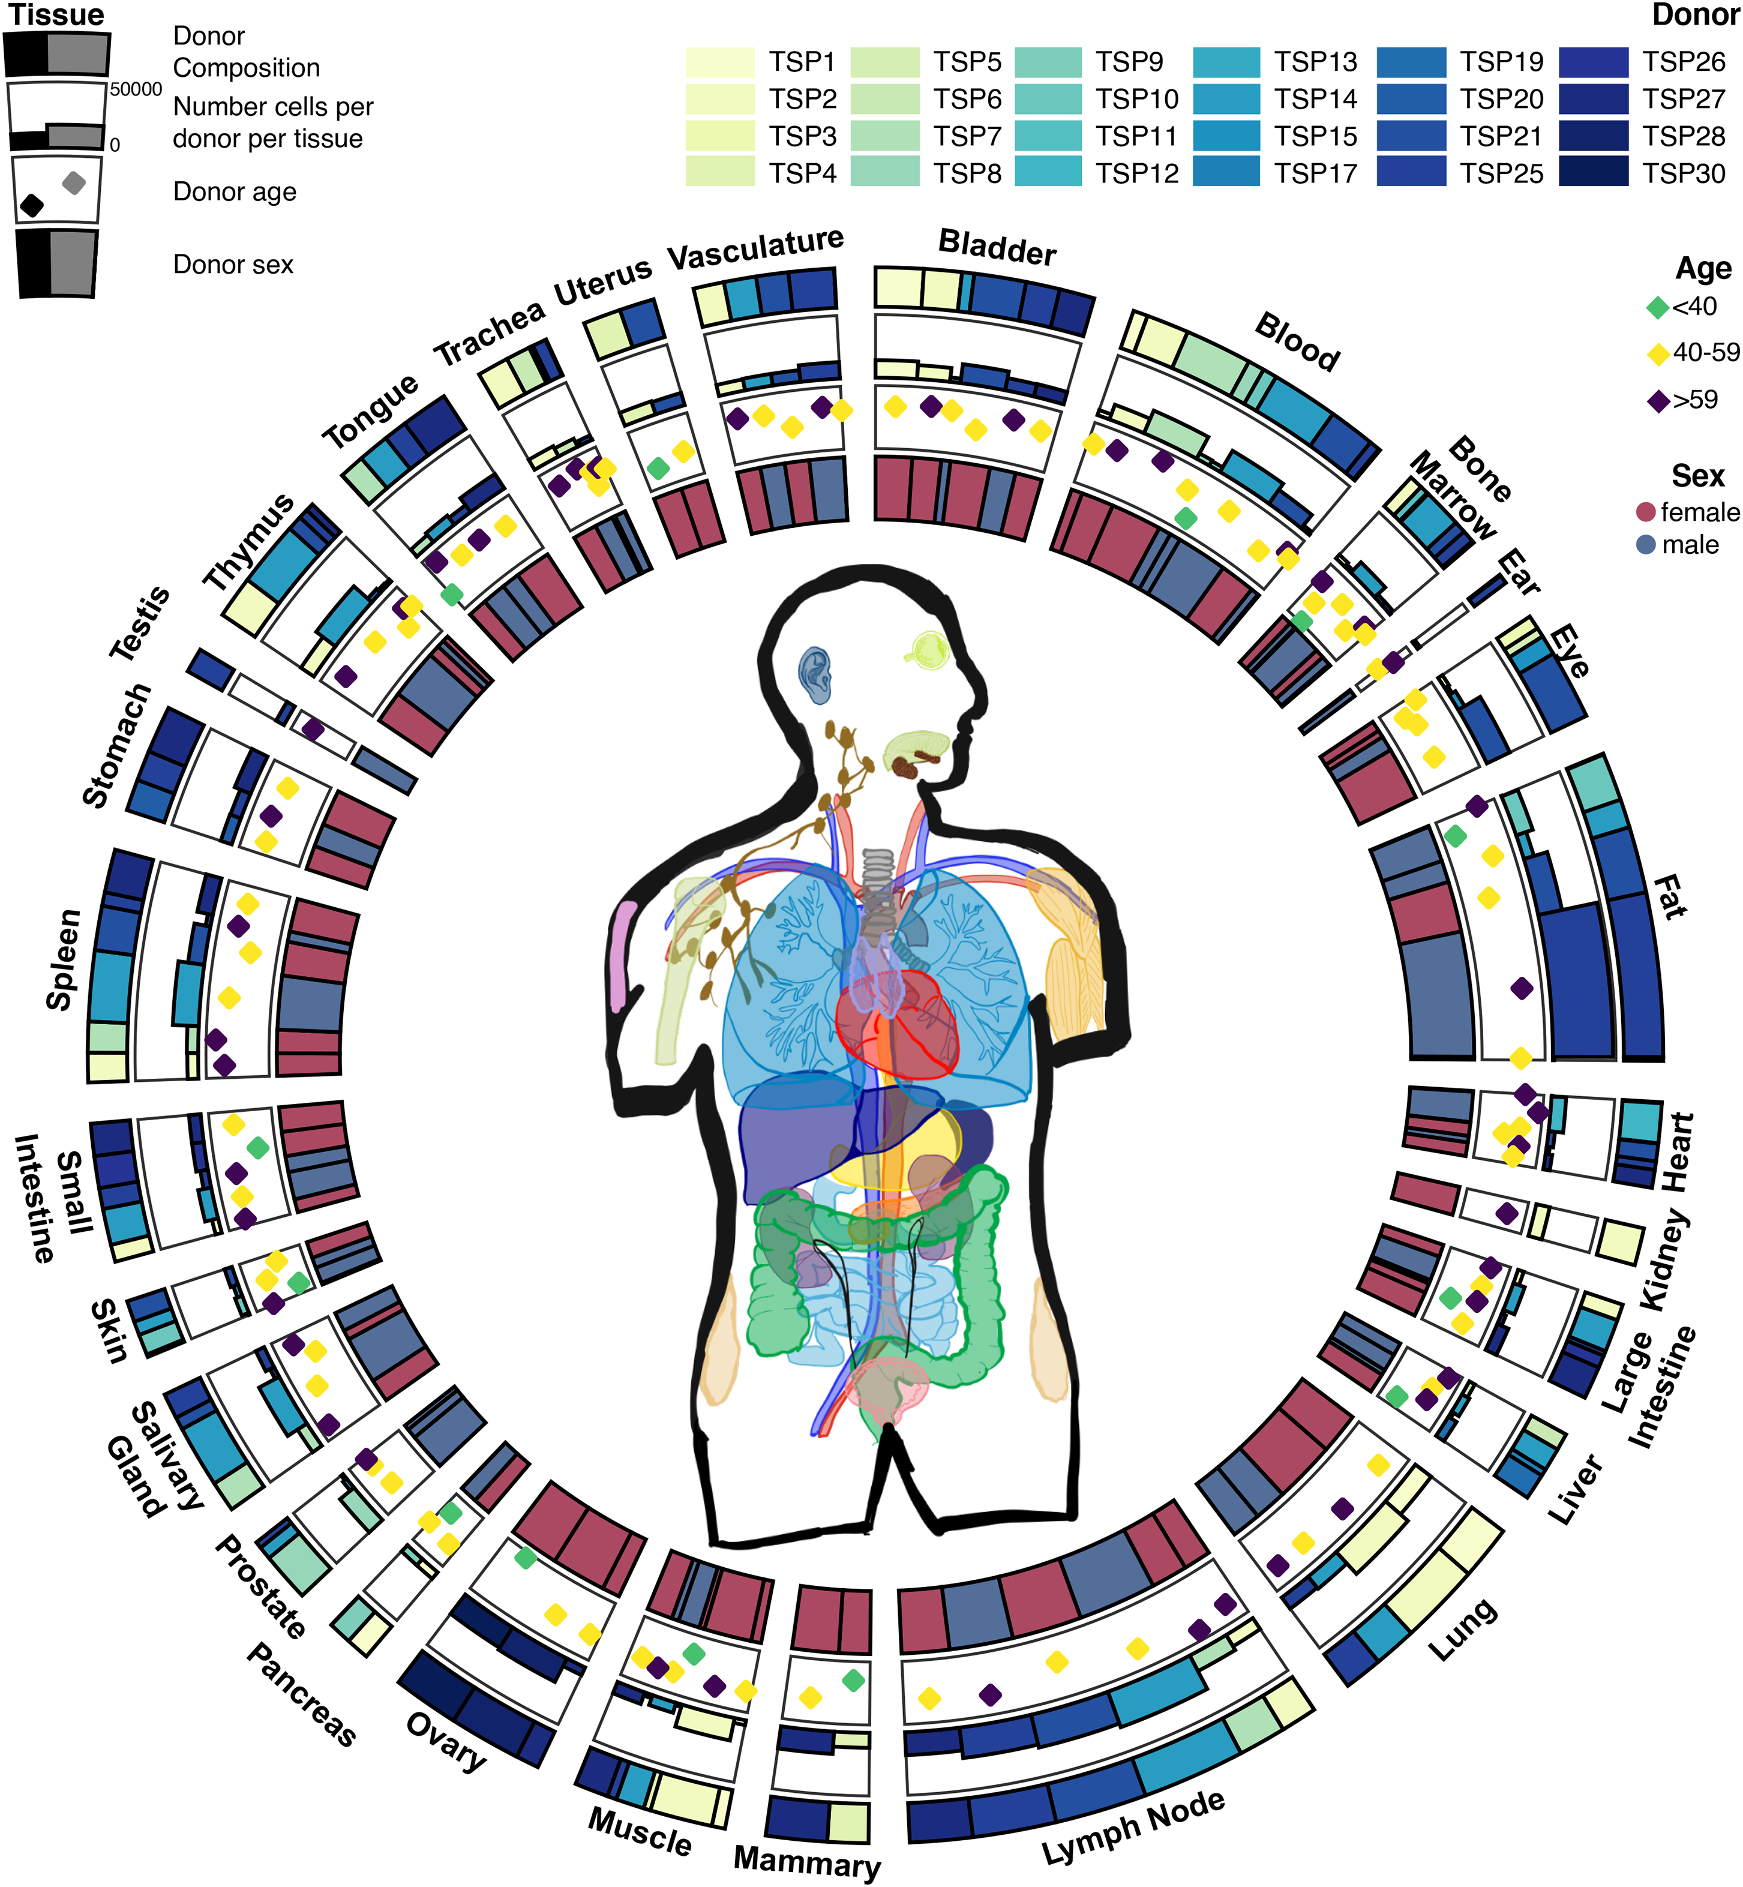 Figure 1|各组织的供体覆盖与细胞构成。不同组织的供体数和细胞数明显不均;图中捕获比例不能直接解释为原组织的细胞丰度。摘自正式论文 Figure 1,图像完整保留;© 2026 The Authors,CC BY 4.0;原始示意绘图 B. Tojo。 原论文 · 查看原图
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[5] CELLxGENE:完整图谱、组织与细胞群数据集合[11] Figure 1 供体×组织计数原表(固定版本)[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
全部 24 位供体:记录数、组织数与人口学元数据展开收起
以下“记录数”为该供体跨所有组织和平台的总和。均值 47,342.4 明显高于中位数 16,758.5,反映少数多器官供体贡献较大;TSP14、TSP25、TSP21、TSP2 共贡献 61.35% 的记录。单纯随机划分细胞进行训练/测试,会让这类供体同时大量出现在两侧。
人群列原样保留 GEO ethnicity 标签;它不表示遗传主成分或基因型推断祖源。ID 不连续且最大达到 TSP30,不等于有 30 位供体。
来源:[11] Figure 1 供体×组织计数原表(固定版本)[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
全部 28 种组织:实际供体覆盖决定可做的比较展开收起
供体数按每种组织存在至少一条记录计算,尚未施加某个细胞类型的最小细胞数阈值;开展细胞类型差异分析后,有效 N 还会下降。例如胰腺虽有 3 位供体,TSP27 仅贡献 41 条记录,不能把这三人的信息量看作相同。
作者 Figure 1 源表和 GEO 元数据均显示:肾脏仅 TSP2,睾丸仅 TSP25,乳腺为 2 位女性供体。正文概述中“非生殖组织男女均有覆盖”的笼统描述与这些具体数据不完全一致;这里保留可复核的计数,不据概述补出不存在的供体。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[11] Figure 1 供体×组织计数原表(固定版本)[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
取材、富集与测序:覆盖细胞类型,不是测量自然细胞比例展开收起
样本主要来自 Donor Network West 的成人器官与组织供体,经冰上运输,取材到初步处理尽量控制在 1 小时内。各组织由有相应经验的实验室解离为活细胞;作者明确承认没有供体是“完全健康”的,因此需要结合供体病史和组织来源选择参考样本。
约 2/3 器官用 MACS 等方法平衡 epithelial、endothelial、immune、stromal 四个 compartment,部分样本使用 FACS 富集。这样能增加稀有细胞类型的覆盖,却使下载矩阵中的细胞比例偏离原位比例;存活率和解离敏感性进一步影响捕获。
卵巢有两个特殊点:元数据 SS3 实际对应 Smart-seq2.5 改良建库,不能直接当标准 Smart-seq3;另外 9 个完整卵泡没有解离,代表整卵泡 bulk transcriptomes。对真正的单细胞方法做 benchmark 时需单独识别这些记录。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
比对、去污染与 QC:保留可复现的阈值展开收起
Plate 数据使用 GENCODE v41 / GRCh38 参考,采用 STAR/HTSeq;droplet 数据用 CellRanger,正文未独立注明其 10x reference 的具体版本。以下为正式 STAR Methods 的参数,不采用数据库样本页中可能沿用旧模板的处理描述。
DecontX 按每个 10x run 独立运行,使用完整背景与筛选细胞;之后重新施加非线粒体基因数和 counts 阈值。论文还处理 barcode swapping,并排除同供体不同样本中可疑的重叠 barcode。不要额外假设作者使用了未报告的统一线粒体比例阈值或某个双细胞检测软件。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制
整合与注释:保留组织差异,逐层核对标签展开收起
作者按器官分别使用 scVI(scvi-tools 0.20.0)整合 donor 和 technology:n_latent=50、n_layers=5、dropout_rate=0.1、dispersion="gene",训练设置为 50 iterations。整合潜空间用于 UMAP 和参考探索;作者特意不把 organ 当作要移除的 batch,以减少消除真实组织差异的风险。
注释结合组织专家、CELLxGENE、Cell Ontology 和 popV。早期供体上使用五折交叉验证检查标签可预测性,随后采用自动初注、专家检查与人工清理的迭代流程。Ontology 尚未覆盖的类型加入项目 provisional ontology。因此,参考标签是有来源和层级的注释结果,并非独立实验确认的无误真值。
公开 H5AD 包含基因计数、细胞元数据、基因元数据及降维表示。GEO 的 cell_ontology_class、cell_ontology_id、broad_cell_class、free_annotation 分别保留不同标签信息;manually_annotated 是注释来源字段,False 不能直接解释为“没有接受后续人工检查”。完整数据的 40 个 broad 字段值与正文概述的 38 必须按平台与标签映射核对。
进行差异表达或训练 count model 前,应检查所选 H5AD 的 .X、.raw 和 layers 实际存放的是原始计数、去污染结果还是标准化表达,不能把 scVI latent 或 UMAP 当表达矩阵,也不能因为做过整合就忽略供体相关性。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[9] 作者分析代码:paper2[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
转录因子结果:890 个特异表达 TF 是怎样得到的展开收起
为避免平台差异,作者只在 droplet 数据的 175 种细胞类型中计算每个 TF 的 log-normalized expression 均值,再按该 TF 在所有细胞类型中的最高均值归一化,使用 τ 衡量表达集中程度。τ 越接近 1,表达越集中于少数类型;0.85 是参照分布及其他图谱选择的操作阈值,不是显著性检验的 P 值阈值。
在 1,635 个可检出 TF 中,890 个满足 τ>0.85,其余 745 个为非特异表达。非特异并不等于所有细胞都表达或功能必需。Figure 2E 的内皮例子显示 HEY1、LHX6、FOXC2 分别呈现动脉、静脉/微静脉和淋巴内皮相关表达;LHX6 的潜在静脉作用属于待验证线索。
作者另用 pySCENIC 0.12.1 推断 regulon:进入相应数据库与预筛范围的 1,390 个 TF 中,839 个在至少一类细胞中获得 regulon 支持。它结合共表达与 motif 信息推断调控活性,不是直接测得 TF 结合或扰动效应;未获得 regulon 支持也不能据此判定 TF 没有活性。
对统计遗传学,可先用候选基因/TF 的表达特异性定位值得研究的细胞背景,再结合 QTL、fine-mapping、共定位及功能实验形成证据链。此图谱的表达信号本身不产生变异效应估计、PIP 或因果靶基因结论。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[9] 作者分析代码:paper2
衰老相关结果:定义、供体内对照与跨细胞类型异质性展开收起
作者将检测到 CDKN2A、未检测到 MKI67 转录本的群体定义为推定衰老细胞。排除某性别仅有单一供体的相应组织样本后,分析覆盖约 108 万条记录、21 位供体和 25 个组织,其中 48,114 条为 CDKN2A⁺ MKI67⁻,约占 4.4%,分布于 145 个细类型和 34 个大类。此分析子集不能用完整图谱 24 人作为分母。
衰老相关基因(SAG)先在同一 donor×tissue×cell type 内,比较推定衰老群与其余细胞:双侧 Wilcoxon/Mann–Whitney U,log₂FC>0.5、BH-adjusted P<0.001,且目标群至少 50% 细胞非零表达;再要求相应组织–细胞类别内至少 50% 供体支持,汇总得到 3,792 个 SAG。这里不是 donor-level pseudobulk GLM 或混合效应模型;平均表达的 pseudobulk 主要用于后续可视化。
结果支持明显的细胞背景依赖性:在出现稳健 SAG 的 30 个大类中,CDKN2B 上调覆盖约 60%(18/30),CXCL8 和 MIF 各约 16%(5/30),IL6、IL1B 未达到作者的稳健筛选条件。未通过筛选不等于这些基因在所有细胞中都不表达。
作者对 48,114×3,792 的 SAG 表达矩阵作 cNMF,在 K=10–50 间比较重建误差与稳定性,选择 K=34;随后用各因子的高权重基因作富集分析,并以 pre-ranked GSEA(FDR<0.05)呈现 17 条细胞类型相关通路。细胞黏附、液泡酸化、蛋白代谢和能量代谢的富集各有不同,不能概括为一个通用的衰老程序。
CDKN2A⁺ MKI67⁻ 是 RNA 操作定义,可能包含非衰老细胞并漏掉其他衰老程序;MKI67 未检出也可能受到测量灵敏度影响。作者没有据此验证不可逆细胞周期停滞。正式论文的两项主要应用是 TF 与衰老分析,不应将早期预印本中的独立性别差异分析直接照搬为正式版结果。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[9] 作者分析代码:paper2
下载哪一层数据:先元数据,再按任务选矩阵展开收起
如果只需要选择供体、核对组织覆盖、检查建库平台或统计注释分布,先用 GEO 的 CSV.gz 元数据即可。该文件共 1,136,218 行记录,压缩大小 42,461,568 bytes;包含 donor、tissue、age、sex、ethnicity、assay、细胞类型等字段。不要为了这些信息先下载几十 GB 的 H5AD。
Figshare 的 28 个组织 H5AD 合计 57,136,733,314 bytes,即 57.14 GB(十进制)/ 53.21 GiB。当前 CELLxGENE collection 有 35 个重叠对象:All Cells、28 个组织和 6 个 compartment;All Cells 为 1,136,218 条记录、60,606 个 features。不能把所有对象的细胞数相加。不同门户可能有不同再处理版本和字段规范,下载后先核对总数、annotation 与 assay。
GEO accession、Figshare v2、CELLxGENE All Cells 和 CZI benchmark 不是四个相互独立的队列。尤其 CZI benchmark 是为模型评估处理的新增 9 位供体子集,经过注释/基因/细胞筛选,输入覆盖 27 种组织,最终 26 种;不能把其数量替换成完整 24 人图谱的规模。
按当前 GEO metadata,新增九位供体 TSP17、TSP19、TSP20、TSP21、TSP25、TSP26、TSP27、TSP28、TSP30 合计 549,027 条记录;但 published_2022=False 有 692,102 条,且包含原先供体的记录。该字段不能直接等同于“新增九位供体”,实际留出评估应明确按 donor 筛选并再核对预训练语料。
来源:[4] Figshare v2:28 个组织 H5AD 文件[5] CELLxGENE:完整图谱、组织与细胞群数据集合[6] 官方数据访问政策与原始 reads 申请[7] CZI benchmark:新增供体子集及处理规则[8] GEO GSE306755:正式发表配套数据与元数据[9] 作者分析代码:paper2[10] AWS Open Data:原始测序、比对及参考文件[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)[13] ChatTS:供体临床史辅助查询工具代码
适合的分析问题与必要的设计边界展开收起
下表是根据资源设计给出的使用建议。分析时需要同时考虑供体数、每供体细胞数、组织覆盖、测量平台和参考标签来源;scVI 整合不能替代对这些层次的建模。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[7] CZI benchmark:新增供体子集及处理规则[11] Figure 1 供体×组织计数原表(固定版本)[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)
版本、时间与可复核口径展开收起
正式论文在线发表与数据首次公开是不同事件。PDF 的页脚印有 2026-10-29 的期刊排期,而 PubMed 记录的在线日期为 2026-09-02;二者不应相互替换。
这里的方法和生物学结果依据正式 Cell PDF 正文及 STAR Methods;供体、组织、平台和人群字段依据作者 Figure 1 计数文件与 GEO 实际元数据。论文分析层级与下载文件原始标签不一致时,应保留两种口径并核对映射,不凭标签字符串数推断新的细胞分类。
来源:[1] Cell 正式论文与 STAR Methods:图谱、实验、分析及限制[2] PubMed:正式论文在线发表日期[4] Figshare v2:28 个组织 H5AD 文件[5] CELLxGENE:完整图谱、组织与细胞群数据集合[8] GEO GSE306755:正式发表配套数据与元数据[11] Figure 1 供体×组织计数原表(固定版本)[12] GEO 每细胞元数据 CSV.gz(20241112 文件版本)