GLORB:全局表达偏移下的尺度识别与贝叶斯差异分析
GLORB: Robust Bayesian inference for differential expression under global expression shifts
GLORB 用两种负二项贝叶斯 GLM 处理大量基因同向变化:分别依靠稳定基因锚定样本尺度,或假设技术尺度跨组可交换。ERCC 数据支持其恢复整体差异,但识别、后验校准与当前实现均有明确边界。
本文目录
全文解读|bioRxiv v1,2026-09-03 公开,尚未经同行评议。 本次阅读覆盖上传 PDF 全部 37 页,包括正文、Methods、Figure 1–4 与 Supplementary Figure S1–S7;另外核对作者当前代码,并与论文参数化区分。分析代码
GLORB 值得读的核心是如何把生物学整体变化与测序技术尺度分开。它提出两种负二项贝叶斯 GLM,并通过不同假设来定位这个尺度。带 ERCC 的真实数据提供了有说服力的应用证据;但“无需 spike-in”有明确条件,不能理解为计数矩阵已经足以恢复任意实验的每细胞绝对 RNA 含量。
两种模型分别把技术变化放在哪里
设 为样本 的基因 计数, 是 设计矩阵。两模型共享
使用自然对数尺度;两组比较时除以 才是 log2 fold change。这里的 是生物样本数,论文展示的是 bulk RNA-seq 和 ATAC-seq 分析,并未建立供者内细胞相关结构。
Size-factor 模型保留样本尺度 :
它同时估计尺度、系数与过度离散度,系数采用连续 spike-and-slab 式先验: 来自零中心的窄、宽两个正态组分,,。窄组分把一部分基因约束在效应接近零处;宽组分允许较大变化。、 和基线表达均采用 log-normal 先验。Table 1 给出的宽组分尺度为 ;窄组分的数值存在文内不一致:表格写 ,正文却写 。核对作者当前代码后,0.05 实际作为标准差,与表格一致。由于 spike 是连续正态,组分归属不能直接当作“效应严格等于零”的后验概率。
Non-size-factor 模型移除均值中的 ,给每个样本一个额外离散度:
论文以 的半正态先验限制它只能增加离散度。系数采用作者称为 modified regularised-horseshoe 的收缩先验:协变量尺度 、局部尺度 与一个依赖基线表达的 sigmoid 因子共同控制收缩,低表达基因受到更强约束,避免少量计数造成巨大 LFC。正文给出这些尺度的超参数,但未完整列出 、 的分布层级。
以上按论文的“过度离散度”定义解释。当前作者代码直接把名为 alpha 的量传入 NumPyro NegativeBinomial2 的 concentration 参数,而后者的方差是 ;non-SF 样本因子增大该参数时,会减小条件方差。它与文中的增大方差解释尚未对齐,复现需要先核清参数化;这里没有据当前代码重新计算论文图表。作者模型实现 · NumPyro 0.20.0 分布定义
不使用 spike-in,依然需要尺度锚点
MoR 和 TMM 并非仅因“DE 基因超过一半”就必然失效。更准确地说,MoR 依赖真实 log ratio 的中位数接近零,TMM 依赖修剪后保留的加权变化相互平衡。大量变化若上下调平衡,条件仍可能近似成立;大比例同向变化则容易被吸收到归一化因子中。
SF 模型把锚点换成一个可辨认的稳定基因群。作者建议仍有超过 20% 基因不变的情形,但未证明这个比例本身足以保证识别。由模型可以直接看出,对任意协变量向量 ,同时令
计数均值完全不变。因此,分离全局效应与技术尺度依靠稳定基因、先验以及初始化共同确定参照。稳定基因若太少,或技术效应与生物组别重合,数据本身并不提供唯一答案。
Non-SF 模型使用更直接的条件:技术尺度跨组同分布,并且与设计矩阵中的生物条件独立。随机交错处理病例和对照有助于满足条件,足够样本也有助于平均掉随机技术差异。它并非用方差参数精确重建每个样本的乘性均值偏移;共享深度本来还会造成跨基因相关,而模型的条件独立计数结构没有显式表达该相关性。因此,将技术变化转入过度离散度是一种替代建模假设,不能称为原 SF 模型的等价改写。
这个区别可以从模型直接推导:假设共同尺度 已标准化到 ,,边际方差为
对于不同基因,还会有 。这与单纯将样本和基因离散度相乘、同时保持计数独立有所区别。以上是对生成模型的推导,用来说明假设边界,并非作者证明该近似始终失效。
还有一个实验设计上的推论:如果等量 RNA 投入、混样或测序预算已经消除了每细胞总量的信息,模型不能凭空恢复这个尺度。使用 GLORB 前,应先明确目标是每个细胞、单位组织、血浆体积还是相对 RNA 组成的变化。
变分推断与“95% 概率”的实际含义
作者用 NumPyro 的 AutoNormal 做 mean-field SVI;全部实验使用全批次,优化 3,000 步,初始学习率 0.01,并做学习率衰减与梯度裁剪。离散组分变量以温度 0.3 的 RelaxedBernoulli 近似。SF 的初始值来自 log ratio 直方图的众数,使用 151 个 bin,并排除边缘及零中心 bin,以减少稀疏计数中大量精确比值的干扰。
论文按 选择效应,即要求后验支持至少两倍的表达差异。这里的 95% 是单基因的后验效应判定;它与 BH 调整后 的 FDR 规则不等价。更高 AUROC、较高 specificity,或 ROC 上 99% specificity 对应的 sensitivity,都不能直接证明最终发现集的频率学 FDR 已控制在 5%。作者也承认 mean-field 近似会低估不确定性,极小尾概率尤其难以校准。
当前实现还存在一个需要区分的概率口径。对自然对数效应的近似后验 ,代码的 plesser 使用 ,其中两倍变化对应 ;严格的区间概率 则还应减去 。所以按 plesser 筛选实际对应沿后验均值方向的单侧尾部规则,与正文写出的绝对值事件并不完全相同。这是核对当前实现得到的差异,尚未重跑论文结果,不能据此判断已发表图中数值改变多少。代码位置
优化稳定性同样值得检查。Figure S4 在同一模拟数据上运行五次 non-SF 推断,AUROC 为 0.7710、0.7508、0.6615、0.6753、0.6632;误差也随运行变化。损失曲线下降并不保证恢复效果一致。较低的最终变分损失在该例中甚至没有对应更准确的结果。
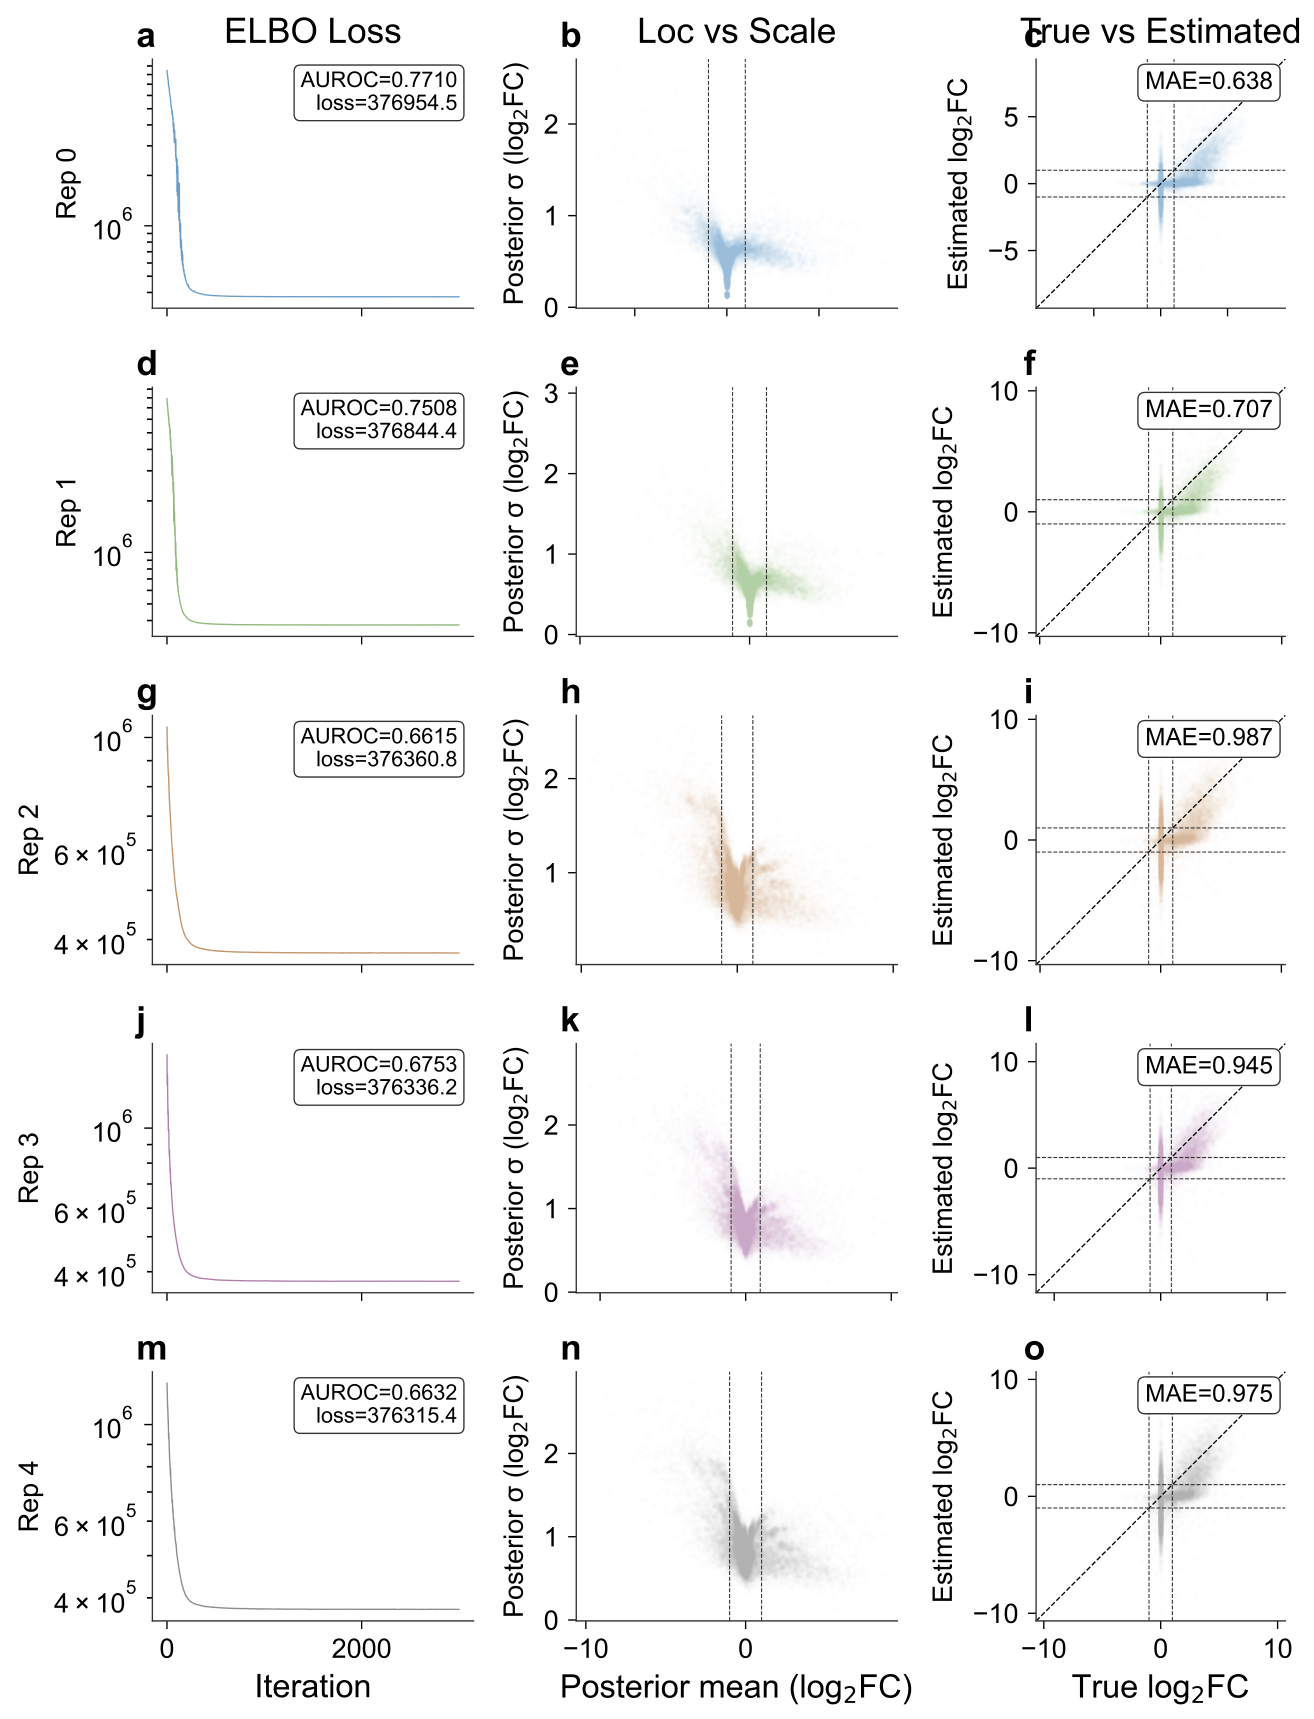
Supplementary Figure S4|non-SF 模型对优化随机种子的敏感性。同一模拟数据重复推断五次,各行展示负 ELBO 损失、后验均值与标准差,以及真实和估计 log2FC 的比较。五次 AUROC 为 0.7710、0.7508、0.6615、0.6753、0.6632,说明曲线下降及较小最终损失不足以保证相同恢复质量。第一排 C 标签与标题的轻微重叠来自原图。
Callahan, Coleman and Ngo, bioRxiv (2026), doi:10.64898/2026.08.28.747928 · CC BY 4.0 International · 原图未修改 · 原文图 · 放大仿真支持什么结论
仿真使用 20,000 个基因,每组 3、5、10、25、50 或 100 个样本,DE 比例为 30%、45%、55%、75%、99%。被选中的基因自然对数效应来自 ,因而以同向上调为主,并非每个选中基因都上调。基础场景让两组 size factor 均来自同一 log-normal 分布;每个设置生成 10 份数据,各做 5 次推断,主要方法比较只使用第一次推断。
在这类组间技术尺度可交换的场景,non-SF 模型通常能避免全局信号被中心化,特别是在较大样本下;Figure 4a 和 S1–S2 支持这种相对优势。小样本的高 specificity 则应连同较低 sensitivity 阅读。SF 并非所有场景都优于传统方法。作者也纳入未做 CPM 归一化的 t 检验和 Mann–Whitney 基线,部分情形 specificity 很高,说明“保留整体尺度”本身是方法差异的重要来源。
另一组实验让病例技术尺度分布是对照的约 0.5、1.5 或 2 倍。Figure S6 显示 non-SF 在部分设置仍保留正负方向的系统偏差;S7 的 specificity 看起来较高,也不能据此说技术偏差已经消除。这个实验更适合用来界定适用条件。
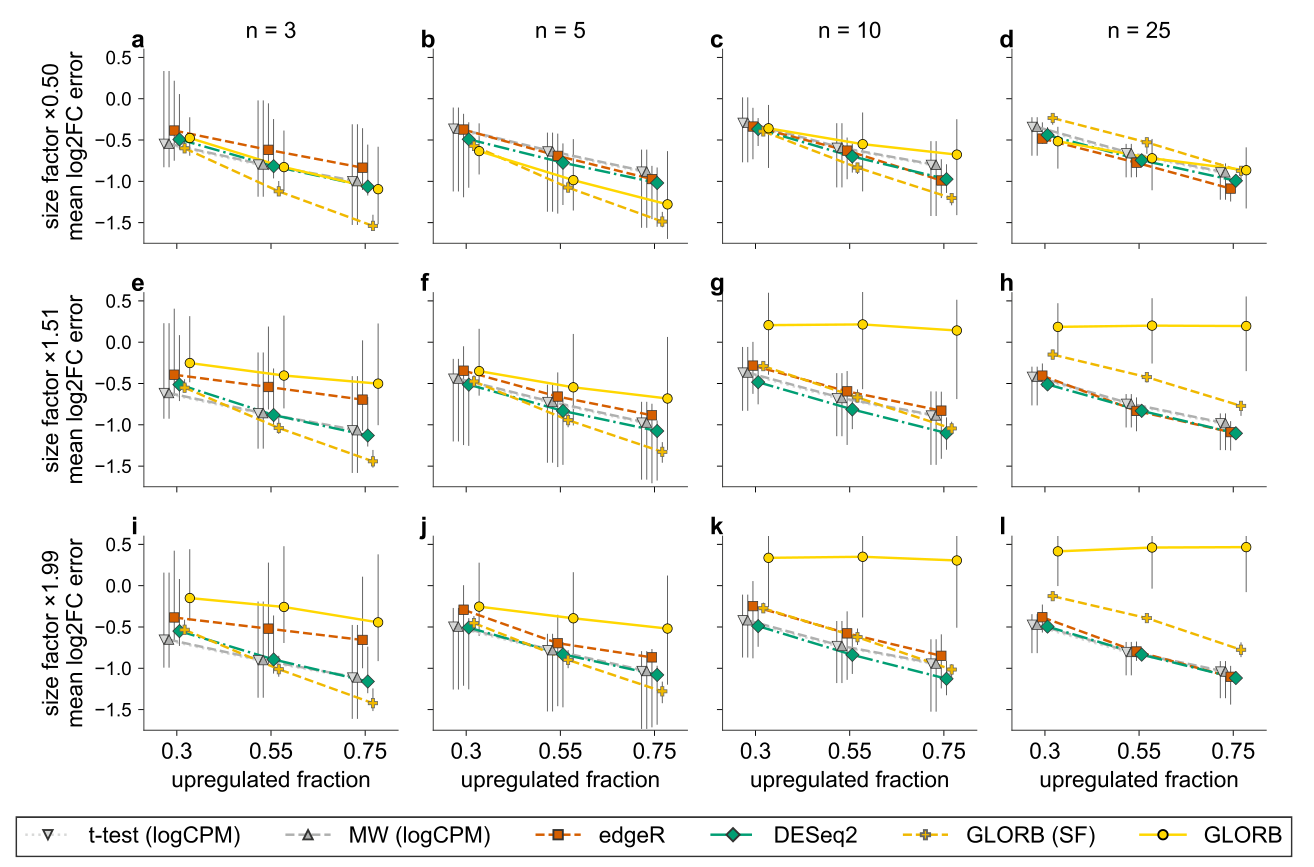
Supplementary Figure S6|技术尺度跨组不一致时的效应偏差。行表示病例 size-factor 分布相对对照约 0.5、1.5、2 倍,列为每组 3、5、10、25 个样本;纵轴是平均 log2FC 误差,点为不同模拟数据的中位数,竖线表示范围,每份数据仅使用第一次推断。non-SF 在部分设置仍有方向性偏差,支持将技术可交换性作为适用前提。
Callahan, Coleman and Ngo, bioRxiv (2026), doi:10.64898/2026.08.28.747928 · CC BY 4.0 International · 原图未修改 · 原文图 · 放大ERCC 是更有信息量的验证,TCGA 是条件依赖的应用
最直接的参照来自 GSE205301 血浆分级 RNA 数据。Figure 2 标示 EV 组有 56 份测量、蛋白组分有 112 份测量;正文没有明确说明这些测量对应多少独立供者及是否存在重复分级,因此不能改写为 168 名独立受试者。该实验添加 ERCC,分析时先排除 ERCC,再将以 ERCC 估计尺度的 DESeq2 作为参照。
常规 DESeq2 相对 ERCC 参照的平均 log2FC 偏移是 −5.47;non-SF GLORB 的偏移为 +0.22。ERCC 参照、GLORB、常规 DESeq2 分别检出 12,470、12,432、47 个 EV 上调基因,而常规 DESeq2 检出 7,508 个下调基因。这确实支持其在该实验中保留整体表达差异,但仍不等于所有实验设计的绝对尺度都能正确恢复。
TCGA-LIHC 分析包含 371 份肿瘤和 50 份邻近正常样本。GLORB 的 log2FC 中位数为 +1.02,DESeq2 为 +0.48;两者分别检出 20,701 和 9,703 个上调基因,下调为 1,201 和 1,946。正文曾将前两个数字称为全部 DE,这里按 Figure 4f 的方向标注报告。TCGA 没有该研究的 ERCC 参照,多发现上调基因不能独立验证新增发现为真,也不能排除样本组成和技术处理差异。
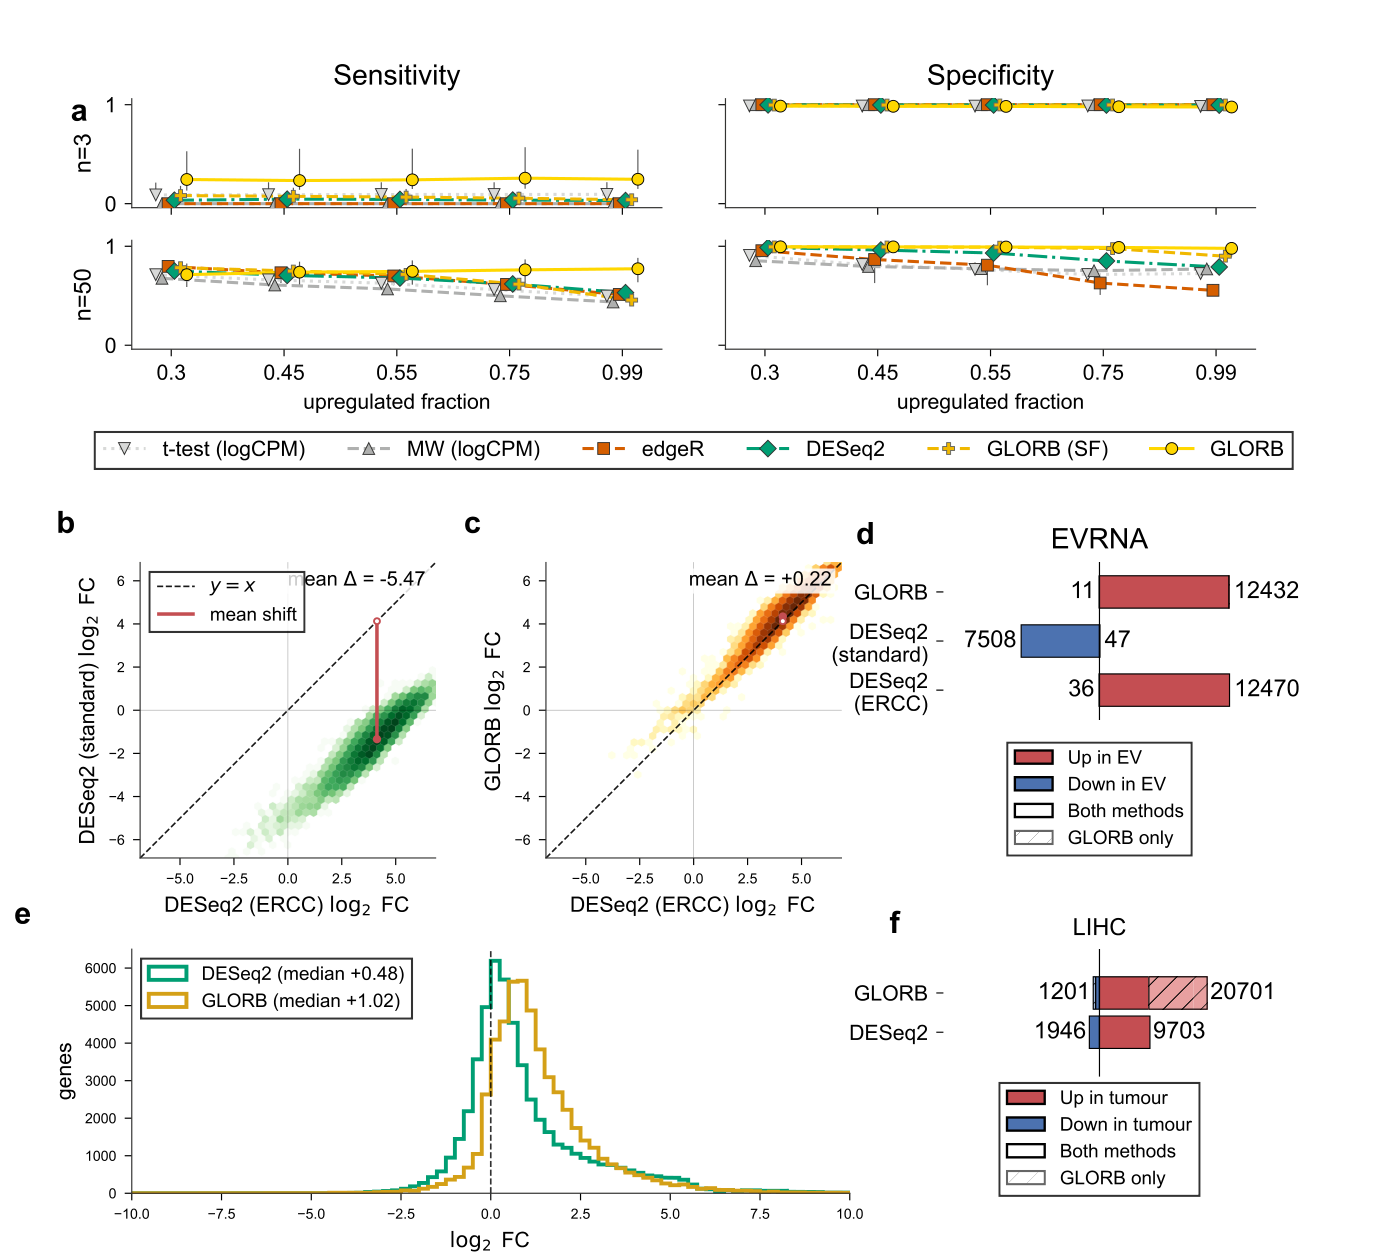
Figure 4|仿真与真实数据验证。A 比较每组 3 或 50 个样本、不同 DE 比例下的灵敏度和特异度;B–D 以血浆 RNA 的 ERCC 归一化为参照,比较常规 DESeq2 与 non-SF GLORB 的 LFC 和上下调发现数;E–F 比较 LIHC 的效应分布及方向性发现数。ERCC 结果提供外部尺度参照,LIHC 的更多上调发现本身不构成真值验证。图中的 20,701 与 9,703 是上调基因数。
Callahan, Coleman and Ngo, bioRxiv (2026), doi:10.64898/2026.08.28.747928 · CC BY 4.0 International · 原图未修改 · 原文图 · 放大作者还比较 GSE74912 造血分化 ATAC-seq 的 17 类样本,展示 MoR size factor 的组间差异。这是全局可及性变化的线索;组间 size factor 检验只有在技术尺度可交换的前提下才具有该解释,不能当作已验证的 ATAC 差异可及性性能基准。
对单细胞方法工作的价值与边界
GLORB 提供了一个值得实验比较的假设替换:利用稳定基因锚定尺度,或依靠组间技术可交换性保留整体变化。它适合作为有外部尺度参照的 bulk/pseudobulk 敏感性分析候选。若用于单细胞数据,仍需补充供者相关性、细胞数与总 RNA 的关系以及组成变化处理。
设计矩阵在数学上允许多个协变量,并不等于现有软件已完整支持全部场景。作者当前 README 明确提示 的初始化尚未完整实现,因此年龄、批次、处理条件及交互项同时入模前,需要先确认这一限制是否影响拟议设计。对有批次混杂的研究,不能只因为公式中出现 就默认已经解决了混杂或重复测量问题。
摘要称其更能处理稀疏数据,合理基础是拟合不依赖标准 MoR 的逐基因几何均值;但本文没有独立的稀疏度扫描、零比例分层校准或大规模单细胞性能验证。DESeq2 对稀疏数据也使用了 poscounts,不能把比较描述为只能处理无零矩阵的 DESeq2。
论文未报告 GPU 硬件、运行时间、内存或 CPU/GPU 加速比。NumPyro 实现与未来扩展至单细胞的讨论具有计算上的兴趣,但正文提出的 10–100 倍尺度扩展是设想。正式使用时最应补做的验证是有 ERCC/已知稳定基因的尺度恢复、组间批次偏差、后验区间与发现集校准,以及多次初始化结果一致性。