GSR:固定基因收录频率后重新评估通路富集
Modeling pathway overlap increases accuracy of GWAS gene set enrichment
GSR 交换基因—通路连接,固定每个基因的收录频率及每条通路大小,为原始 GWAS 富集结果构造经验参照并重排优先级。12 个性状、4 种基础方法的比较显示,随机通路零模型会显著影响名义显著率;调整后与疾病关联资源的一致性多有改善,但不构成正式错误率控制。
本文目录
全文解读|medRxiv v1,2026-09-07 公开,尚未同行评议。 本文依据所读的 25 页全文,包括 Methods 和主图 1–6;文末列出的 6 个独立补充文件未附在 PDF 中,相关精确结果及实施细节尚未独立核查。
通路重叠与富集证据
GWAS 通路富集通常问:一组基因的关联强度是否高于基因组背景?困难在于,某些基因被反复收录进许多通路;如果这些高频基因本身富集遗传信号,许多不同名称的通路都可能受益。GSR 进一步问:固定每个基因的关联证据及其被收录次数以后,真实的基因组合是否比随机组合更突出? 它改变通路统计量的参照分布,随后重排结果,并不重新估计 GWAS 效应。
交换算法固定哪些量
令 表示基因 是否属于通路 。算法随机选择两个已有的基因—通路连接,交换其通路归属;产生重复成员的交换不被接受。由此保留每个基因的行和 、每条通路的列和 ,以及全部基因的身份和基因—性状关联。
这可表述为:在给定两组边际计数后,基因与通路的连接可交换。需要精确区分,每对通路共享哪些基因、共享多少基因并不固定。行和固定意味着总的两两共享计数 固定,但不能据此说原始 overlap 矩阵不变。每条通路原有的基因共表达、物理相邻关系、功能凝聚性也不会被保留。
实现采用 BiRewire v3.30,按引用文献的交换步数下界生成 1,000 个随机通路数据库;比较零模型 PS 只保持通路大小。GSR 的逻辑不是把高频基因删除或降低其关联分数,而是让它们在随机参照中也保持同样高的收录频率。若基因频率体现真实多功能性,这部分真实生物学也被条件化掉了,因此调整前后回答的问题不同。
数据与四种基础分析
MSigDB v2023 C2 的 Reactome、KEGG、BioCarta、WikiPathways 和 PID 通路,筛选常染色体蛋白编码基因及 10–2,000 个基因的通路后,共有 16,605 个基因、5,878 条通路;通路大小中位数 37。2,588 个基因出现在超过 50 条通路,591 个出现在超过 100 条通路。后续分层 LDSC 的“多通路基因”另定义为收录次数至少达到第 90 百分位,并非上述两个描述性阈值。
12 个性状包括 BMI、CAD、T2D、MDD、AD、SCZ、IBD、乳腺癌,以及 UKB 的 HDL、平均血小板体积、碱性磷酸酶和嗜酸性粒细胞比例。作者称外部 GWAS 使用不含 UKB 的欧洲祖源结果;UKB 质控后总体为 387,235 人、542,312 个 SNP,4 个实验室性状采用 70% 发现集、30% PRSet 目标集。这不是每个性状的有效样本量,各性状缺失与病例数需未附补充表核查。
| 基础方法 | 本文实际使用的统计量与设置 |
|---|---|
| MAGMA v1.10 | SNP-wise mean 基因统计量;基因关联强度对通路成员身份及默认基因层协变量进行竞争性回归。 |
| PascalX | SOCS 基因统计量、chi-squared 通路统计量;邻近相关基因采用 fusion gene 处理。图中简称 Pascal。 |
| PRSet | 通路内 clumping-and-thresholding PRS,GWAS 阈值为 1,在 UKB 目标样本检验关联;原始竞争性检验另作 1,000 次置换。 |
| GSA-MiXeR | 比较 full 与 baseline 模型的通路 SNP 遗传力,输出 fold enrichment,不提供正式通路 p 值。 |
SNP—基因映射使用 ±35 kb。PRSet 要求目标样本超过 2,000 人,二分类性状要求超过 2,000 病例,故排除 AD、IBD、SCZ,只评估 9 个性状。因此“四种方法 × 十二性状”不是完整的 48 格实验;PRSet 也仍然需要个体水平目标数据。
原始检验在不同随机通路下的表现
对每条通路,作者计算其 1,000 个随机版本中原方法 的比例,再观察这一比例在通路之间的分布。Figure 2 检查的是原方法在指定随机通路零模型下的名义显著率,并非 GSR 调整后经验 p 值的校准。 原始基因关联被保留,因此也不是无遗传效应的表型置换实验。
在 GSR 随机通路下,各性状的平均 FPR 范围为 MAGMA 0.0279–0.0836、Pascal 0.0474–0.144、PRSet 0.0452–0.414。平均 FPR 超过 0.10 的性状—方法组合有 10 个,PS 下有 5 个;PS 下明显膨胀主要见于 PRSet。GSA-MiXeR 没有正式 p 值,未纳入此项 FPR 比较。
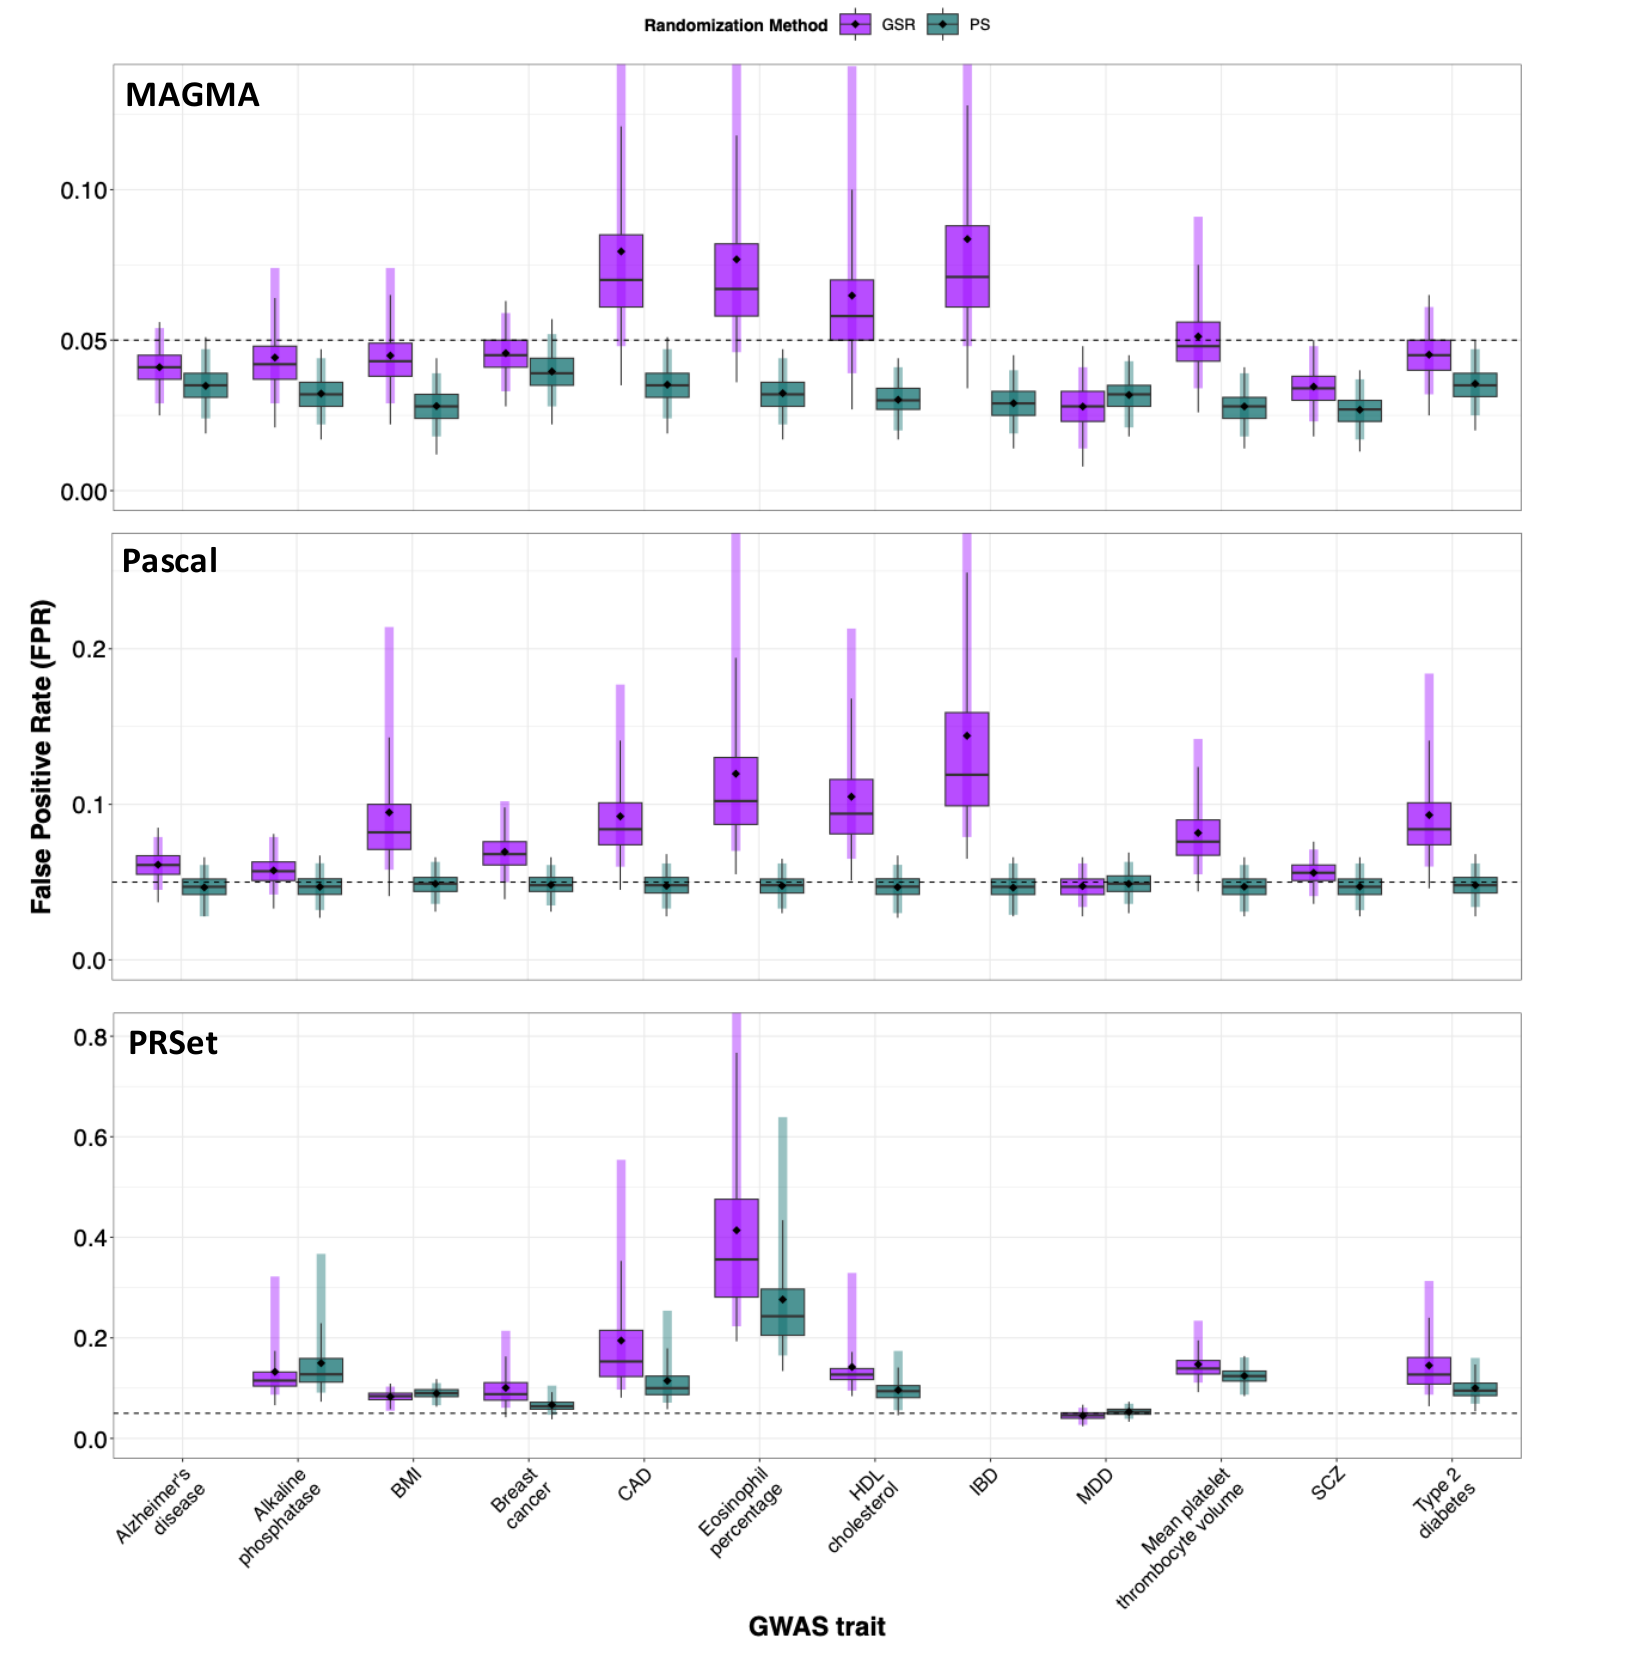
MAGMA、Pascal 和 PRSet 在保留基因频率与通路大小的 GSR 随机通路(紫)及仅保留大小的 PS 随机通路(绿)下,原方法名义 p<0.05 比例在通路间的分布。每条通路作 1,000 次随机化,菱形为跨通路均值,横虚线为 0.05,彩色竖线为通路 FPR 分布的 2.5%–97.5% 范围;部分范围在源图中超出纵轴显示上限。PRSet 不包含 AD、IBD、SCZ。此图不是 GSR 经验 p 值的校准检验。
Alanna C. Cote, Reagan Kesting, Judit García-González and Paul F. O’Reilly, medRxiv (2026), 原图未修改 · CC BY 4.0 · 原图未修改 · 原文图 · 放大Figure 4 显示,大通路在 GSR 下更容易被原方法判显著;这种大小梯度在 CAD、HDL 等性状尤其明显。Figure 5 则把通路 FPR 中位数与高频基因捕获的遗传力占比比较:MAGMA、Pascal、PRSet 的图示相关分别为 、、。该占比以数据库内多通路及其他基因捕获的遗传力之和作分母;它本身不是再除以 SNP 比例后的 fold enrichment。这支持“高频基因承载的信号越多,随机通路基线越容易升高”的解释,但相关性不能分离注释偏倚与真实多功能性。
真实信号也没有全被这套参照解释掉。以 MAGMA 的 CAD、HDL 和乳腺癌为例,Figure 3 中最显著的真实通路仍可高于 GSR 随机结果同一排序位置的分布,CAD、HDL 尾部尤其清楚。这里展示的是整体排序的 QQ 分布,不能直接认定某个点对应的具体通路获得了新的因果验证。
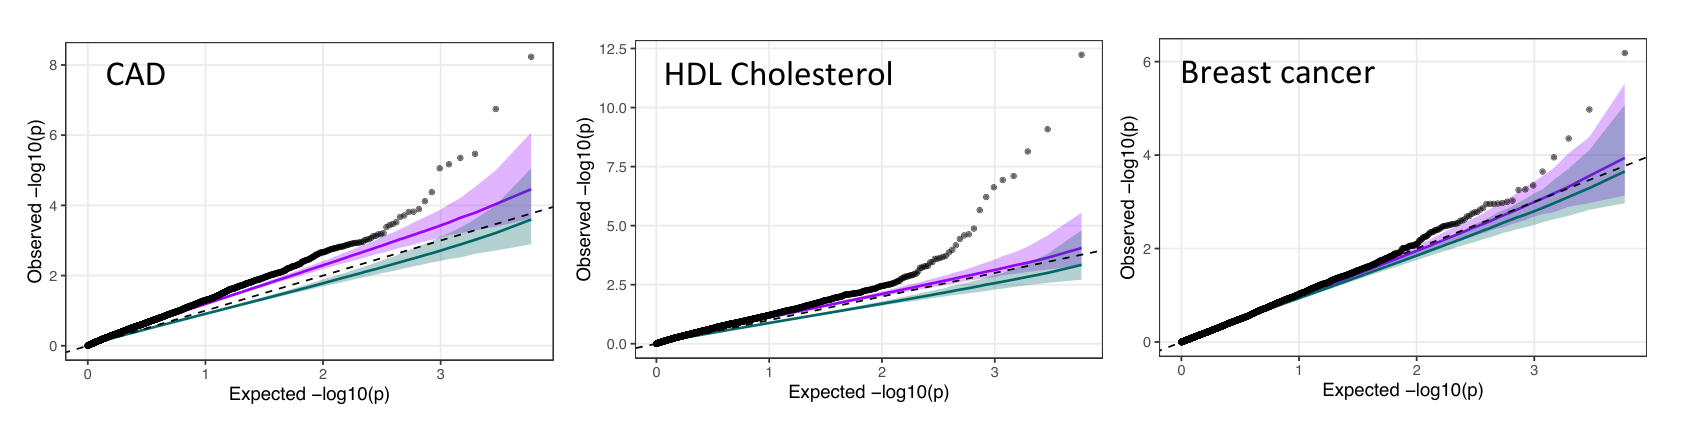
CAD、HDL 与乳腺癌的 MAGMA 通路 QQ 图。黑点为真实通路结果,紫色为 GSR、绿色为 PS 随机结果在每个排序位置的中位数;阴影为该位置 1,000 次随机结果的 2.5%–97.5% 分位范围,黑虚线为均匀零分布期望。真实结果尾部仍可超过 GSR 参照,但这是排序分布比较,不是单条通路的置信区间。
Alanna C. Cote, Reagan Kesting, Judit García-González and Paul F. O’Reilly, medRxiv (2026), 原图未修改 · CC BY 4.0 · 原图未修改 · 原文图 · 放大经验 p 值、SES 与重排序
对通路 ,设 为随机版本中原方法 p 值小于真实通路 p 值的次数,则
表示基础方法对应的通路富集效应统计量。主文没有逐一明确各软件所用输出字段,因此不将其统一改写成 ;对 GSA-MiXeR,作者明确使用 SNP 遗传力 fold enrichment。
重排先看经验 p,再看标准化效应 SES;1,000 次随机化的最小经验 p 为 ,许多强信号会并列,SES 用于进一步区分。SES 只是随机参照下的标准化差异,论文没有赋予它标准正态分布。 GSA-MiXeR 以遗传力 fold enrichment 构造 SES。PRSet 的 GSR 经验 p 则比较软件输出的原始关联 p,明确不是对其竞争性 p 再调整。
排序验证通常只在原方法 top 500 通路中进行;GSA-MiXeR 用其他三法各自 top 500 的并集,因而可能多于 500 条,也不是按它自己的原始排名选择。这是条件于候选集的排序评价,不是全数据库发现功效比较。
外部证据支持多少,独立性到什么程度
验证量是通路排序与外部评分的 Spearman 相关。Open Targets 只保留文献、药物和动物模型证据,明确去掉遗传关联来源;无证据基因记 0 后,按通路取均值。MalaCards 先对疾病内基因分数作秩变换,再按通路取均值,但 Methods 未说明进行了对应的遗传证据排除。
DoRothEA 去掉来自文献审阅的 TF–target 关系,用通路内获得直接调控或共同 TF 支持的基因对比例评分;它评价功能联系,并非性状特异致病证据。GTEx 对基因的 除以跨组织总和,再取通路平均;每个性状指定一个代表组织,BMI 使用额叶皮层。代表组织是代理,不能据此确认唯一因果组织。
作者报告:GSR 在 60.8% 的单项比较、79.3% 的疾病关联基准比较中提高相关,16 个“方法 × 验证框架”汇总比较中有 10 个提高。前两项的逐条结果在未附 Supplementary File 2,不能独立复算;也不能把这些比例当成发现准确率或显著改善率。Figure 6 的黑色实心点只表示单个相关达到名义 ,不是调整前后差异通过检验。
MAGMA、Pascal 的改善主要出现在 Open Targets、MalaCards,CAD、IBD、T2D 较明显,整体幅度较小;PRSet 改善更大。GSA-MiXeR 表现混合,DoRothEA 上不少相关在调整前后都为负,不能概括为四种方法均有稳定收益。主文没有逐条给出获提升通路名称及后续实验,不能据此编写新的疾病机制案例。
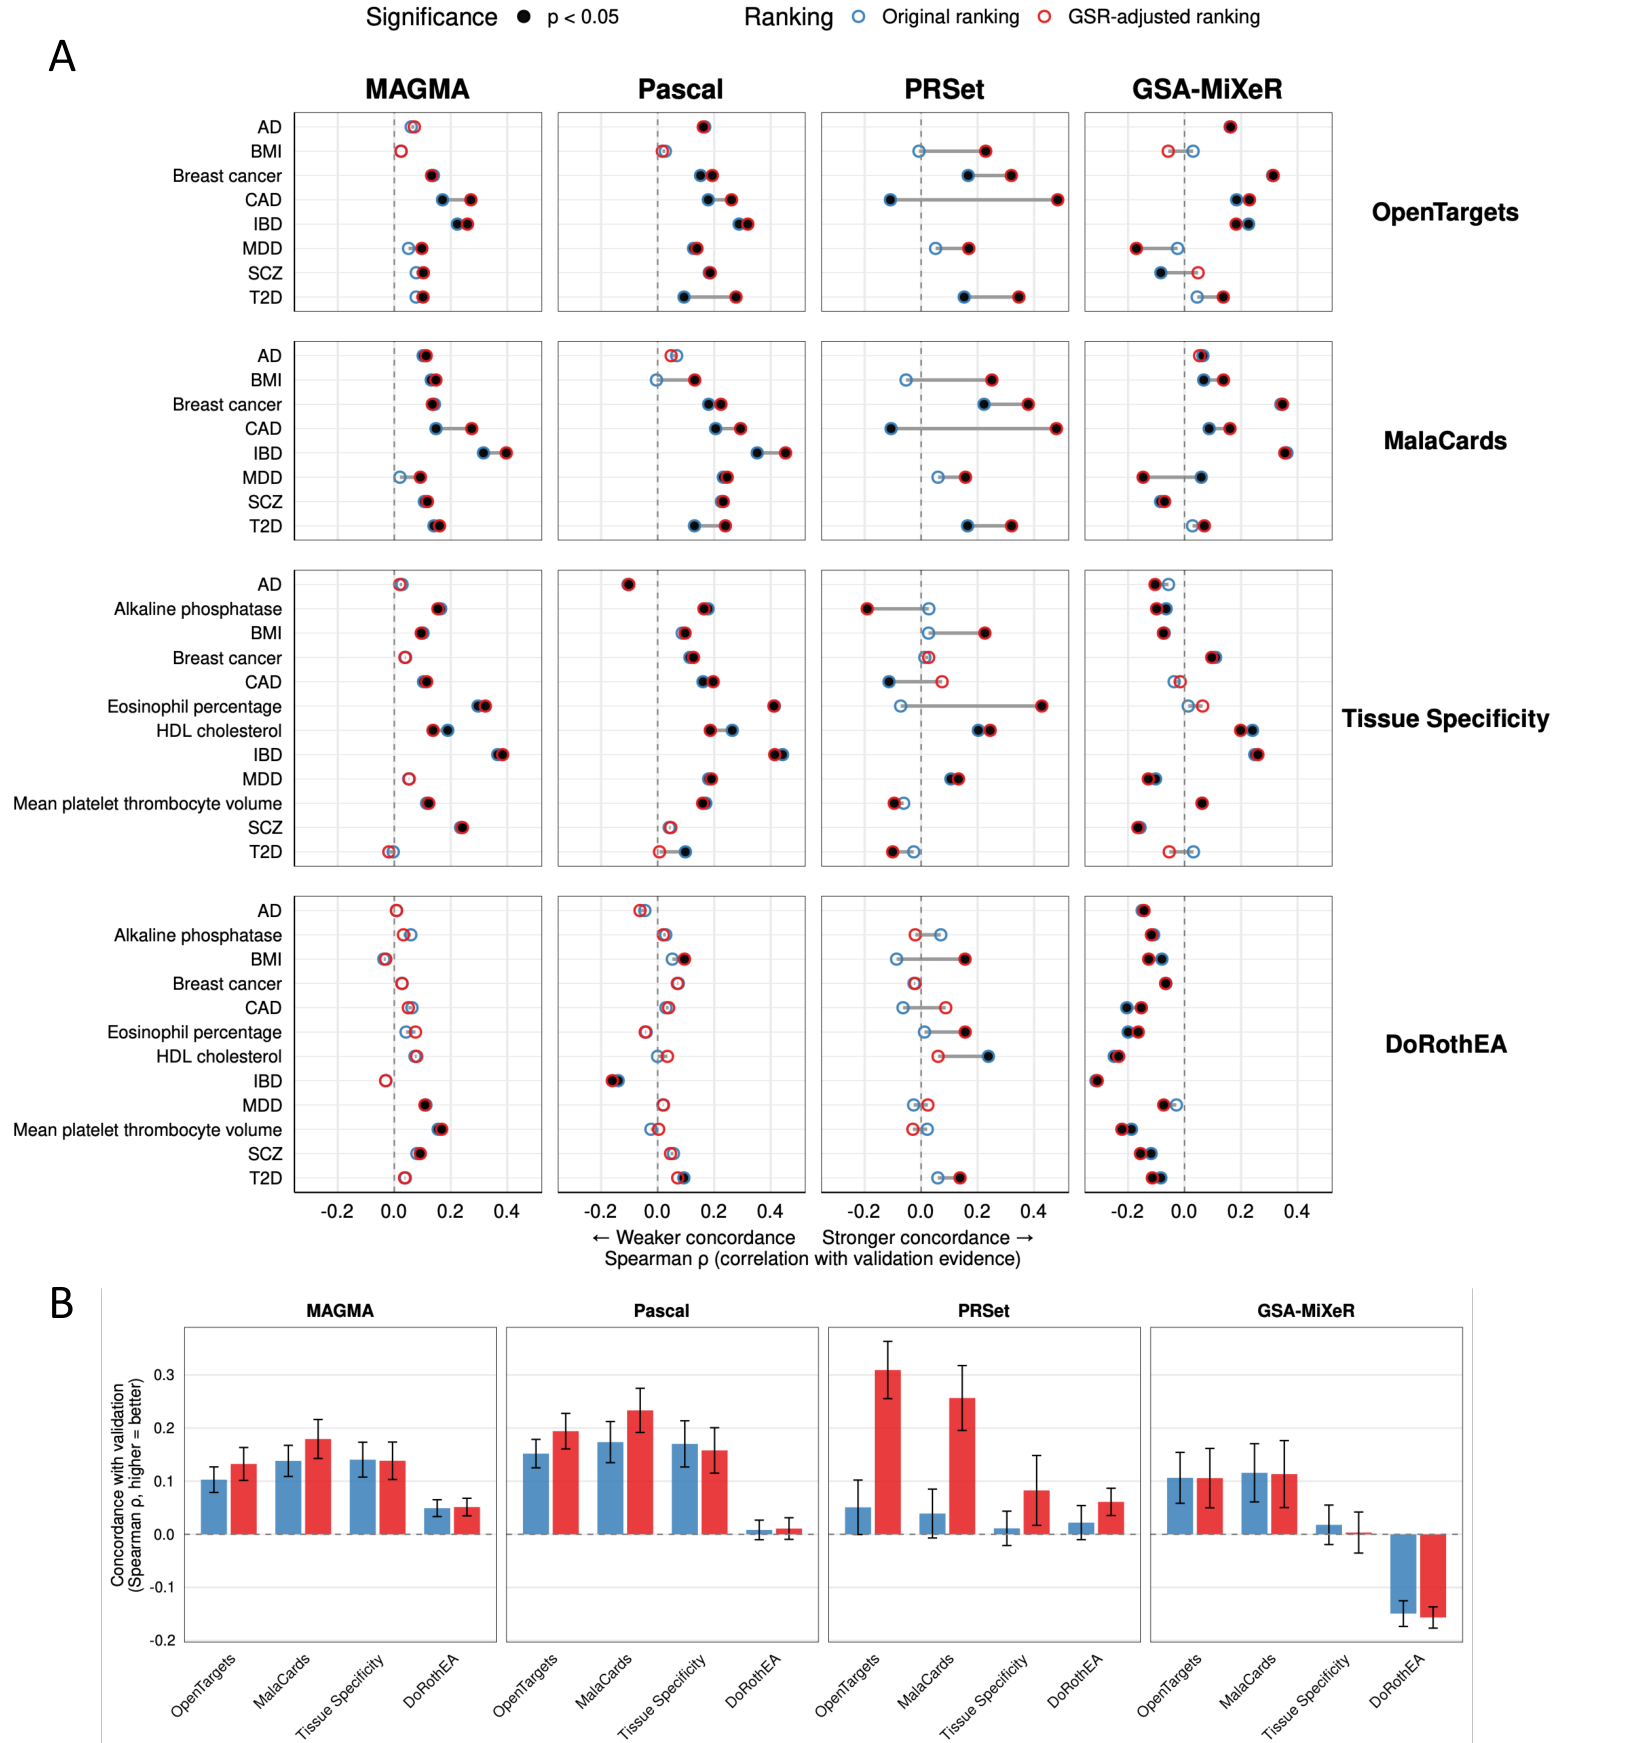
A,原始排序(蓝圈)与 GSR 排序(红圈)同四类外部证据的 Spearman 相关;黑色填充表示该相关名义 p<0.05,并不检验调整增益是否显著。B,按方法和验证资源汇总的跨性状平均相关,误差条为均值标准误。PRSet 排除 AD、IBD、SCZ;疾病基准各覆盖 8 个性状(PRSet 5 个)。通常使用原方法 top 500 候选,GSA-MiXeR 的候选是其他三法 top 500 的并集。
Alanna C. Cote, Reagan Kesting, Judit García-González and Paul F. O’Reilly, medRxiv (2026), 原图未修改 · CC BY 4.0 · 原图未修改 · 原文图 · 放大独立性的另一限制来自通路大小:作者观察到,外部证据高分主要集中在小通路,而 GSR 也倾向提高小通路的相对排名。两个量沿相同方向变化,本身就可能提高相关。主文未给出充分的大小匹配或条件化验证来量化剩余增益,因此更合适的结论是“改善了这些资源定义的排序一致性”,尚不能证明全部收益来自更准确的疾病机制识别。
在实际 GWAS 分析中的位置
作者明确把 GSR 定位为通路优先级工具,没有跨通路 FWER 保证,也不建议用其经验 p 替换原方法 p 作正式推断。1,000 次随机化的分辨率也远高于 5,878 条通路的 Bonferroni 阈值。随机通路不匹配原通路的基因间相关或局部 LD 结构;基础方法内部的 LD 校正可能缓解,却不能直接保证消除这项差异。
对统计遗传学研究,更有用的应用是并列查看原始富集、GSR 排名、通路大小和高频基因贡献,识别一个解释究竟由特定基因组合支持,还是高度依赖反复出现的基因。正文没有运行时间、内存或加速倍数比较;公开的 Nextflow 流程仍需对大量随机数据库运行基础方法,不能仅凭交换步骤简单就称其为低成本分析。