APOE 分层 GWAS:分组发现、效应差异与正式交互
APOE-stratified genome-wide association analyses provide insights into the genetic etiology of Alzheimers’s disease
按APOE基因型分层开展AD GWAS,再以分层效应差异、等位基因剂量趋势和统一logistic交互模型分别检验背景依赖。DDHD1是有价值的案例,但全基因组正式交互检验、名义eQTL证据和表达介导不能混为一谈。
本文目录
分层发现与遗传背景依赖不是同一个结论
这篇研究围绕 APOE 这一 AD 风险的重要遗传背景开展分析。其方法学价值不只在新增位点,而是把三个通常容易混淆的问题放在同一数据框架下:一个位点在某分层是否有关联;两个分层的效应是否不同;统一模型中的 SNP×APOE 交互是否通过全基因组检验。
对于细胞类型或状态依赖的 QTL,类似区分同样重要。细胞 A 有显著 eQTL、细胞 B 没有,可能反映功效不同,而不是遗传调控机制真的只在 A 中存在。本文的分层效应比较值得借鉴,但不同分析的证据强度也必须分别保留。
样本、表型与分析顺序
主要全基因组发现分析来自八个欧洲祖源研究,按 APOE 分为 ε22+ε32、ε33、ε43+ε44,排除 ε42;另分析 ε44 子集。作者随后在东亚、Asian American、African American 和 admixed American 队列检查选出的 29 个区域。不能将后者描述为所有祖源共同贡献了同样完整、同等功效的全基因组发现。
| APOE 分层 | 病例 | 对照 | 纳入 meta-analysis 的变异数 |
|---|---|---|---|
| ε22+ε32 | 2,606 | 70,388 | 10,336,311 |
| ε33 | 24,033 | 363,161 | 17,127,662 |
| ε43+ε44 | 29,122 | 164,206 | 14,672,059 |
ε44 的单独分析与 ε43+ε44 重叠,不能作为额外独立队列累计样本数。ε2 组没有全基因组显著信号,也不能解释为没有遗传作用:它的病例数远小于另外两组。
病例主要依据临床诊断、相应诊断代码及各队列的入选规则,并非所有人经过相同的病理确认。对照年龄等规则有助于减少潜在未发病者,但不能消除未来发病或诊断误差。作者剔除已知队列重叠,并在补充材料中讨论表型异质性。以下解释以这一设计为前提,不把观察到的临床 AD 风险直接等同于单一病理过程。来源:主文、Methods 和补充队列说明。
分层关联模型与位点确定
每个队列在各 APOE 分层内开展加性 SNP 关联分析,使用适合该队列数据的 logistic / Firth 或 REGENIE 等实现,调整年龄、性别、PCs 和需要的技术协变量,然后进行逆方差加权固定效应 meta-analysis。
设第 个队列、第 个分层的 SNP log-odds 系数为 ,标准误为 ,则合并系数为
这只是原文 meta-analysis 的标准表达,并不是对个体数据的新拟合。作者在汇总前过滤插补质量较差、极端效应和有效次要等位基因信息不足的变异,并要求主要贡献队列中的足够支持,对极端研究间异质性也进行排除。
分层 GWAS 的主要阈值为 。作者考虑 APOE 分层间相关性,以有效检验数约为 2 的处理调整常用阈值。它与后续只检查 29 个候选位点时的阈值不同。
位点识别包含按显著性选 lead variant、结合附近区间及 LD 归并信号,再迭代寻找未归入的显著变异;作者进一步在五个最大队列开展条件分析,检查部分邻近信号是否独立。因此,“附近存在另一个 GWAS 峰”和“同一条件模型中存在独立信号”也有区别。
两个主要分层共检出 25 个位点:9 个共同显著,9 个仅在 ε43+ε44 显著,7 个仅在 ε33 显著;考虑额外独立信号后得到 29 个 lead signals。本文讨论的九个新 genomic signals 则来自分层 SNP 分析、统一模型分析及基因水平分析等不同来源,不能简化为九个独立复制的 SNP×APOE 交互。
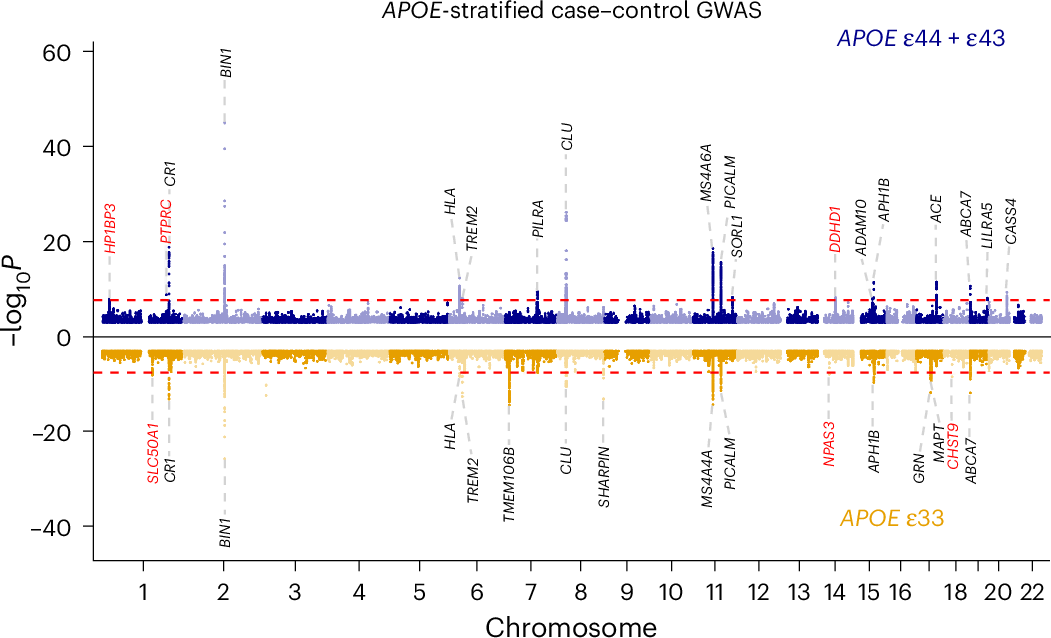
两个分层中显著信号的分布不同,但这张图本身没有检验分层效应的差值。位点的组别特异显著性须结合后续交互分析解释。
Thomassen et al., Nature Genetics 2026, Figure 1;出版商原始图像。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大三种效应异质性分析各自在检验什么
分层汇总统计量的显性背景比较
对 ε33 与 ε43+ε44,先在队列内计算
在两个分层估计独立的近似下,差值方差为两个标准误平方之和,再合并队列的差值。该检验针对 SNP log-odds 效应的差异,而不是对两组 P 值作比较。原文对 29 个 lead signals 使用 的阈值。
该策略支持七个位点的显性背景效应差异:SLC50A1、TMEM106B、NPAS3 在 ε4 背景中的效应减弱,BIN1、HLA-DRA-1、CLU、DDHD1 的模式则不同或增强。因为这些是从同批关联数据筛出的候选,仍应考虑发现阶段筛选对效应比较的影响,不能把它当作完全独立复制。
ε4 剂量的加性趋势
作者还用 ε33、ε43、ε44 的分层效应进行 meta-regression,研究 SNP 效应是否随 ε4 剂量 0、1、2 改变。其概念形式为
并按分层效应估计的不确定性加权。它假设随 ε4 剂量的变化可由线性趋势刻画,和“携带任意 ε4”这一显性编码不同;例如 SHARPIN 在加性趋势分析中得到额外支持。主分析与随机队列效应敏感性分析需要区分,不能把全部分析统称为同一种混合模型。
统一个体水平模型的全基因组扫描
在五个最大队列,作者另拟合包含正式交互项的模型。令 为 ε33, 为 ε43+ε44:
是参考背景下 SNP 的 log-odds 效应, 是 ε4 背景中的相应效应, 是两个 SNP odds ratios 的比值。它不是绝对风险差,也不证明风险差尺度上的同等交互。
统一模型和分层后效应比较还可能对协变量系数施加不同限制,且贡献队列数不完全相同,因此不应默认两者数值必然一致。最重要的结果是:**全基因组正式交互扫描只有 APOE 区域达到显著,DDHD1 为 ,未达到 。**统一模型中 SNP 主效应项显著的 SMYD2、ANK3 等,也不能改称交互项显著。
这些区别解释了为什么原文可以同时报告多个分层效应差异和有限的全基因组交互发现,而不构成统计上的矛盾。来源:主文 Table 2、Methods,补充表 8–11。
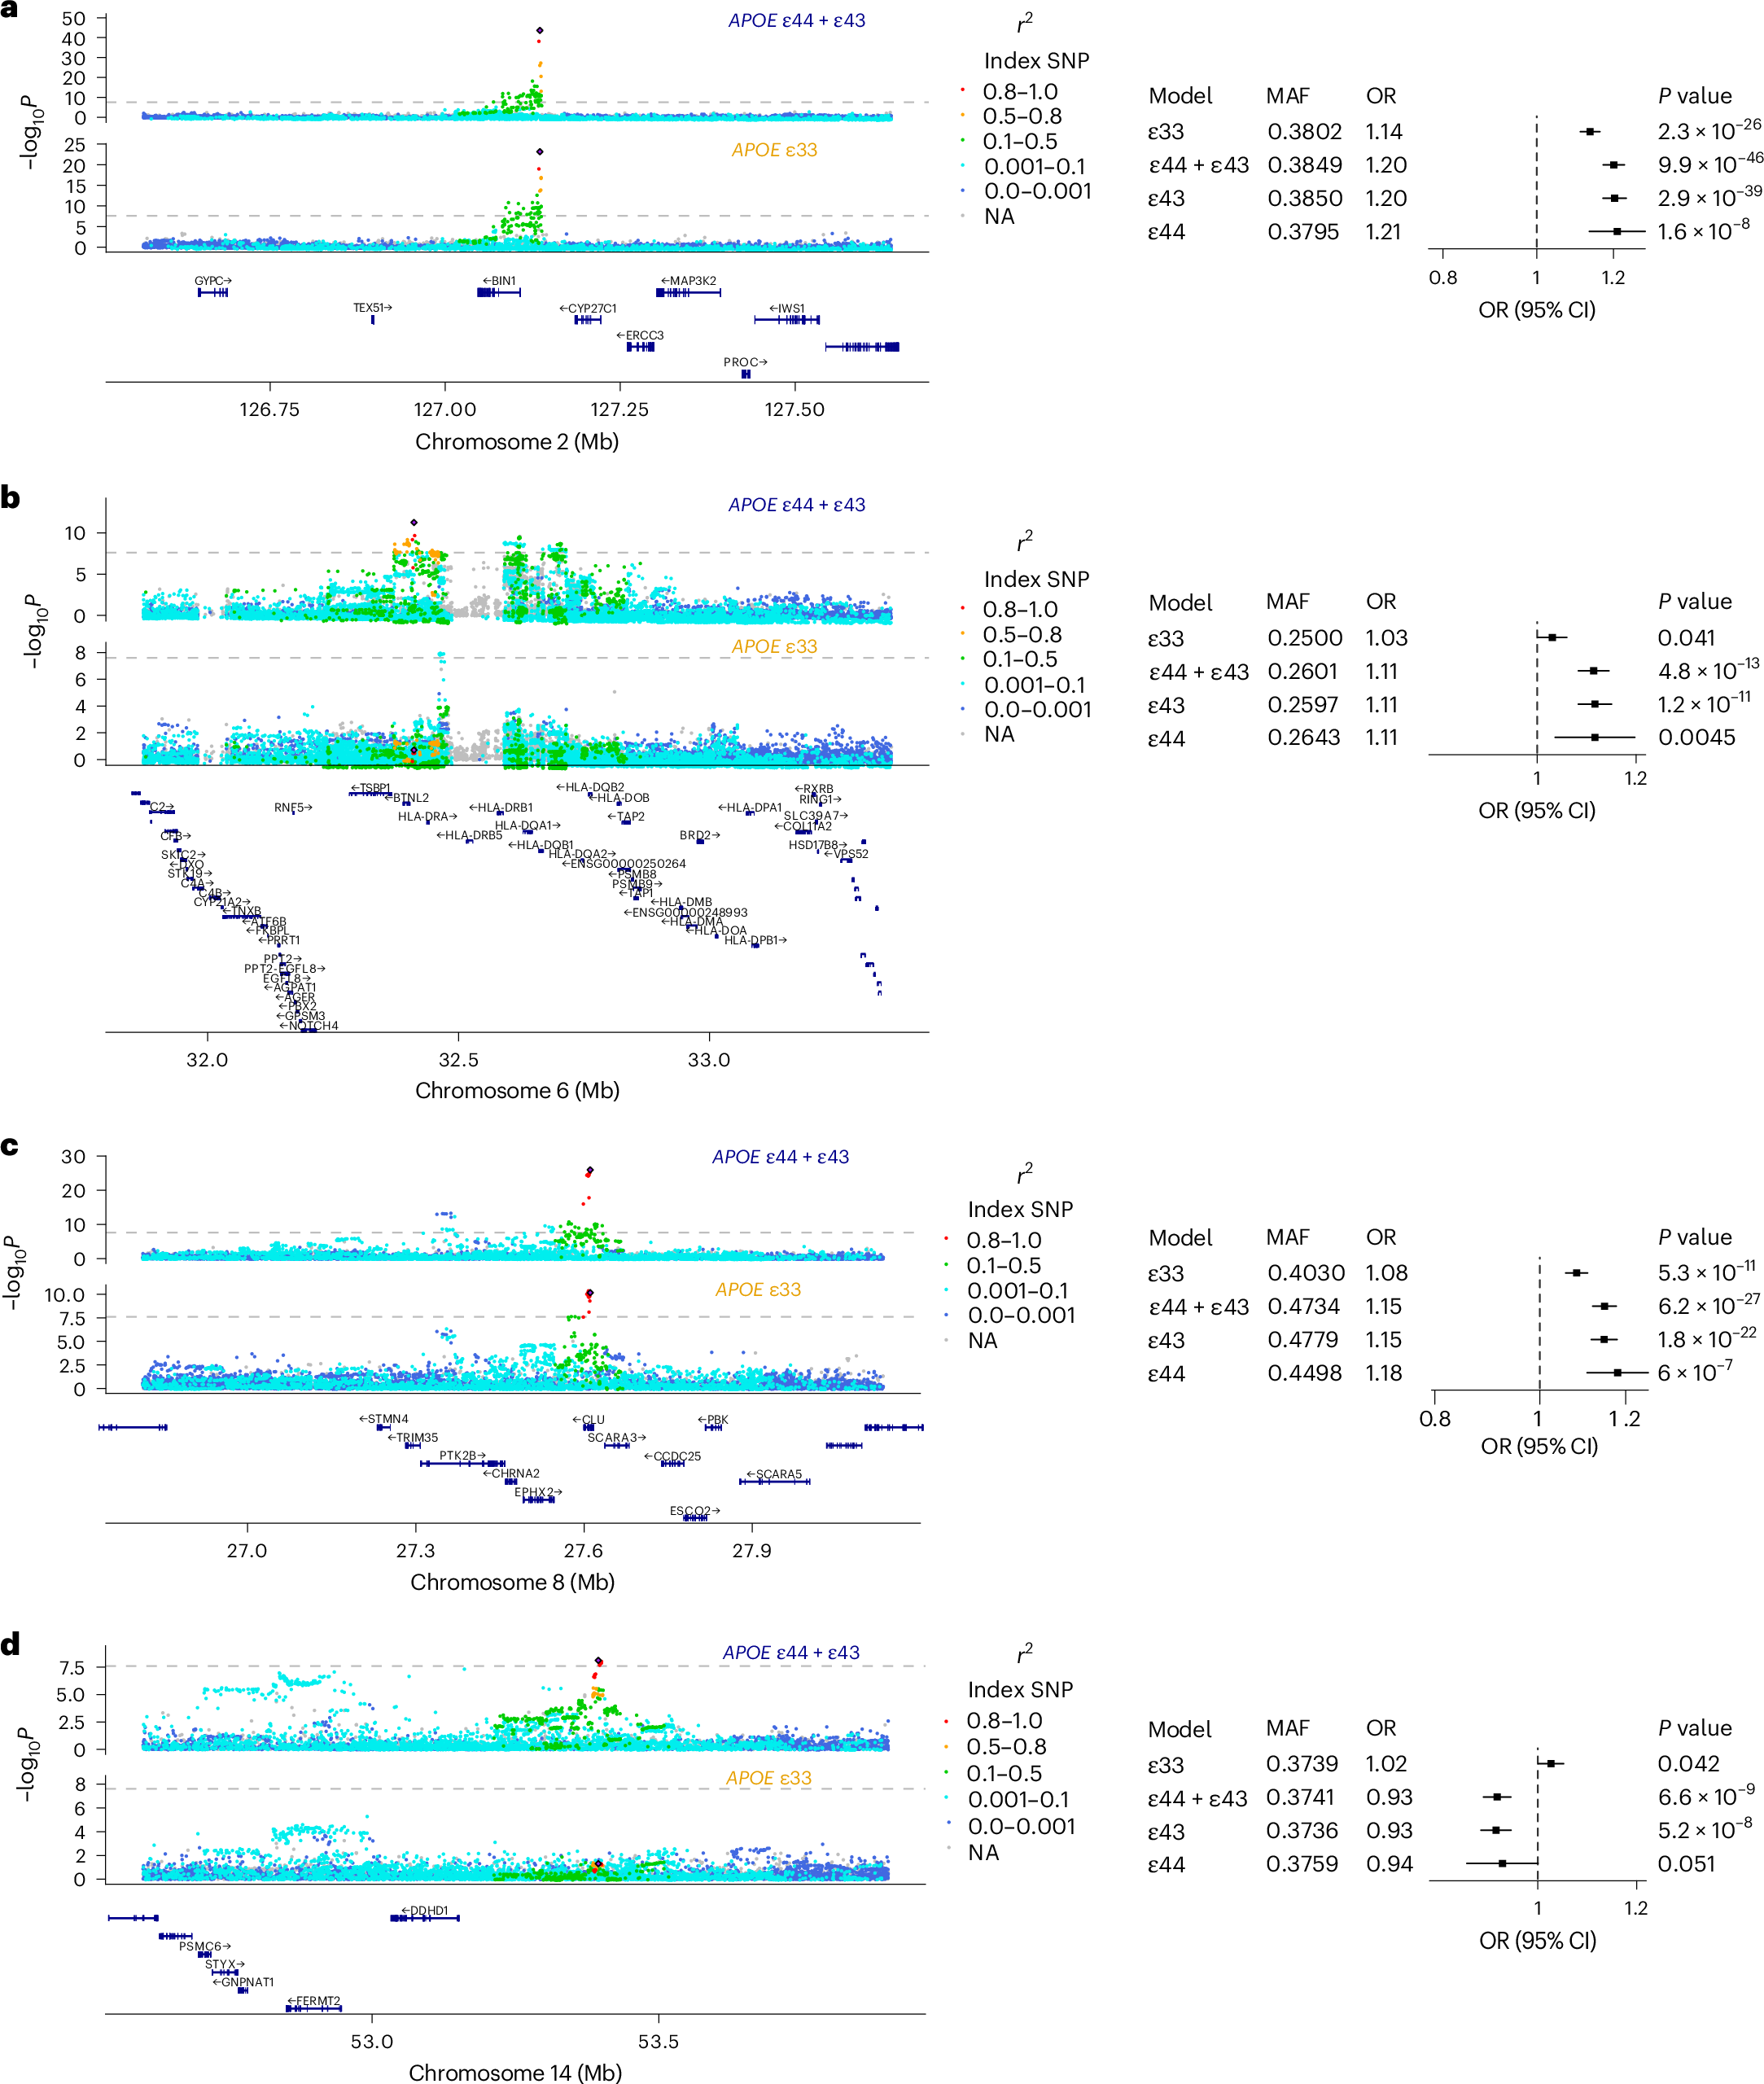
区域峰与森林图结合显示APOE背景下效应变化的候选证据。分层效应比较和全基因组统一模型交互检验使用不同数据与阈值,不能只根据峰值判断互作。
Thomassen et al., Nature Genetics 2026, Figure 3;出版商原始图像。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大DDHD1:疾病关联、eQTL 与介导证据逐层拆开
主文 Table 1 中 rs10131116 的 C 等位基因在 ε33 组 OR 为 1.02(约1.00–1.05),;在 ε43+ε44 组 OR 为 0.93(0.90–0.95),。两组效应模式与背景依赖相容,条件分析又支持它不同于附近 FERMT2 信号。但对其证据应依次保留以下层次。
首先,分层效应比较达到候选位点阈值,不等于正式全基因组交互扫描已经确认;后者仍是上述 。
其次,DDHD1 有脑组织 eQTL 证据。作者引用 ROSMAP 总样本 、、,以及 GTEx v10 putamen 、、。这些系数在各自表达处理尺度上报告,不能直接用大小比较脑区调控强弱。
最容易误读的是 APOE 分层 eQTL。补充表 13 给出:
| ROSMAP 分层 | n | DDHD1 eQTL β | SE | 名义 P | 表中基因特异阈值 |
|---|---|---|---|---|---|
| ε33 | 342 | −0.106 | 0.032 | ||
| ε43+ε44 | 130 | −0.132 | 0.049 |
**两组都是同方向的名义关联,均未通过该表列出的基因特异阈值。**主文本身也称 nominal P values。不能据此把“在两个背景都与表达有关”改写为“eQTL 效应存在 APOE 交互”,更不能把一个组 P 值更小解释为该组调控效应更强,因为样本量差异很大。
疾病关联具有背景依赖而 eQTL 效应相近,在逻辑上并不矛盾:背景可能改变表达对疾病过程的作用,也可能来自其他途径或标签结构。该解释只是可能的机制框架,当前证据没有在这些备选机制之间作出确定选择。
SMR、HEIDI 与通路分析没有补齐所有因果环节
作者用 MetaBrain 的多个脑区表达资源进行 SMR,采用 multi-SNP SMR 阈值 ,并结合 及足够 HEIDI SNP 数过滤。补充表 20 的最终通过结果为 ε4 组 cortex 中 STAG3,以及 ε33 组 MAPT 区域的 LRRC37A、ARL17B、LRRC37A2。
**DDHD1不是这四个SMR通过基因之一。**补充讨论说明部分新信号不能在所用 MetaBrain 资源中直接完成该测试。因此不能以“本论文也做了SMR”来替代 DDHD1 的介导验证。
作者对 HEIDI 的文字描述需要与统计含义分开阅读。HEIDI 检查跨 SNP 关联模式的异质性,未拒绝并不排除所有水平多效性,也不证明表达介导疾病。共享因果变异、直接多效性和表达介导仍需进一步区分。
通路分析在 ε33 和 ε4 分层分别得到 12 与 33 条达到 的通路。分层内富集检验数量不同,不等于已经对通路的组间富集差异进行了统一检验;关联功效与输入基因证据都能影响通过阈值的条数。来源:主文、Supplementary Discussion、补充表 18–20。
跨祖源评估的价值与限制
其他祖源队列为候选位点提供了有用检验。Figure 4 展示 HLA-DRA-1 和 DDHD1 在东亚队列中与欧洲发现方向相容的结果,但其任务主要是检查已选区域,而非全基因组重新发现全部机制。不同队列的样本量、APOE 频率、标签变异与因果变异之间的 LD 均不相同。
所以,方向一致是支持性证据,不是跨祖源精细定位完成;未显著也不能直接解释为祖源特异。真正要区分效应可迁移与标记可迁移,需要同时考虑关联不确定性、局部 LD 和潜在因果变异,而不只比较同一 rsID 的 P 值。
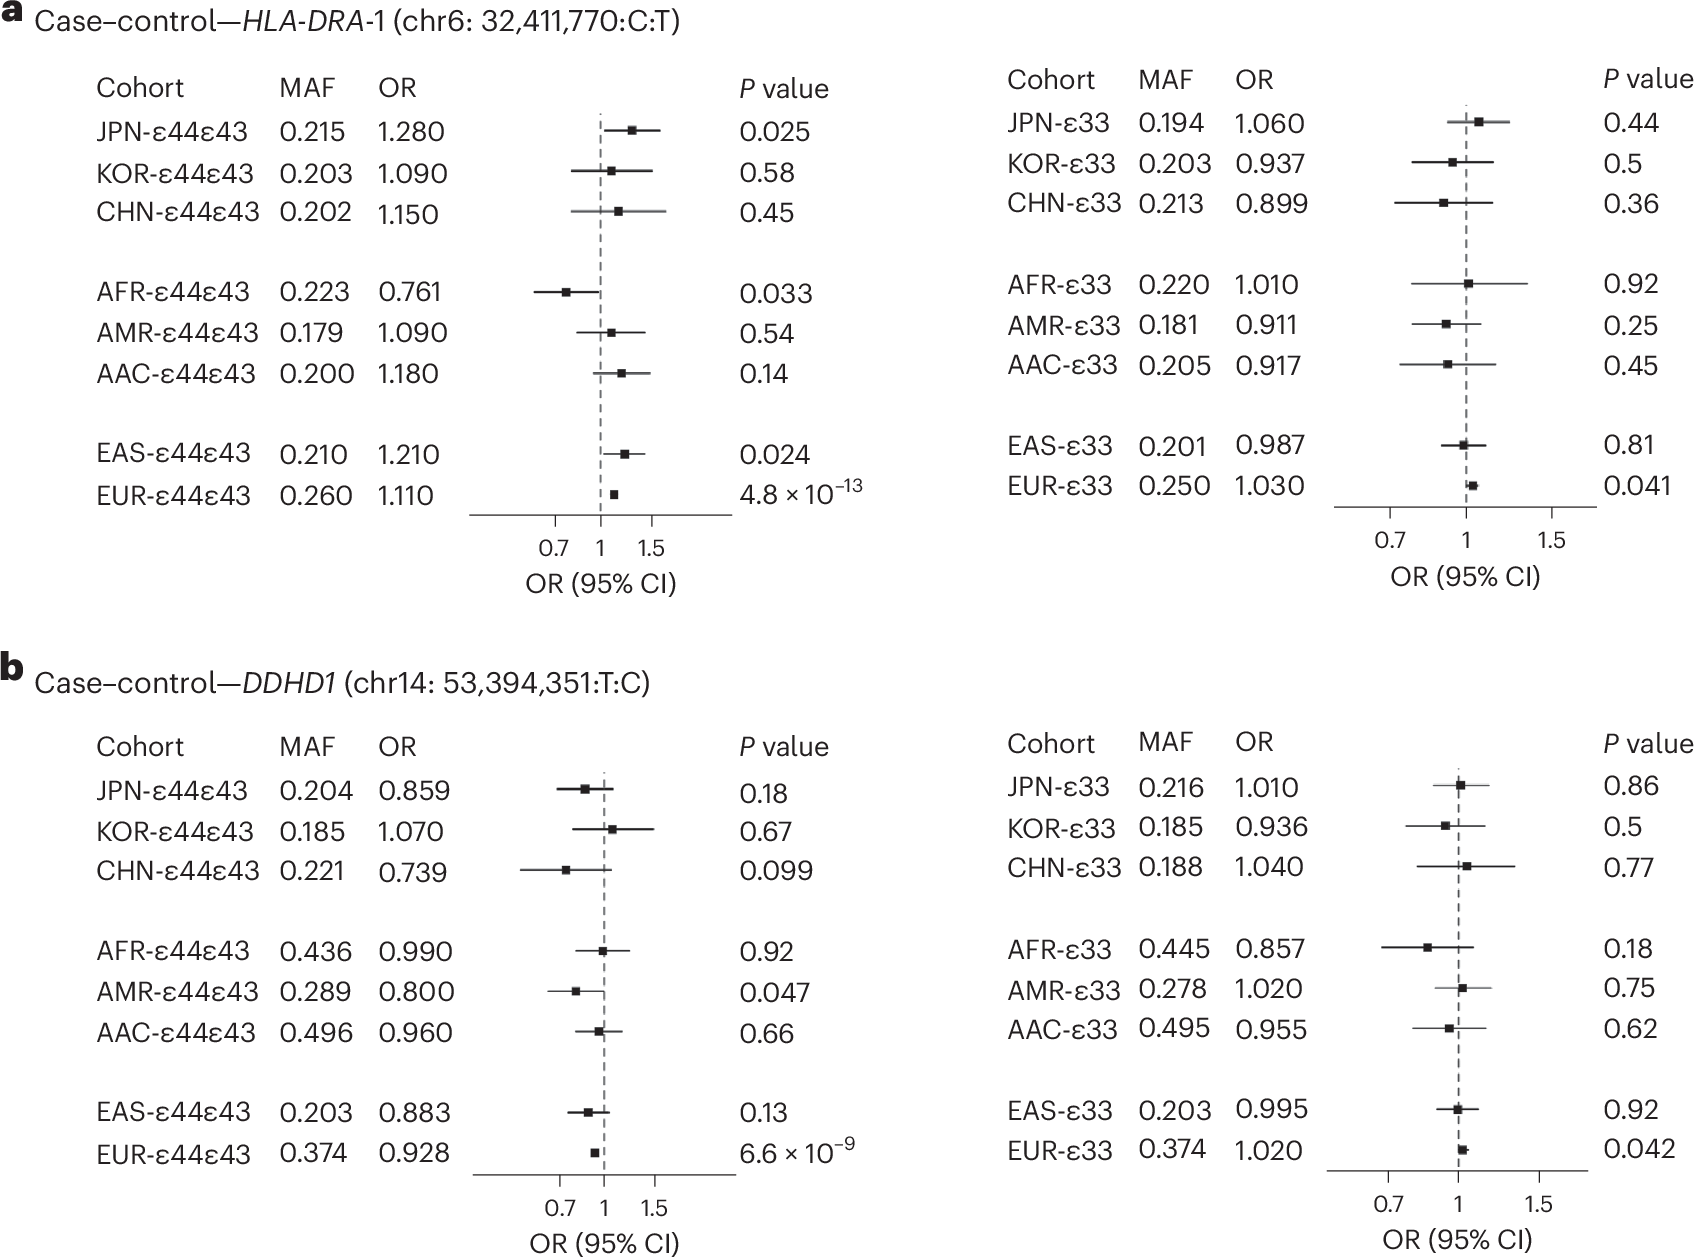
东亚分析补充了候选位点的跨祖源证据,但样本量、LD和标签变异的差异限制了它对交互与因果变异的直接确认。
Thomassen et al., Nature Genetics 2026, Figure 4;出版商原始图像。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大对研究设计与机制解释的评价
本文的优势是没有停留在分层曼哈顿图,而是加入效应差异、剂量趋势、统一交互、条件分析和外部队列。DDHD1 的条件独立性、方向变化与表达证据形成一个值得后续实验研究的候选框架。
局限必须对应真实设计。其一,临床 AD 表型可能混有不同病理过程,且 ε33 病例年龄结构与 ε4 病例不同;年龄校正敏感性分析有帮助,却不能完全消除诊断构成差异。其二,ε2 分层功效不足,ε42 排除意味着结论不覆盖全部 APOE 组合。其三,分层后估计的独立性仍取决于样本与家系结构,随机队列效应不自动等于充分建模亲缘协方差。其四,29个发现区域内的校正与全基因组交互扫描对应不同证据标准。
作者提出机制导向的治疗研究方向,但遗传关联和脑组织 eQTL 不是药物抑制的疗效或安全性试验。尤其基因剂量、发育阶段、细胞类型及既有神经系统疾病关系复杂,不能把“降低表达的等位基因与较低风险相关”直接变成临床干预建议。
对细胞类型和状态特异 QTL 的研究启示
以下是方法借鉴,不是本文已经开展的单细胞分析。
可以把常规分层工作流改为三级证据:先报告各细胞类型的效应和标准误,再直接检验共享 donor 条件下的效应差异,最后用预先定义的统一交互模型验证。由于同一 donor 的多种细胞类型通常共享基因型,不能直接照搬独立分层时“两个方差相加”的近似;应保留相应协方差。
在解释疾病背景依赖时,也应把调控环节和疾病环节拆开。某基因的 eQTL 在两背景相近,而疾病关联不同,并不要求强行寻找一个“背景特异 eQTL”来闭合机制链。可先提出不同机制模型,再通过跨背景共定位、效应差异、扰动或中介敏感性分析逐步排除。
另一个可直接改进的实践是给每个结论标明检验家族和尺度:单细胞内部 eQTL FDR、预选基因的交互校正、全基因组交互阈值,不能相互替代;log-odds、表达标准化单位和细胞组成比例也不能混用。
阅读结论与数据入口
**评价:**值得作为背景依赖遗传效应的实证案例阅读,而不是一篇已经系统解决遗传互作识别的新算法论文。最有研究启发的是效应比较的组织方式;最重要的证据边界是 DDHD1 的候选交互、名义分层 eQTL 与表达介导尚属不同层次。
已核读19页期刊PDF及Methods,重点查看110页补充材料中的模型说明、候选位点/eQTL图与补充讨论,核查补充表7–13、20中的相关结果;未声称逐项重现全部85幅补图,亦未重跑GWAS或表达分析。
原文数据可用性列出 GCST90861026–GCST90861031,分别对应相关 APOE 分层与交互汇总统计。图像按 CC BY-NC-ND 4.0 原样用于非商业科研阅读评论;本页说明文字与作者原图明确分开。