Beyond exons:多基因性与非编码遗传力的分布
Beyond exons: Linking noncoding heritability and polygenicity across complex human traits and disorders
以 34 个性状分析多基因性、基因组区域 SNP 遗传力与注释拟合贡献:多基因性较高的性状有较低的外显子份额、较高的基因间区份额。ACS 衡量拟合改善,不能直接作为功能先验概率。
本文目录
全文解读|AJHG 校正校样,2026-09-04 在线发表,已同行评议。 本文依据 14 页 PDF 主文、Methods 和原图;附件不含独立补充材料,补充分析按正文报告。页脚的 2026-10-01 为卷期日期,与在线日期分别处理。论文 · 在线日期记录 · 作者代码归档
研究问题与数据
本文问的是:不同性状不仅需要不同数量的遗传变异解释,其 SNP 遗传力是否也分布在不同的基因组区域?这里必须区分三件事:注释区域每个 SNP 的平均遗传力是否富集;该区域占全部 SNP 遗传力的多少;该注释能多大程度改善 GWAS 统计量分布的拟合。三者分别涉及富集、遗传力份额和本文的 annotation contribution score(ACS),不能互换。
作者从 70 个欧洲祖源 GWAS 中按遗传相关阈值 筛选,并优先保留 SNP 遗传力较高的性状,最终分析 34 个,涵盖精神、神经、心血管代谢、血液和免疫等表型。它们来自不同研究,不是一个统一样本量的队列;逐性状样本信息位于 Table S2,本次附件未包含该表。LD 参考为质控后的 1000 Genomes 欧洲祖源 489 人。主分析保留 MAF >0.5% 的变异,排除扩展 MHC;阿尔茨海默病另排除整条 19 号染色体。因此,下文百分比指这一分析范围内的 SNP 遗传力,不能直接扩展到全部罕见变异、结构变异或双生子研究的遗传力。
模型:性状多基因性与注释方差需要分开理解
MiXeR 的一般框架采用 spike-and-slab 效应分布:
多基因性 表示模型中具有非零效应的变异比例,区别于达到全基因组显著性的位点数;它依赖模型、参考变异集合和效应分布假设。本文跨性状比较使用 MiXeR 的多基因性估计,并以 sLD4M 及多非零方差组分模型检查排序稳定性。
但本文用于遗传力分区和主要 ACS 结果的注释模型采用无穷小近似,固定 ,MAF 依赖参数固定为 。这不是在每个注释内同时估计独立的稀疏程度。其核心是让每个 SNP 的效应方差随注释改变:
其中全基因组共享一项基础方差;一个 SNP 可同时属于多个注释,各项非负方差相加。令 ,,则标签 SNP 的边际统计量按
建模。作者最大化带 LD 权重的边际对数似然,在对数方差空间用解析梯度优化; 吸收非多基因性膨胀。这不是把所有相关 SNP 的 向量作为完整多元正态分布直接拟合。
完整模型拟合后,以 加总各 SNP 的贡献,再汇总到互不重叠的 RefSeq 外显子、内含子和基因间区。跨转录本同时属于外显子和内含子的碱基优先归为外显子。区域份额由完整 74 注释模型得到,并非分别对三个区域单独做 GWAS 或只拟合三个类别。
ACS 到底量化什么?
作者分别拟合 core(只有共享方差)、partial(共享方差加一个注释 )和 full(完整注释集合)模型,定义:
如果 ACS 为 0.6,意思是:只加入这个注释,就恢复了完整模型相对 core 的 60% 拟合改善。它不表示该注释解释 60% 遗传力,也不表示其中变异有 60% 因果概率。partial 模型没有条件化其余 73 项注释;高度重叠的注释可以各自取得高 ACS,各分数也无需加和为 1。它尤其不能作为 leave-one-annotation-out 的独立增量贡献来解释。
与按 SNP 计算的 fold enrichment 相比,ACS 同时受到注释范围和效应分布差异影响。极小但高度富集的类别未必带来最大的整体拟合改善。不过,ACS 仍依赖所选 full 模型作分母,换注释集合会改变解释基准。本文只保留二元注释,替换基因结构定义、加入二元 GPN-MSA 等轨道,再按 Dice 相似度 0.8 去冗余,得到 74 项;这是特定注释面板下的比较。
34 个性状的主要结果
外显子占基因组碱基的 2.55%,在 34 个性状中平均贡献 14.52% 的 SNP 遗传力(文中报告跨性状离散程度为 ±4.72%);内含子和基因间区合计约 85.49%。因此,外显子相对基因组覆盖仍然富集,只是绝对遗传力份额小。这里的区域分类也不能直接当作“蛋白改变机制”与“调控机制”的实验鉴定。
Figure 1 把区域份额对 回归,使用区域交互项及按性状聚类的标准误。多基因性每增加十倍,外显子份额平均降低 4.38 个百分点(95% CI −6.20 至 −2.55;),基因间区增加 4.87 个百分点(3.06 至 6.67;)。内含子变化为 −0.49 个百分点(−2.49 至 1.51;),通常占总量约一半。“稳定”描述的是所分析性状间的总体趋势,不是所有性状都有相同份额。
具体而言,厌食症、神经质和精神分裂症的外显子份额分别为 10.06%、10.37% 和 8.51%;身高、皮层表面积和性激素结合球蛋白则分别为 19.58%、21.69% 和 29.44%。这些例子体现的是连续变化及性状差异,不能概括为所有精神性状或所有躯体性状各有一个固定比例。
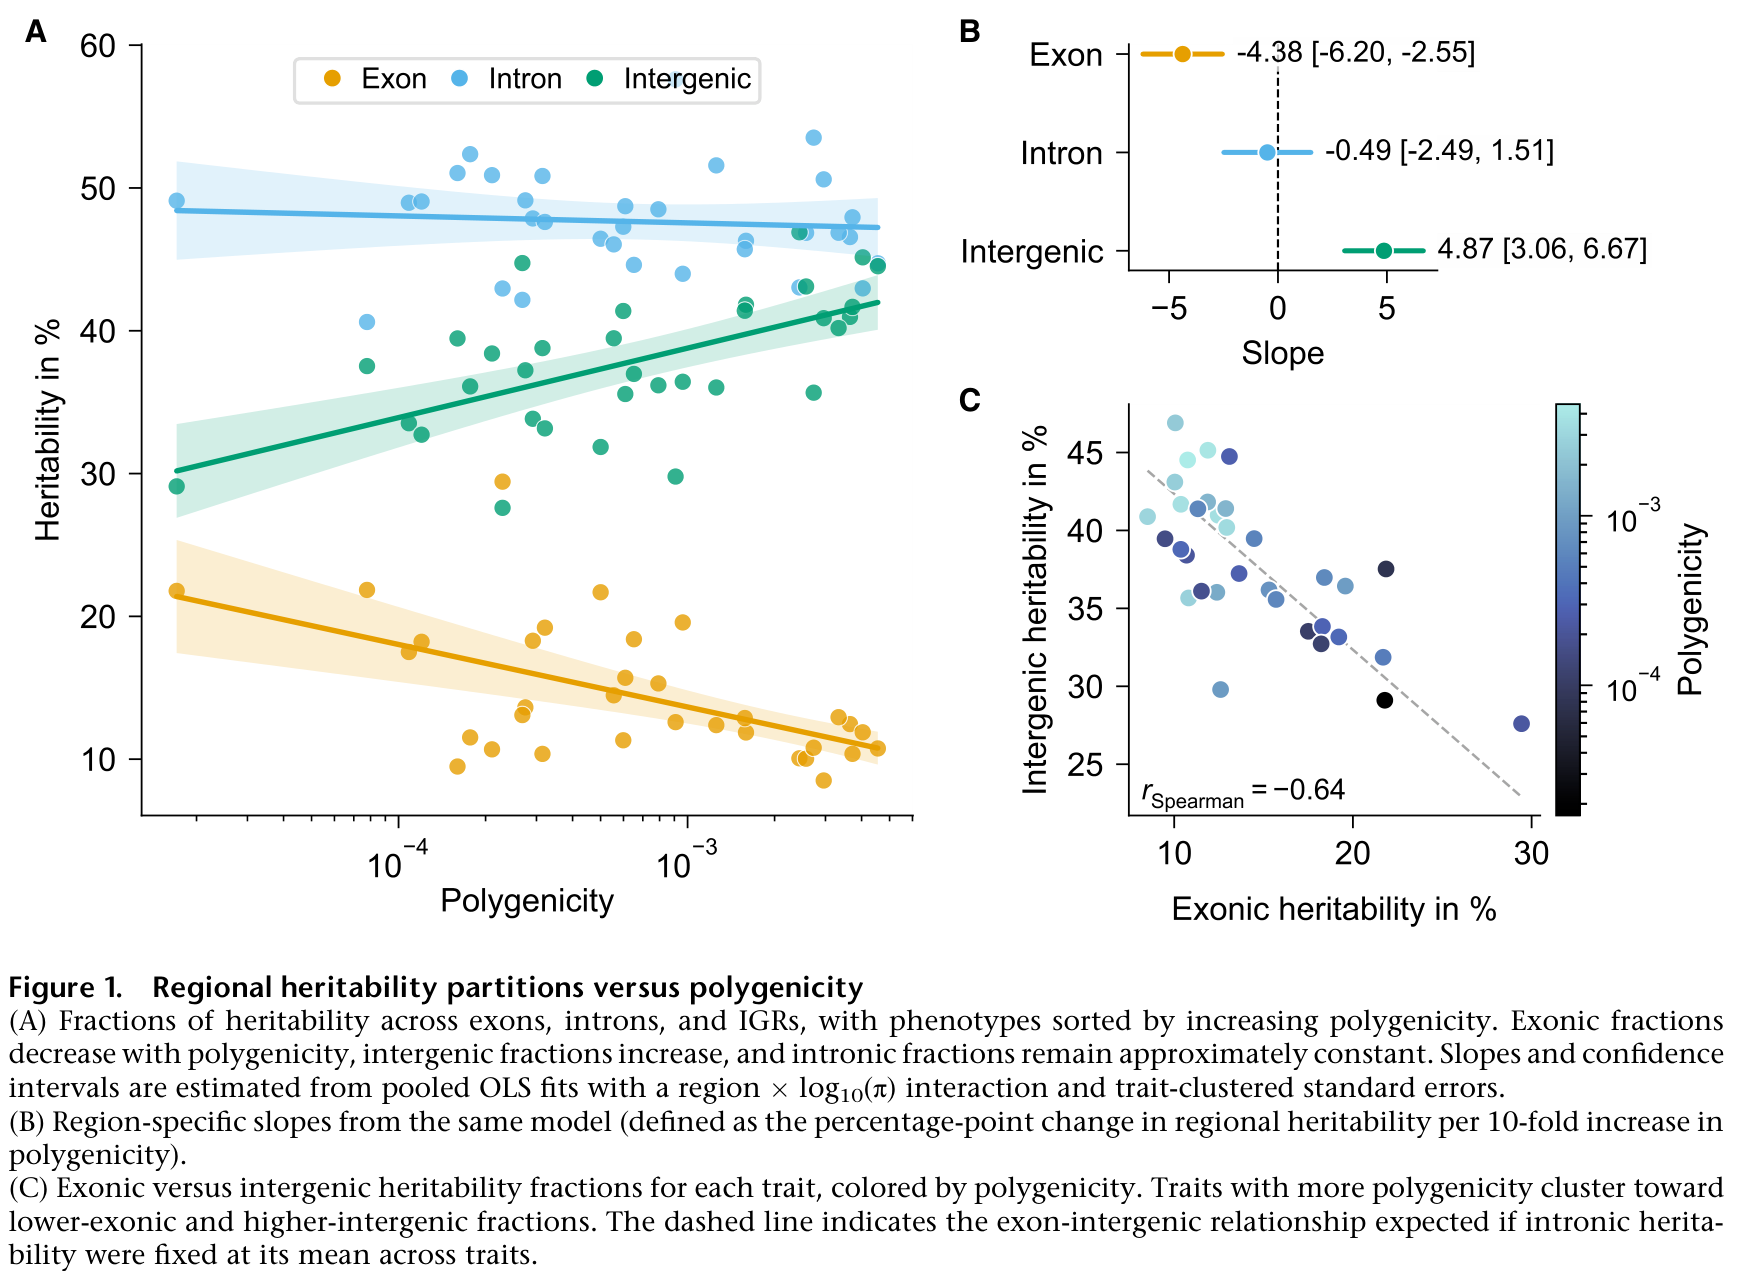
A/B 比较多基因性每增加十倍时区域份额的变化;C 展示各性状的组成。外显子与基因间区趋势相反,内含子总体斜率不显著。相关趋势不能解释成遗传力转移的因果过程。
Fuhrer et al., AJHG (2026), Figure 1 · CC BY 4.0 · 原图未修改 · 原文图 · 放大Figure 3 将性状按多基因性排序后显示:较高多基因性性状的拟合改善更多由保守性与变异效应注释捕获,如 phastCons、GERP、CADD、Eigen 和 ReMM;较低多基因性性状中,启动子、转录起始和部分染色质标记更突出。保守性注释贡献升高并不与外显子份额降低矛盾:作者进一步把保守性与区域交叉分层,报告随多基因性增加的保守序列遗传力主要位于内含子和基因间区。这个分层结果见补充 Figure S5,本次只核验到正文叙述。
还应避免把“变异效应注释”这一类别的总体趋势推广到每个序列模型。本文把 GPN-MSA 的碱基分数先汇总、再按阈值二元化,纳入同一面板;它没有比较各模型的连续输出,更没有验证具体等位基因在特定细胞中的调控效应。注释对总体遗传结构有信息,与单个位点的功能预测准确,是两个需要分别验证的问题。
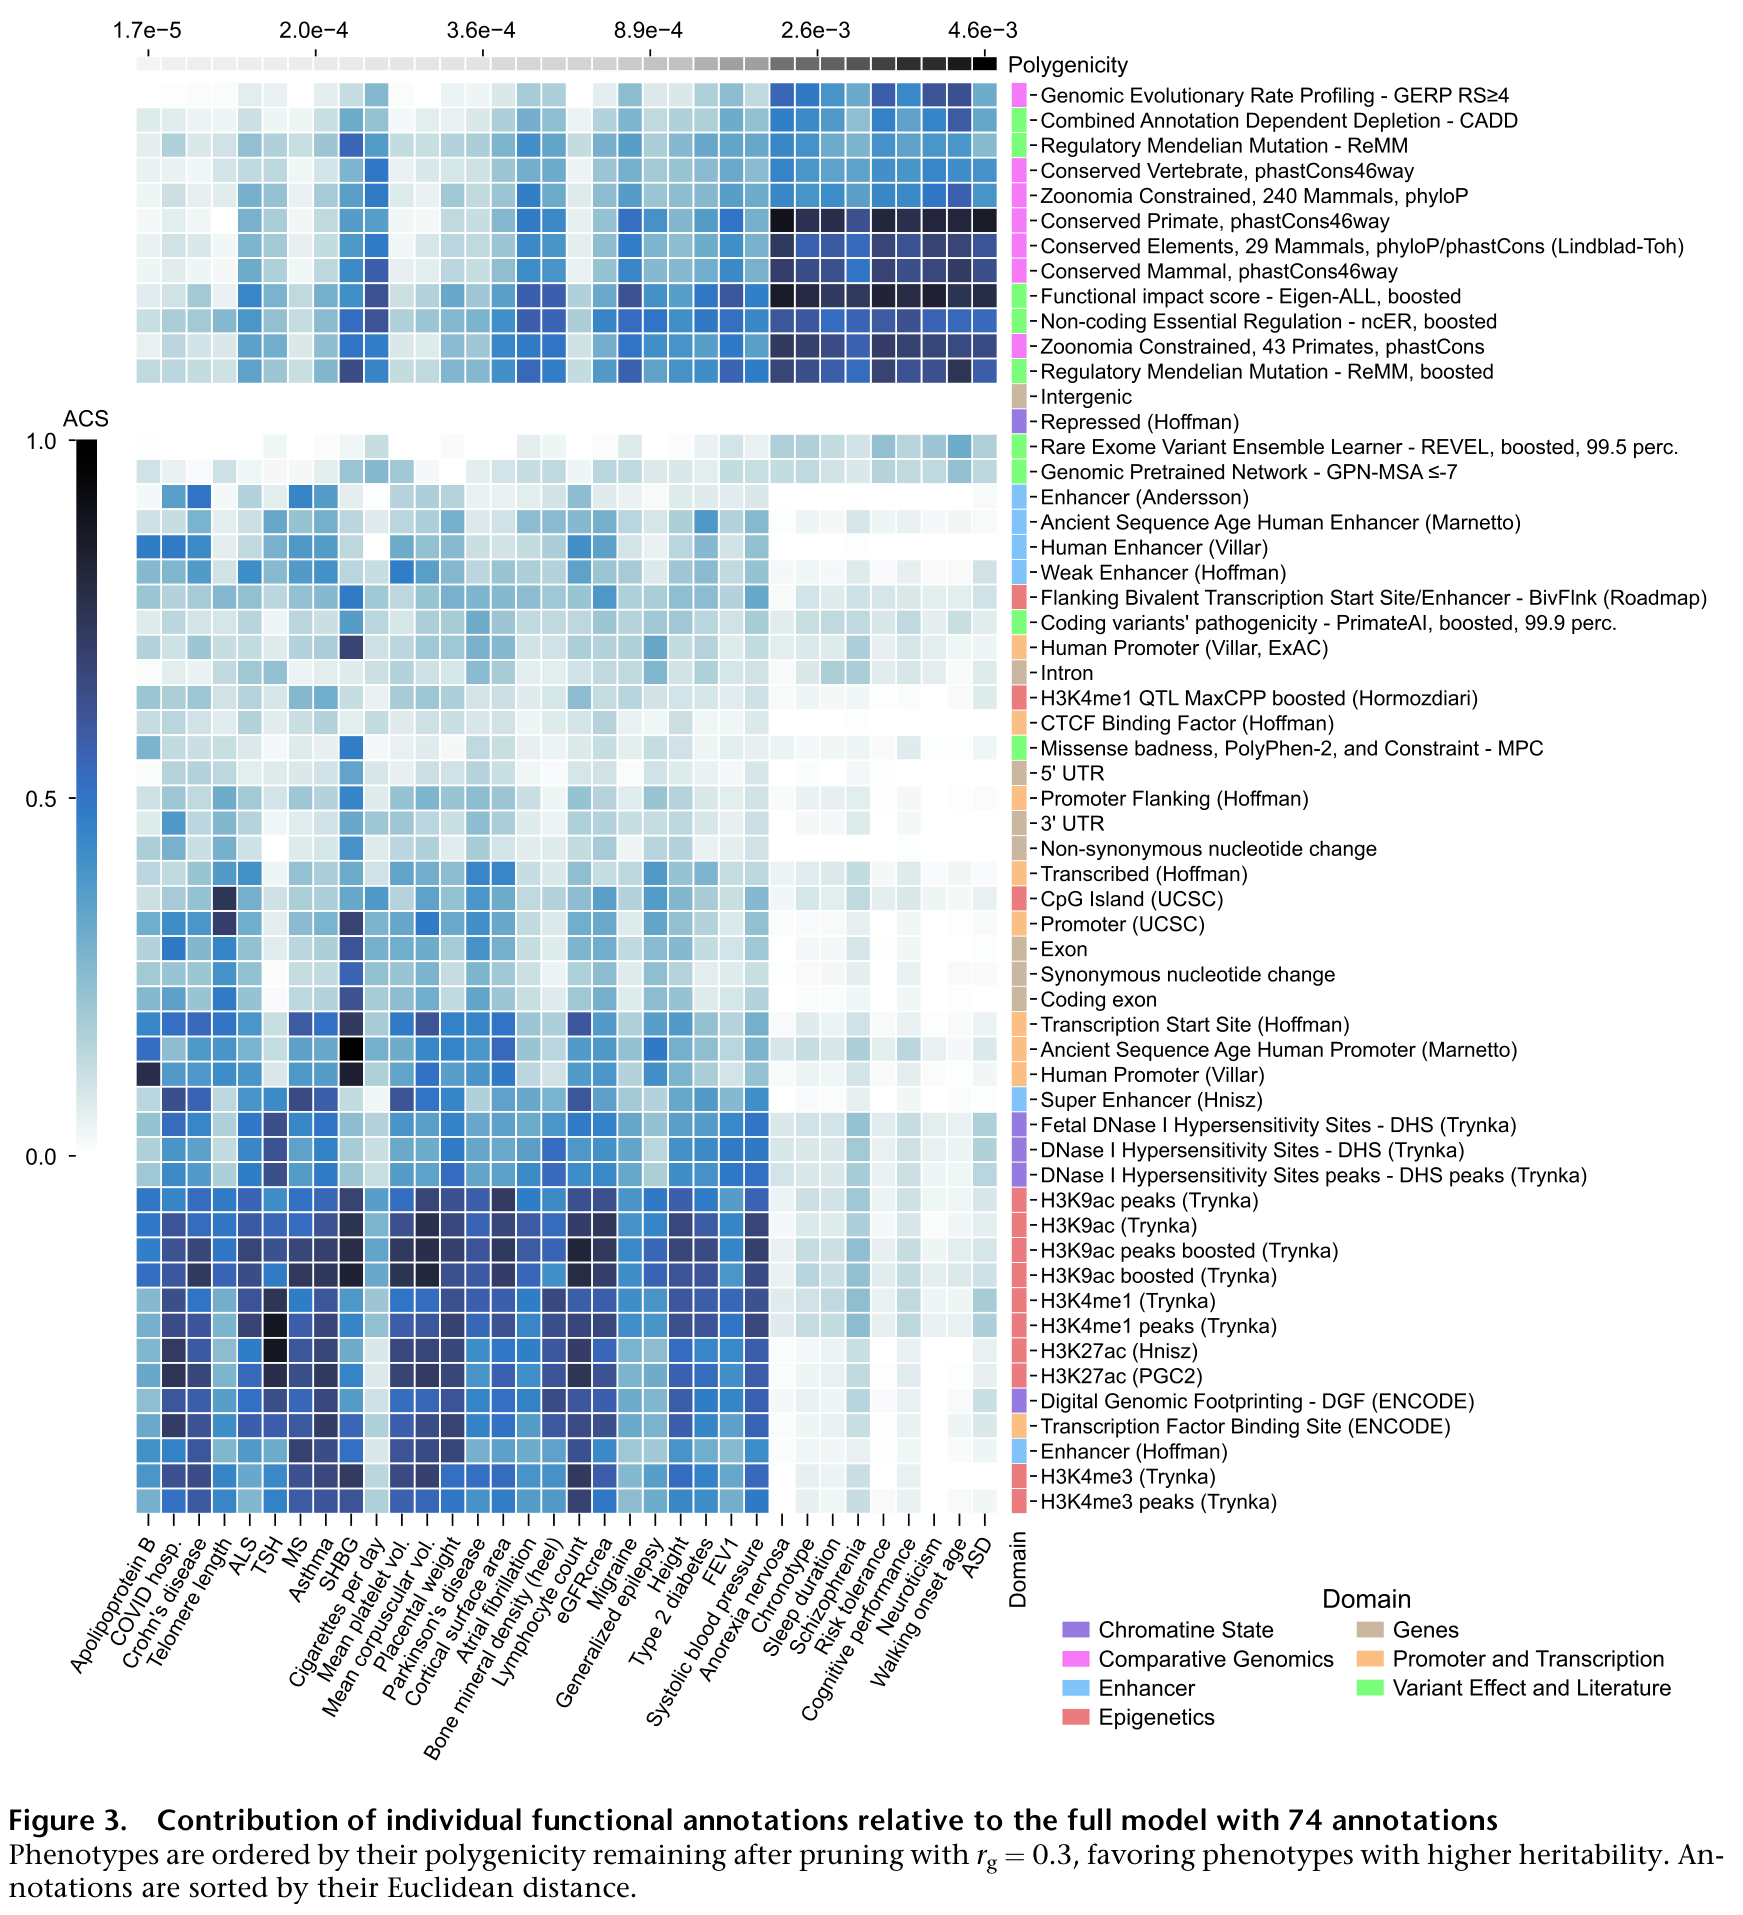
列为按多基因性排序的性状,行为注释,颜色是 ACS。高多基因性性状更突出保守性与变异效应注释。ACS 不是遗传力占比;重叠注释可同时取得高分。
Fuhrer et al., AJHG (2026), Figure 3 · CC BY 4.0 · 原图未修改 · 原文图 · 放大比较、敏感性分析与解释边界
本文的主要价值是把跨性状多基因性、区域遗传力和注释拟合贡献放到同一个分析中;它没有开展 fine-mapping 方法的准确率或 PIP 校准竞赛。正文报告:sLDSC 与 sLD4M 遗传力份额相关 ;MiXeR 与 sLD4M 多基因性排序的 Spearman ;无穷小与非无穷小注释模型 ACS 的 Pearson 。非无穷小敏感性分析是在固定遗传力分布后拟合 ,不能理解为完全不受主模型结构约束的重复分析。详细补充图本次未获取。
首先,这是性状间的相关性分析。负选择、细胞上下文复杂性和远端调控是作者提出的机制解释,本文没有通过实验或识别设计证明“多基因性增加导致遗传力转移”。三个区域份额总和为 1,本身存在组成约束;外显子与基因间区的负相关也不是一项独立因果证据。
其次,欧洲祖源 GWAS 与较小 LD 参考限制了跨祖源外推;剔除高遗传相关性状减少重复信息,却不保证剩余性状完全独立。二元化、跨组织合并及非负可加方差模型会压缩连续功能差异,也不能确定具体细胞类型、靶基因或作用通路。正文还指出 X 染色体注释覆盖不完整。最后,GWAS Catalog 注释在敏感性分析中取得最大的拟合改善,但它可能与输入 GWAS 循环使用证据,作者因此没有将其纳入主要结论。
对功能先验的启发(方法推论)
这项结果支持一个值得检验的方向:功能先验不必对所有性状使用完全相同的注释权重,可以按性状学习保守性、启动子或细胞类型注释的组合。但 ACS 不能直接归一化成 SuSiE 的 SNP 先验概率:它是注释层面的边际拟合贡献,包含重叠信息;拟合得到的效应方差也不能自动等同于非零效应概率。
若要延伸为方法,需要用独立染色体或独立队列学习权重,明确注释改变的是非零概率还是条件效应大小,再在未用于训练的数据中比较校准、可信集覆盖与大小,以及预测表现。特别是 GWAS Catalog 或其他 GWAS 派生注释,必须控制信息泄漏。本文提供了性状间功能结构不同的证据,尚未证明这种自适应先验会改善 fine-mapping。