FM-GPT:局部 GReX 引导的多表型基因精细定位
FM-GPT: Bayesian fine mapping for phenome-wide transcriptome-wide association studies
在每个候选位点内联合建模遗传预测表达、潜在表型因子和混合类型结局,用基因及基因–因子两层选择产生基因 PIP。UKB 皮层厚度与 EHR 应用展示候选集缩小,但因子数错设的模拟明显失去 FDR 控制;因子方向、筛选步骤与比较方法的输入转换需要单独解释。
本文目录
从相关的 TWAS 信号到多表型基因选择
TWAS 中,一个基因的遗传预测表达与性状显著相关,并不意味着它就是该位点的作用基因:同一 LD 区域内的预测表达可能高度相关,多个基因因而同时出现信号。FM-GPT 进一步面对多个相关表型,试图利用它们共享或不同的遗传结构,在局部候选基因之间进行选择。GPT 在这里是 Genes、Phenome-wide、Transcriptome-wide 的名称缩写,与语言模型无关。正式版正文
分析单位是一个候选基因组区域,而不是一次拟合整个基因组。作者先逐表型做 TWAS,再用 Fisher 合并结果筛选候选区域,按 LDetect 的 LD 区域组织后续分析。正文特别说明,Fisher 步骤只是筛选,不承担最后的显著性判定或错误率控制;作者也提出可用对相关检验更稳健的其他合并方法替代。因此,筛选得到的极小合并 p 值不能直接解释成最终基因定位证据,也不能据此声称整个“筛选+定位”流程已经获得选择后频率学保证。
三层模型:参考表达、局部因子与观察表型
以一个区域内的候选基因为例,参考样本中的表达回归写作
其中 为该基因的 cis-SNP 基因型, 为预测权重。在 GWAS 队列中,用 得到 GReX。模型允许用参考个体数据估计权重,也允许直接使用既有预测权重;实际 UKB 分析使用 GTEx v8 的 PredictDB 模型。使用固定的外部权重不等于完整传播其估计不确定性,应与联合训练的理论框架分开理解。
第二层把局部 GReX 与第 个潜在表型因子联系起来:
第三层以较少因子解释多维结局。在连续结局下,可用矩阵形式概括为
其中 描述基因到因子的关系, 描述因子到表型的关系;主文采用对角的表型残差协方差,并用额外模拟考察相关残差。离散结局则需要下文的数据增广,不能直接当作同方差高斯响应。Methods,Model of FM-GPT
因子和载荷按位点分别估计。 因子 1 在两个位点不必具有同一含义。正文将这种设计描述为因子空间受局部 GReX 张成空间约束,但其式 (2) 同时保留了非零残差 ;因此,按所写方程,直接受 GReX 约束的是条件均值,不能不加区分地把整个 写成严格的无残差线性组合。这是原文表述与方程之间需要保留的区别。
选择基因、选择基因–因子关系,以及收缩载荷
参考表达层对 SNP 权重使用 spike-and-slab 先验。基因到因子的效应使用两个选择指示变量:
控制基因层面的入选, 决定该基因是否影响某个因子, 承载非零效应。这样既允许一个基因影响多个因子,也允许不同因子具有不同候选基因。它不同于只在所有性状上强制共享一套非零效应。
载荷 则用乘积 gamma 收缩结构:随着因子编号增加,整体收缩通常加强,同时保留局部收缩。这里是连续收缩,不产生严格零点质量。补充方法 S4 在每次 Gibbs 迭代中将一个因子的载荷向量按欧氏范数归一化,随后用后验中位数汇总,再将很小的载荷阈值化以便解释。展示中的零载荷不是经过单独错误率控制的“无作用表型”判定。S4 Methods
因子数也不是完全无须选择的自动参数。S5 描述在 Gibbs 内自适应增加或删去因子,保留规则受小载荷阈值等设置影响,并建议结合位点特异 trace plot、载荷图、表型相关图和 scree plot。皮层厚度应用最终采用一因子,EHR 应用采用三因子;后者主要依据探索性诊断选择。S5 Methods
混合结局:Pólya–Gamma 增广不是把诊断编码变成高斯真值
对于二分类和以负二项分布表示的计数结局,作者引入 Pólya–Gamma 辅助变量,使自然参数的条件似然呈高斯核,从而嵌入 Gibbs 更新。伪响应可写成
其中二分类的 ,负二项计数的 。关键是条件于辅助变量之后的似然表示,不是对离散观测做一次确定性变换就获得边际高斯变量。主文还列举 multinomial 结局,但主要模拟与 EHR 实证集中在连续、二分类和计数,不能把所有分类结构都视为获得了同等验证。
补充 S6 给出了采样更新,并额外引入响应随机效应和协方差记号;其写法并非主文三层方程的逐字重述。本解读保留主文模型及增广含义,没有把补充公式重新拼成一套已验证的可运行采样器。论文的“支持混合数据类型”也不代表它建模了 ICD 诊断误分类、随访时长或医疗利用过程。Methods 与 S6 Methods
基因 PIP 与 BFDR 的范围
作者检验的是一个基因是否至少对一个因子有非零效应:
对于根据 PIP 选出的集合 ,其后验期望错误发现比例为
正文跨被检验区域汇总基因并筛选。两个实证使用 BFDR 0.15,模拟的名义门槛为 0.1。这些门槛不能互换,也不能把基因 BFDR 0.15 说成 SNP 的 85% credible set。它依赖局部模型、候选集与先验;与对频率学 p 值实施 BH/BY 校正的含义并不相同。
模拟中的优势及因子数错设的明显代价
模拟使用 250 个参考样本和 5,000 个 GWAS 样本,设置 10 个区域、每区 10 个基因、每基因 10 个贡献表达信号的 cis-SNP;不同基因的 SNP 集合不重叠。50 个表型由 1、3 或 5 个因子生成,表达介导的表型变异比例设为 1%、3%、5%,并区分所有因子共享因果基因与因子间因果基因不同两种情况。每种模拟重复 100 次;另外用 1000 Genomes 单倍型及 HAPGEN2 构造更真实的 LD。S1 Methods
在作者测试的设置中,FM-GPT 的排序表现和错误率控制通常较好;部分对照方法的高功效伴随明显的实际 FDR 膨胀。但是,生成模型本身具有低秩的表达–因子结构、每基因 cis-SNP 不重叠,这些设置不能覆盖所有共享调控、多效性或强 LD 场景。
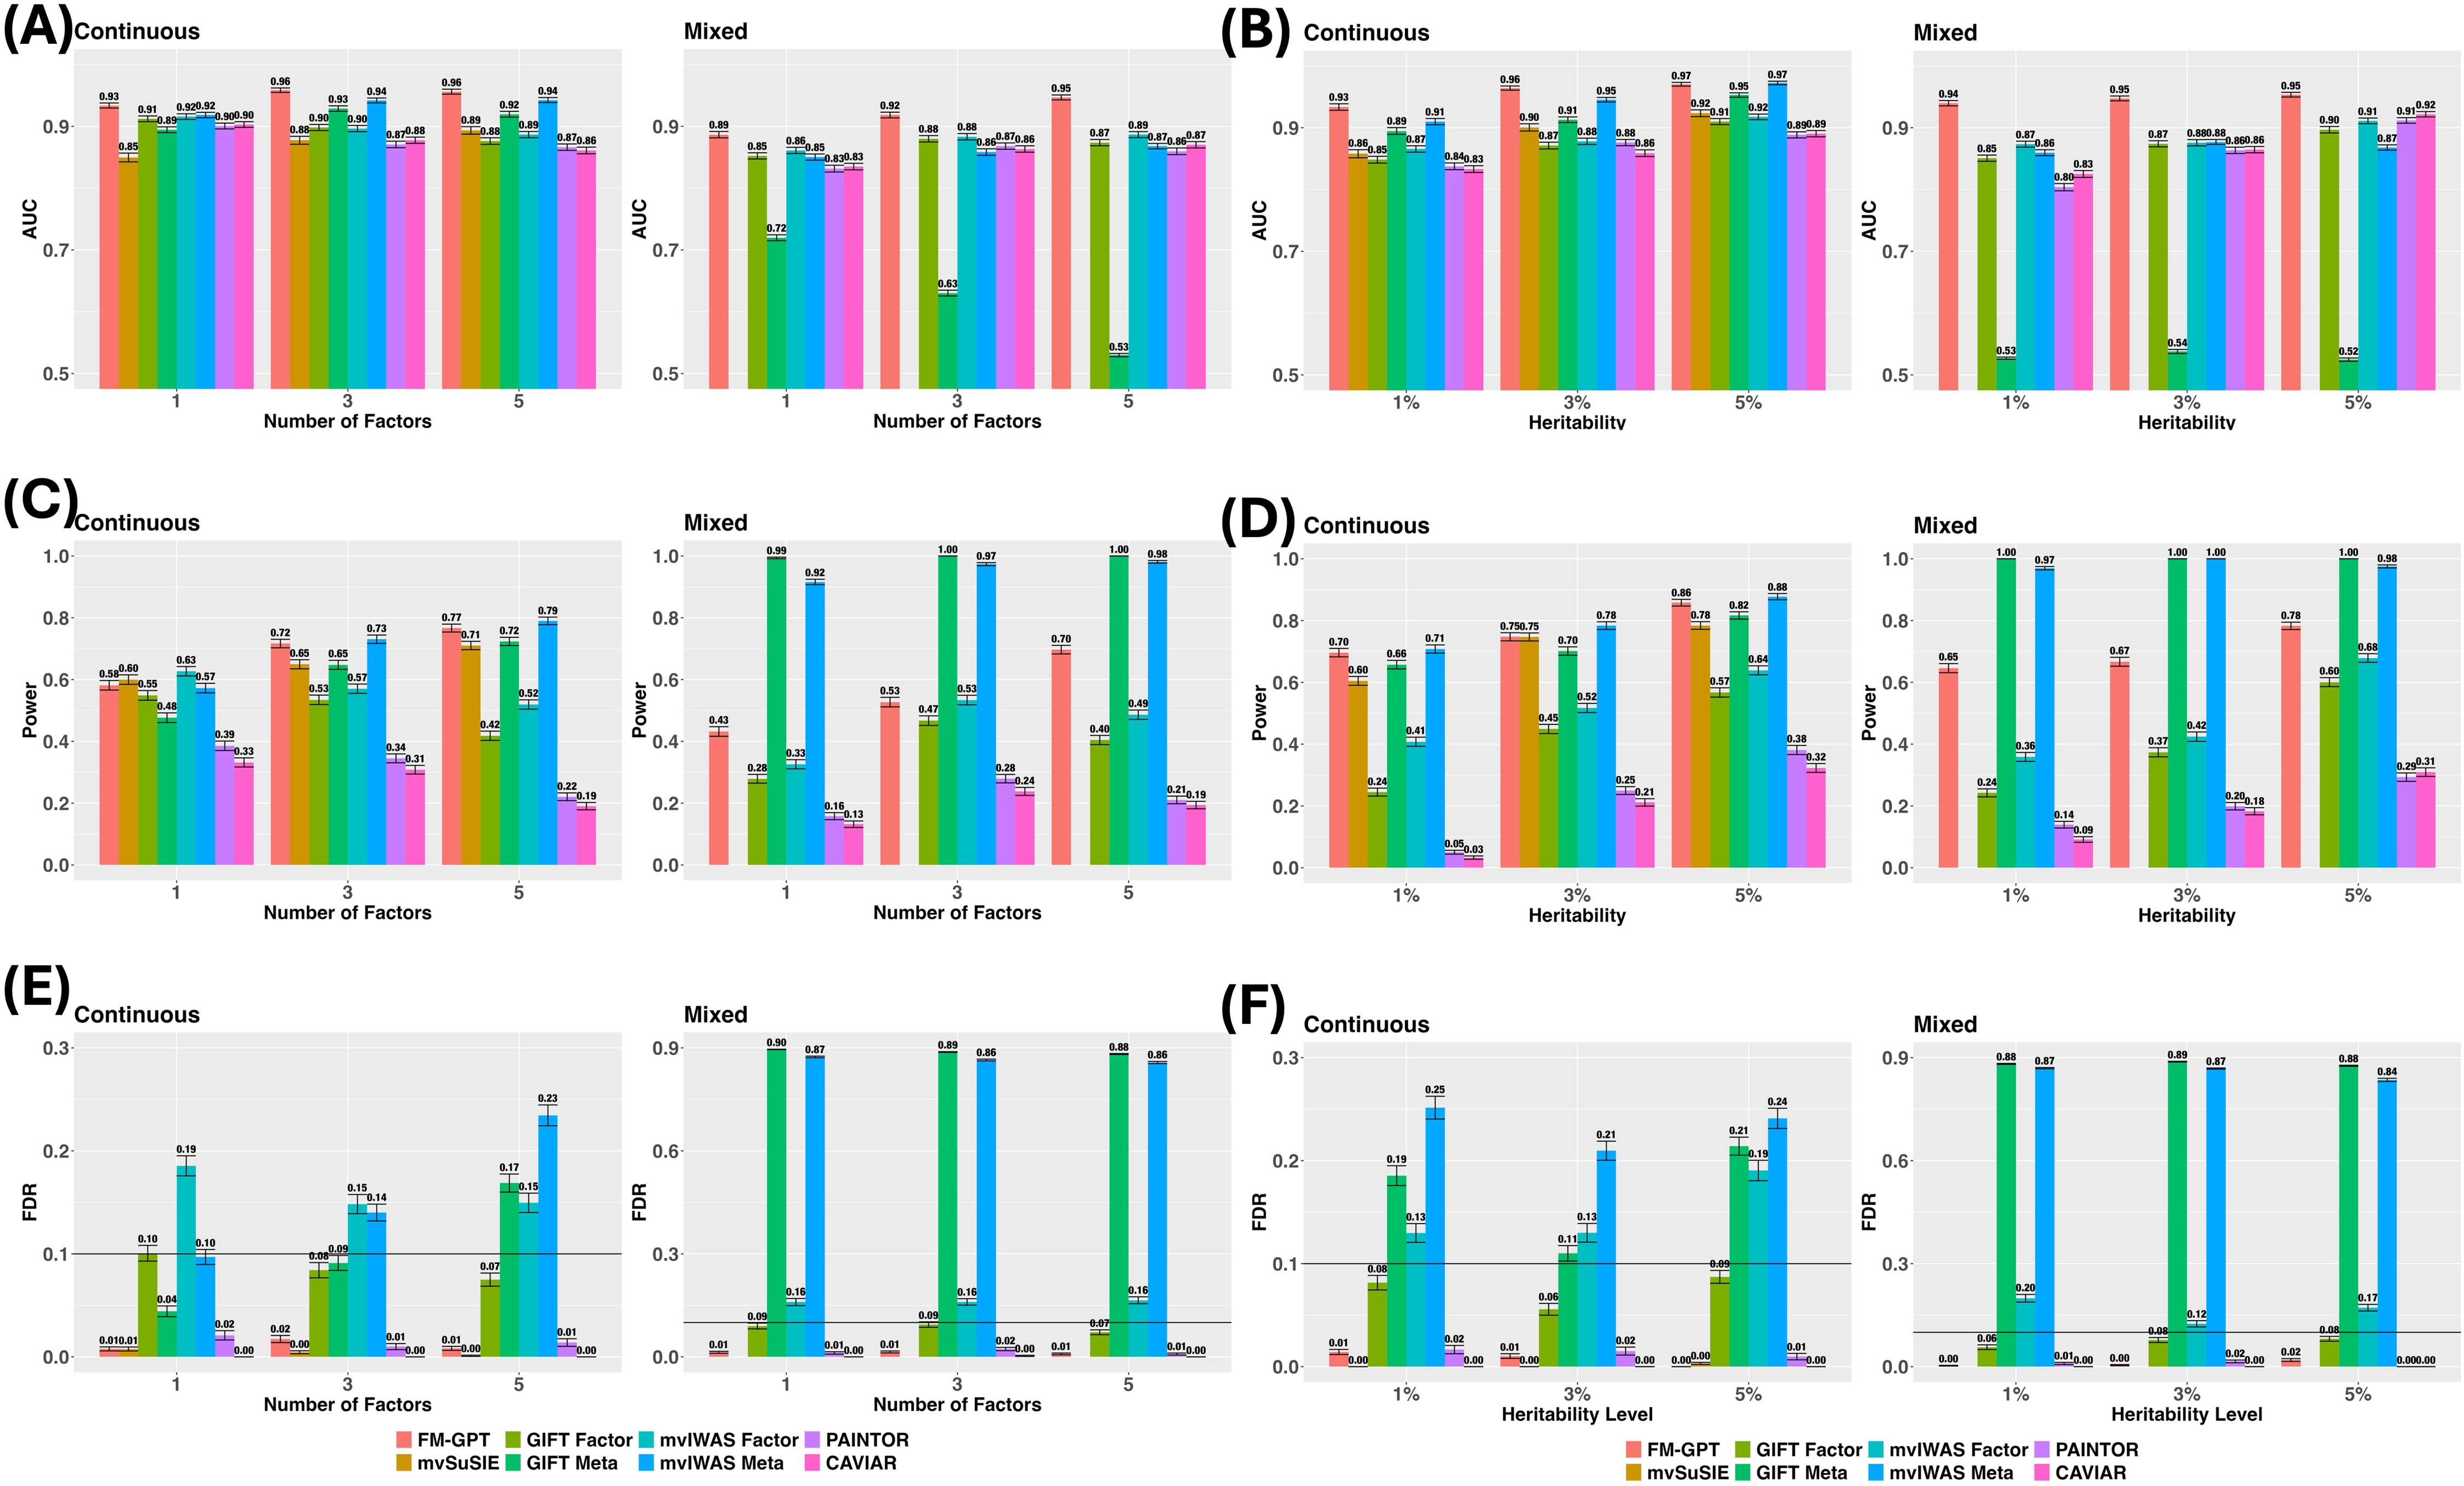
A–B 为 AUC,C–D 为名义 FDR 0.1 下的功效,E–F 为对应实际 FDR;连续与混合结局分面展示。高功效必须与同一设置的 FDR 一起看。PAINTOR/CAVIAR 的输入经一因子压缩,并用基因内最大 SNP PIP 映射到基因,不能把所有柱形视为完全相同的基因层面推断任务。
Canida et al., PLOS Genetics (2026), Figure 3. · CC0 1.0 · 原图未修改 · 原文图 · 放大比较实现尤其重要。GIFT/MVIWAS 分为先做因子分析和逐表型后合并两类;后者用 Fisher 合并相关表型的 p 值。mvSuSiE 在连续结局下直接以预测表达为变量联合分析。PAINTOR/CAVIAR 则先把表型压到一个因子,限制最多两个因果变异,再取基因内最大 SNP PIP 作为基因分数。最大 SNP PIP 不是“至少一个 cis-SNP 有效”的后验概率;因此这些比较不能直接用于判断 SNP fine-mapping 方法在原生任务上的优劣。FOCUS/FOGS 因作者的实现未在合理时间内完成,没有形成完整的性能比较。S2 Methods
最实用的敏感性结果在 S2c:真实因子数为 3 时,自适应估计的报告 AUC/功效约为 0.99/0.99;强制拟合为 1、5、10 个因子,FDR 分别升至 0.31、0.44、0.58。S2d 中,病例比例降到 1% 后,FDR 仍低,但功效降至 0.47,并非方法能免除病例不平衡导致的信息损失。这两项结果比笼统的“对混合表型稳健”更能指导使用。S2 Table,已核查原始单元格
UKB 皮层厚度:候选减少,不等于真实特异度已知
实证包含 26,124 名无亲缘且数据完整的参与者、66 个皮层厚度表型,调整年龄、性别、BMI 和前十个遗传主成分。作者使用 GTEx 的 13 个脑组织做 TWAS,Fisher 筛选得到 760 个基因信号,进入 355 个候选区域,再采用一因子模型定位。
作者在 BFDR 0.15 下报告 18 个候选基因,对照 mvSuSiE、GIFT、MVIWAS 分别报告 25、164、174 个。染色体 17 上包括 BCAS3、LRRC37A、NOS2P3、ARL17B 和 UBB。S5 表将这五个基因分配到多个区域,并非一个共同 LD 区块;不要由染色体相同推断共享一个局部因子。作者描述相关载荷涉及 46 个脑区,提示广泛的皮层厚度关联结构,但没有提供功能干预来证明这些基因的表达介导作用。
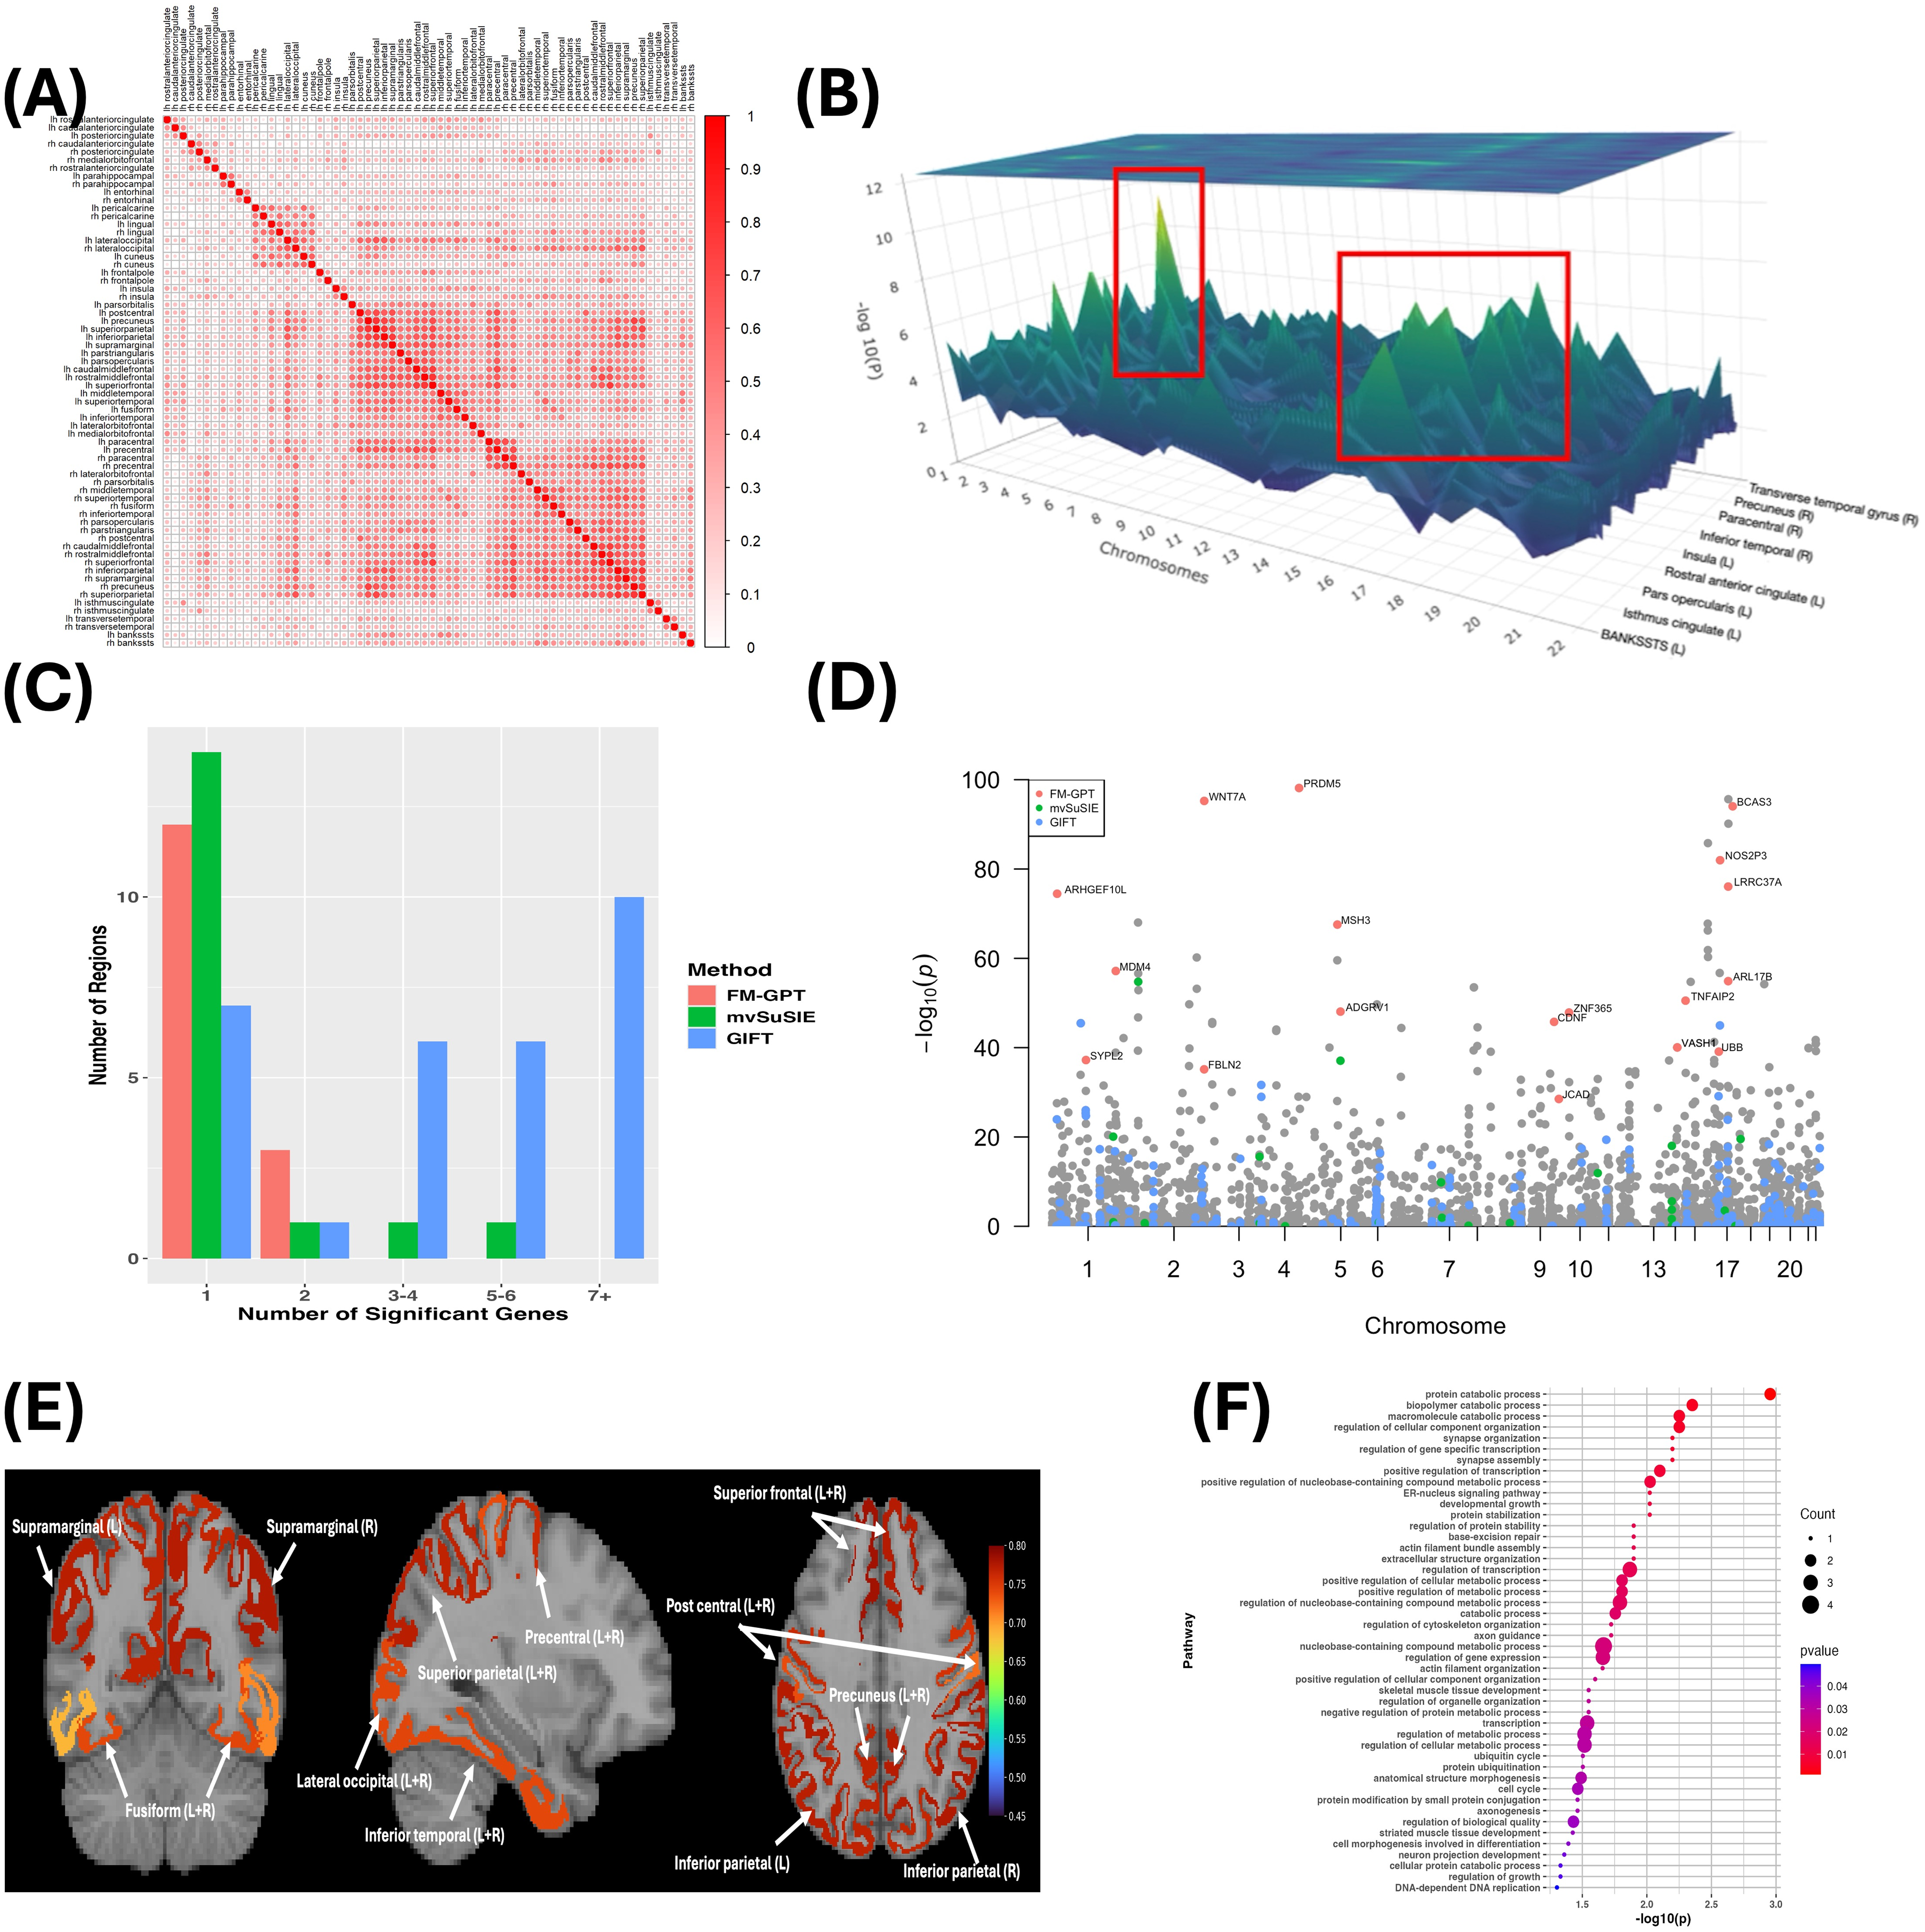
A 为脑区表型相关,B 为 TWAS 信号;C 的纵轴是区域数而非百分比;D 在 Fisher 合并信号上标注不同方法的候选;E 展示较大因子载荷对应的脑区;F 为名义 p<0.05 的通路结果。候选数减少与更强的边际信号都不是独立因果验证,通路 p 值也不是基因筛选所用的 BFDR。
Canida et al., PLOS Genetics (2026), Figure 4. · CC0 1.0 · 原图未修改 · 原文图 · 放大计数还存在应保留的源文差异:正文写 18 个基因、16 个区域,Table 2 的区域分组相加为 15;S5 表存在重复的 VASH1 行,BFDR 列又经舍入,采用严格小于或小于等于 0.15 并去重会得到不同结果。这里沿用“作者报告 18 个”的口径,没有把候选集减少比例当作经过独立复核的真实特异度增益。图中通路结果是名义 p<0.05,也不等同于上述基因 BFDR。Table 2 与 S5 Table
EHR 表型:三因子模型与两种主要载荷模式
作者从 245,687 人的 EHR 提取 19,190 个 ICD-10 编码,归并为 1,403 个表型,筛选后保留 169 个。主文概括为患病比例筛选;更具体的 S3 区分二分类表型至少 1% 病例与计数表型的非零计数要求,筛选后为 15 类疾病。不能把全部计数表型也写成采用完全相同的 1% 阈值,或把这些代码聚合计数直接解释成疾病严重度、复发次数。S3 Methods
TWAS 使用 50 个 GTEx 组织,再选择至少有一个基因达到 p<10⁻⁶ 的 39 个表型,在 297 个候选区域中进行三因子分析;最终在 BFDR 0.15 下报告 60 个候选基因。因结局类型混合,mvSuSiE 没有完成这一应用,因此不存在完整的混合结局头对头胜负比较。
Figure 5 的热图选择每个基因对应的主要因子,用其表型载荷概括不同疾病系统的关联,呈现心血管–炎症和代谢–肝胆相关的两种主要模式。这是三因子分析结果的可视化概括,不是一个两因子全基因组模型,更不是每个基因对每种疾病的完整条件效应矩阵。
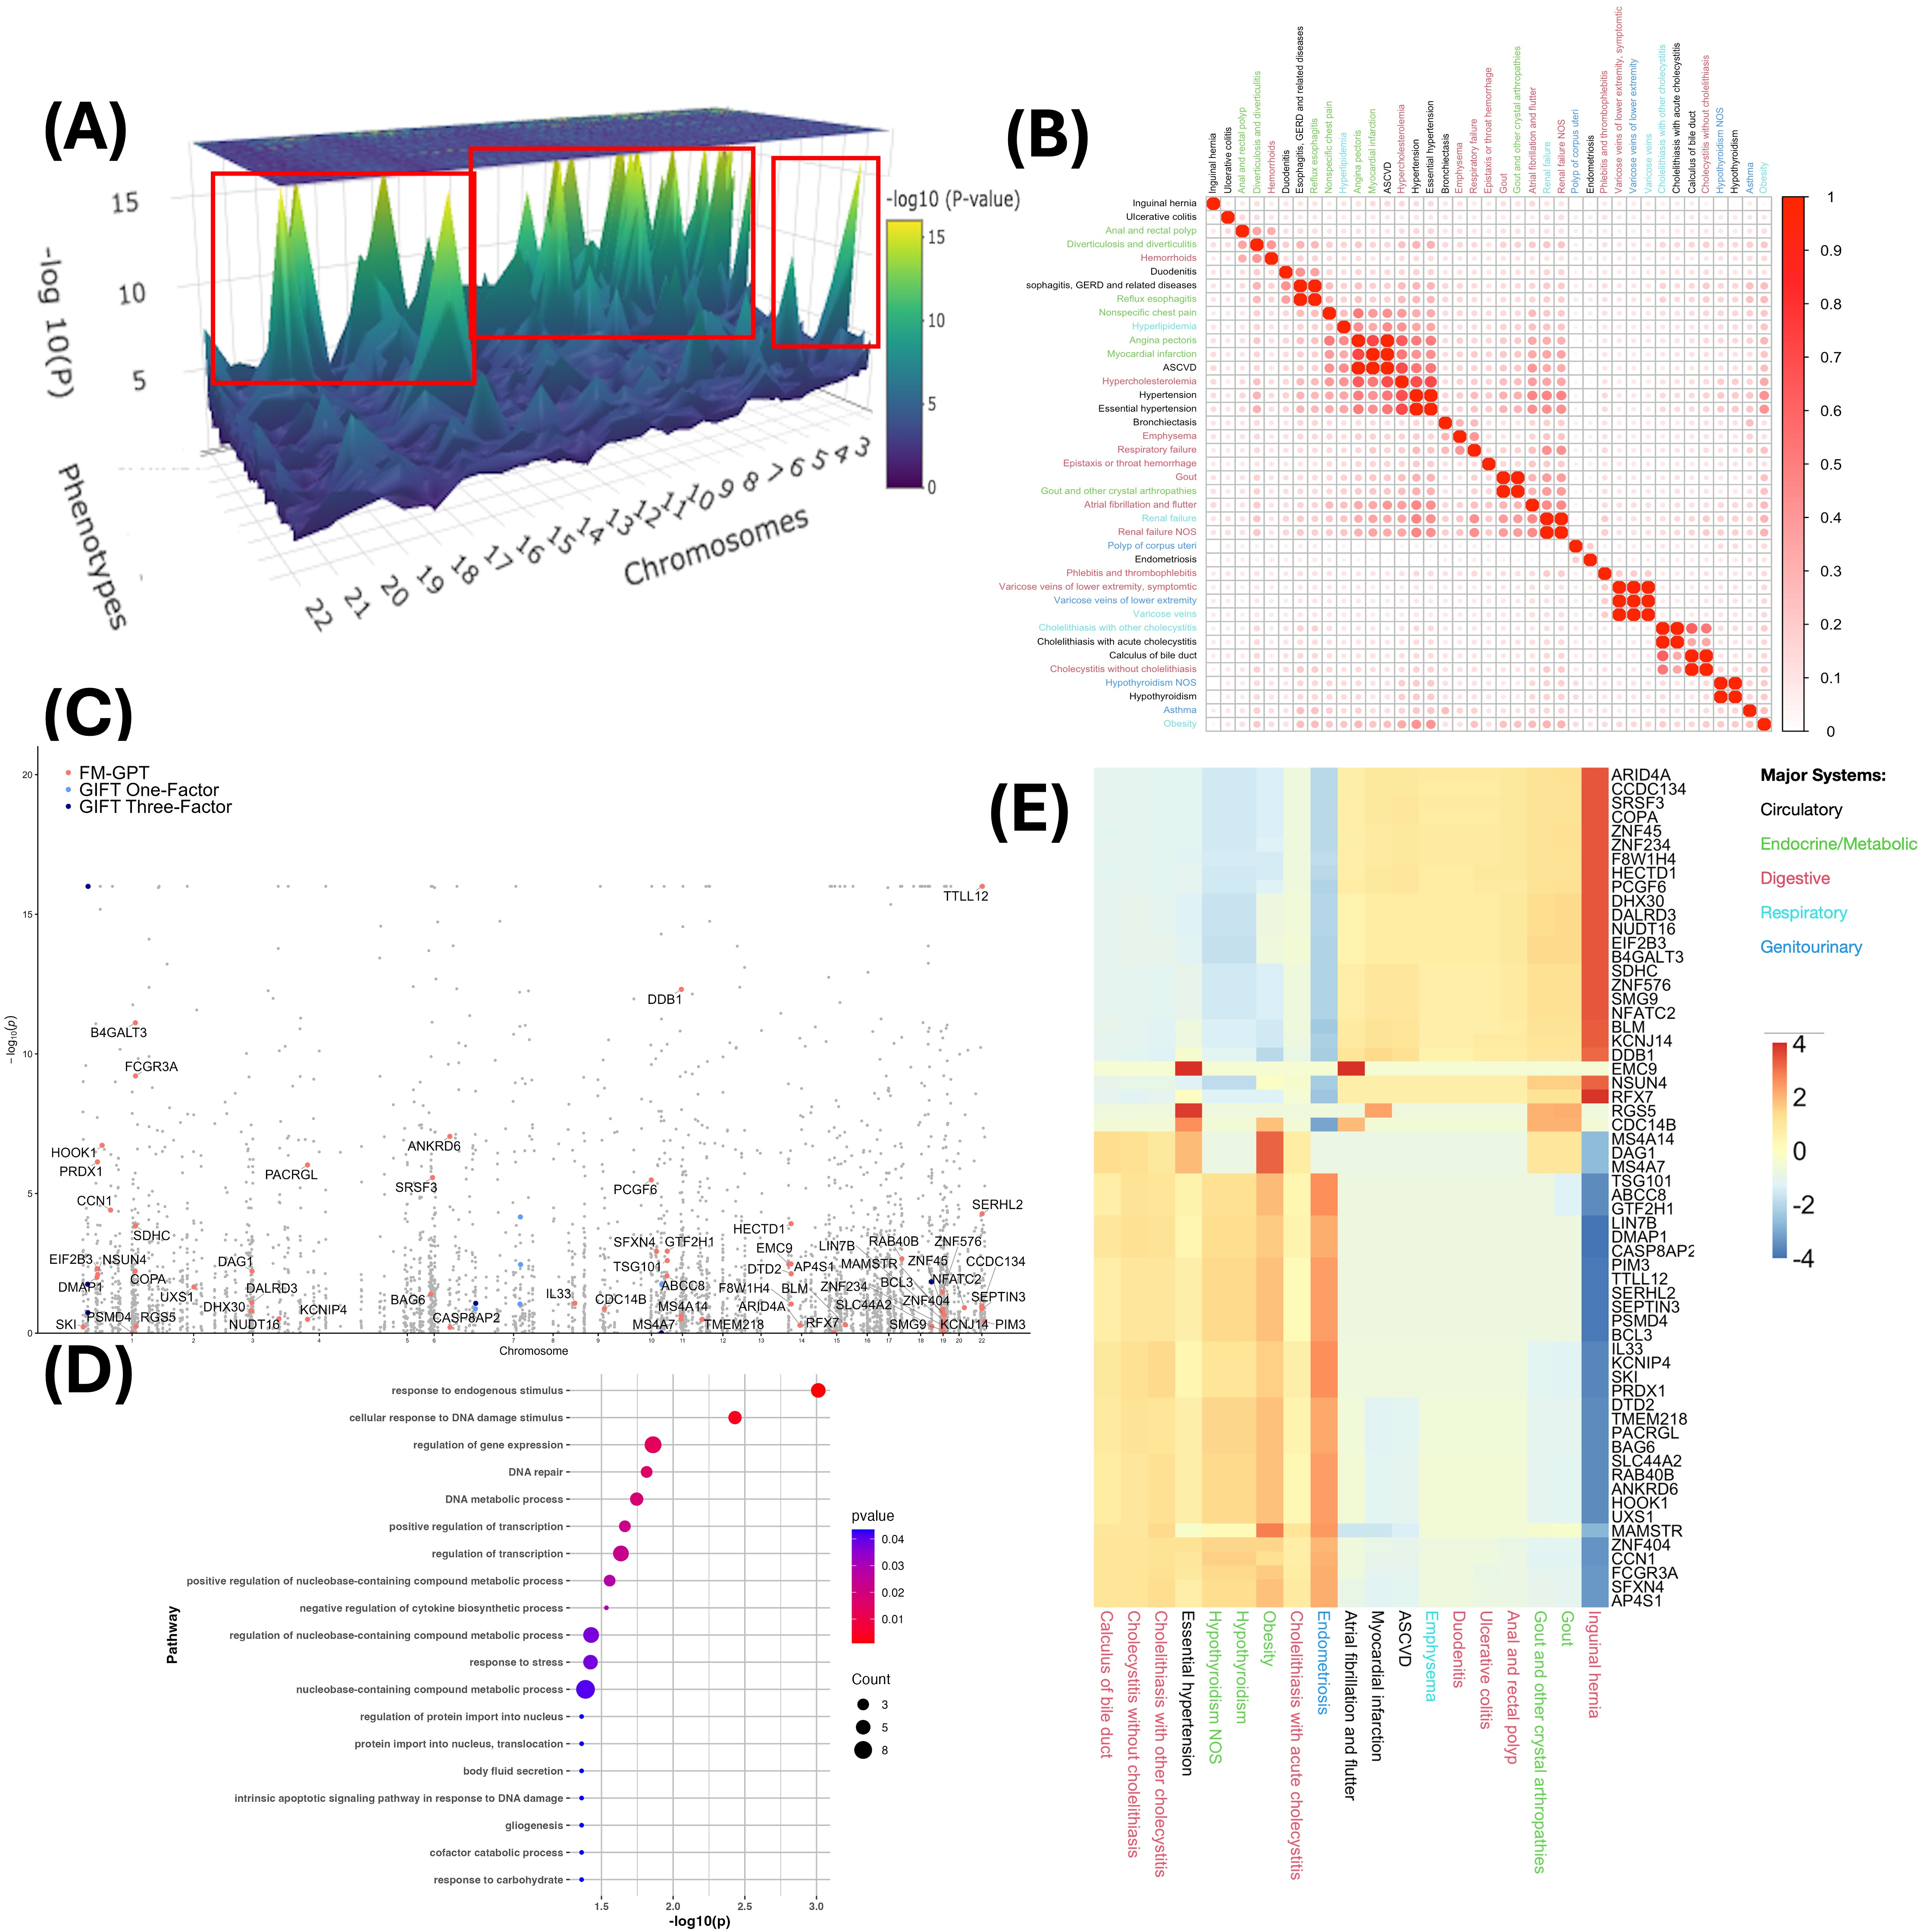
E 仅用每个基因对应的主要因子概括表型载荷,不是完整基因–表型效应矩阵,也不是风险比。分析采用三因子模型,热图中概括出的两种主要模式不代表模型只拟合两个因子;不同位点的因子与符号不能未经对齐直接当作统一生物轴。
Canida et al., PLOS Genetics (2026), Figure 5. · CC0 1.0 · 原图未修改 · 原文图 · 放大作者将这种模式解释为潜在的免疫–代谢权衡,但同时承认因子方向的任意性。不同位点分别拟合,再选择主要因子,意味着跨位点的符号、尺度和因子编号不能未经对齐直接比较。因此,这一部分适合作为可检验的生物学假说,不足以证明相反方向的因果效应或能量分配机制。
可复用的方法思路与阅读范围
最有价值的是 局部、多表型、低秩且允许异质效应的变量选择框架。它与 mvSuSiE 的对照重点在如何借用表型间信息、怎样表示低秩结构和混合结局,而不是把基因 PIP 与 SNP PIP 放在同一阈值下直接比较。作者提出将框架扩展到其他分子 QTL、组织或细胞特异调控、表型间有向依赖、summary statistics 和变分推断;这些仍是未来方向,不能算作现有软件已经验证的功能。
本页依据正式发表的 HTML/XML、主图及补充方法 S1–S6,并核查了 S2 敏感性表和 S5 定位表的相关字段。期刊 PDF 下载端点本次返回 404,但 HTML/XML 正文和补充 PDF 可读;没有以摘要替代正文。尚未重跑作者 R/Rcpp 软件、审计全部采样公式或逐项核对所有补充表,故不对后验覆盖率、运行速度或外部复制做超出论文证据的承诺。