MILK:atlas 规模单细胞层级树
Global tree encoding of atlas-scale single-cell genomics
MILK 通过分区顺序分组、代表更新与递归合并,把已有单细胞表征组织成可重复抽样和汇总的层级树。胎儿图谱实验支持无标签代表抽样的信号保留;Census 约 4,400 万细胞的应用展示其规模,但未报告完整建树时间与峰值内存。
本文目录
阅读材料为用户提供的 98 页 bioRxiv v1 PDF,包含主文、内附补图及 Methods。本次重点核对关键算法、结果与相关补图,未逐一复核所有补图面板,也未复跑 Zenodo 分析结果;论文尚未同行评议。
MILK 的主要贡献是把已有细胞表征组织成可以反复查询、抽样和汇总的层级树。它不训练新的 foundation model,也不直接消除批次效应。对算法设计最有价值的部分,是分区递归压缩、保留代表与未抽中细胞的对应关系,以及怎样利用这些关系支持后续计算。本文对代表性抽样有实证支持,但“44M 细胞规模”“无损保留信息”“改善疾病推断”需要分别理解。
分区顺序扫描怎样形成全局树
输入为每个细胞的向量和距离函数。人类胎儿图谱使用 100 维 PCA 与余弦距离;Census 的主要展示使用预先计算的 Geneformer/scGPT 512 维或 scVI 100 维嵌入,以及欧氏距离。
一次局部分组按输入顺序扫描:首个细胞建立一个组;后续细胞与现有代表逐一比较,若存在距离不超过阈值的代表,就加入最近的一组,否则建立新组。遍历结束后更新代表,再对各组代表重复这一过程,直到只剩根节点。因此,single-pass 指一轮分组中的扫描,完整树需要许多轮递归。
阈值来自距离分布的极低分位数,每轮随代表集合更新。Results 将其概述为抽样近似的全局距离分位数;Methods 1.2 对大数据实现的具体描述是:在多个分区分别求指定分位数,再取最小值作为共享阈值。两者不能严格视为同一分位数估计。Census 的“0.01 percentile”相当于累计概率 ,不是第 1 百分位。
每个分区独立执行上述分组;汇总代表数低于用户设定上限时,再对跨分区代表分组,否则本轮只拼接结果。这避免构建全数据两两距离矩阵,但也引入近似:分区边界限制本轮可以形成的组,且本文按 dataset 排序输入。作者允许打乱顺序,却未提供充分的跨排序、分区大小与阈值扰动稳定性分析。
文中把更新后的代表称为 medoid,但 Methods 的实际定义是“最接近 centroid 的对象”;它通常不能直接等同于最小化组内全部距离和的严格 medoid。代表数低于缓存上限后,较早层级的代表进入缓存,参与以后各轮的质心计算,减少仅凭当前少数代表更新造成的信息丢失。缓存仍是近似,不能假设它完整携带所有原细胞的充分统计量。
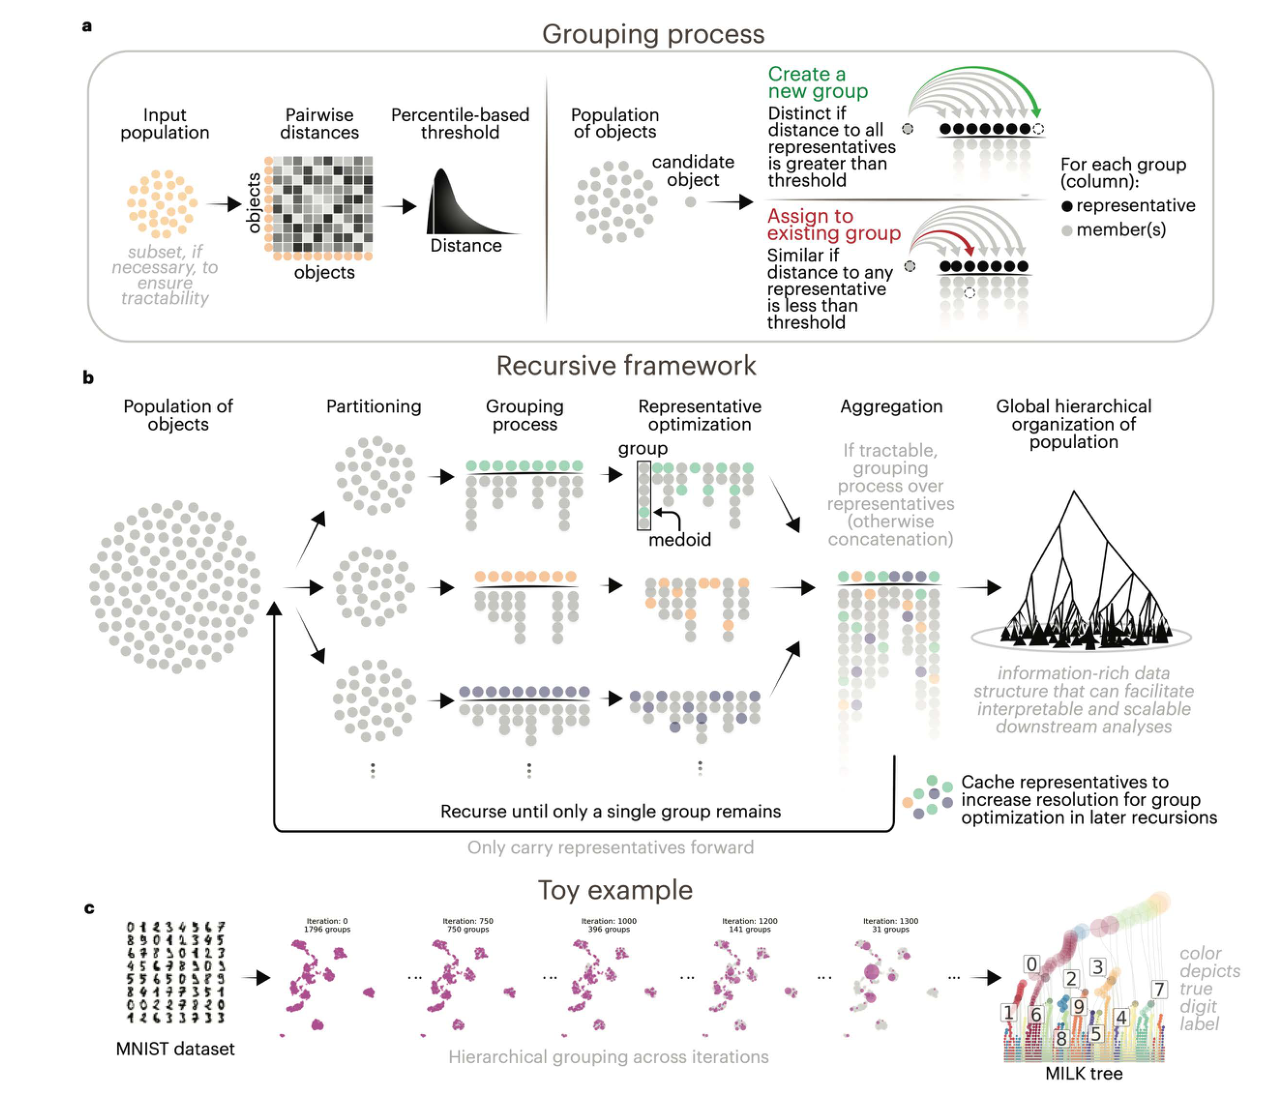
分组与递归建树。A 展示以距离阈值决定建立新组或加入现有代表;B 展示分区并行、代表更新、条件性跨分区合并及缓存;C 为手写数字示例。图中每条树边代表算法分组合并,不能解释为生物谱系。
Brett Kiyota et al., bioRxiv (2026), DOI: 10.64898/2026.08.31.747971 · CC BY 4.0 · 原图未修改 · 原文图 · 放大可扩展性证据主要是比较次数
MILK 以 Julia 实现,分区可并行处理并支持 out-of-core,即不必在同一时刻把完整嵌入载入内存。作者在补图 2.1f 画出不同胎儿器官数据的总距离比较次数与细胞数,观察到明显低于二次增长的经验趋势。
这不等于给出了任意输入下的线性时间保证。按算法描述推算,若分区大小为 、表征维数为 ,一轮中每个细胞最坏需比较约 个代表,仅局部分组成本就可达 ,还要加阈值估计、质心更新、跨分区合并与多轮递归的成本。这是对伪代码的复杂度解释,并非作者证明的总复杂度定理。
上传全文未报告完整 44M 建树的 wall-clock、峰值 RAM、CPU 型号/核数,也未给出同硬件下与其他大规模 sketching 或层级算法的时间、内存对照。论文说明使用 CPU,且部分分析在 SHIROKANE 超算完成。因此可确认大规模数据已实际应用,但无法据此判断普通工作站跑完整 Census 需要多久。
代表性抽样保留了什么
约 400 万细胞、15 个器官、77 个已注释细胞类型的人类胎儿图谱是主要抽样实验。Label-free 策略按树结构选择较早形成、互不重叠的 clade;label-balanced 策略给不同细胞类型近似相同配额,只合并标签一致的 clade,并完整保留低于配额的小类。前者偏好转录上分离明确的稀有群体;后者对已知稀有类别有直接保护,但依赖标签质量。无标签策略还存在最小 clade 大小选择:初始上限为 25,未达到目标数量时逐步降至 10,仍不足再拆分已有 clade。它并非直接对每个稀有细胞计算保留概率的概率抽样设计,也没有为总体丰度估计提供常规抽样无偏保证。非常稀少、连续过渡或表征中尚未分离的状态,并没有普遍保留保证。
作者比较每器官 100–30,000 个代表与随机抽样。随机基线也区分全局随机和按标签均衡随机,各有 10 次重复;MILK 在固定树上为确定性选择,只生成一次。评估用 CollecTRI regulon 的细胞类型内平均信号,以及对应基因表达主成分子空间的相似度,避免将所有细胞混合后由大类主导。
结果的关键差异在是否已有标签:label-free 的 regulon 信号相关曲线 AUC 为 MILK 2.83、随机 2.49;但 label-balanced 两者均为 2.59。协方差子空间指标分别为 4.07 对 3.67,以及 4.32 对 4.31。这里 AUC 是对数抽样比例上的曲线面积,不是分类 AUROC。已有高质量类别划分时,均衡随机抽样已完成相当一部分工作,不能概括为 MILK 在所有情境都大幅优胜。
进一步构建 metacell 时,作者以细胞到代表的距离生成权重,对 clade 内原始计数取加权平均,并非按 donor 求和的常规 pseudobulk。距离越近贡献越大;输入 scVI 前再四舍五入到整数。该汇总提高基因检出率及 regulon 信号保留,但改变了观测单位和噪声结构,不能把 metacell 当新增独立生物重复。
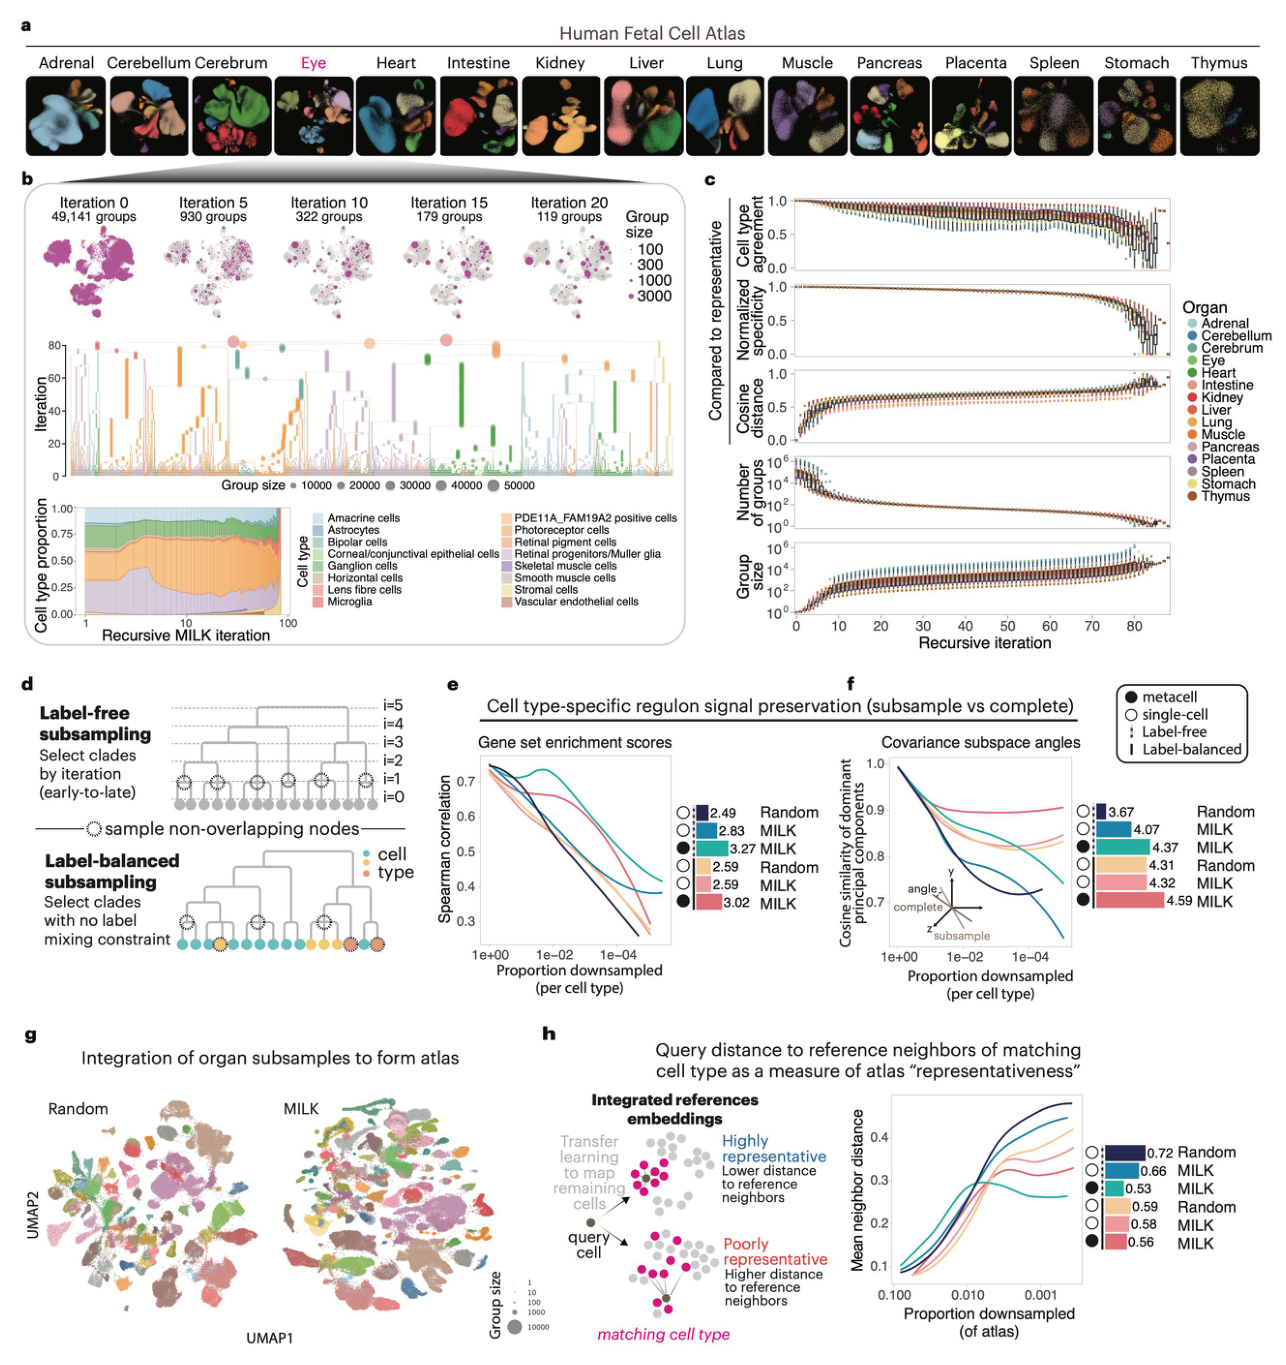
胎儿图谱抽样与信号保留。A–C 为 15 器官的分组和压缩过程,D 区分无标签与标签均衡选择,E–F 比较 regulon 信号和协方差子空间,G–H 评估 scVI 参考图谱及 query 到同类邻居距离。E–F 图旁数字是抽样比例曲线 AUC;已有标签时 MILK 与均衡随机的差异明显小于无标签场景。
Brett Kiyota et al., bioRxiv (2026), DOI: 10.64898/2026.08.31.747971 · CC BY 4.0 · 原图未修改 · 原文图 · 放大由抽样器官训练的 scVI 参考图谱,用 scArches 映射剩余细胞后,同类 8 个参考邻居的平均余弦距离通常更小。此结果支持低成本参考图谱构建;它没有直接验证 donor 层面的差异表达 FDR,也未重新预训练 Geneformer/scGPT 来测量算力或预测精度收益。“节省 foundation model 训练数据”仍属于合理延伸。
44M 的实际分析范围与模型排名
Census 2024-07-01 的原始下载约 7,100 万人类细胞;只保留 primary data 去除重复收录后,Methods 给出 44,265,932 个细胞、369 个数据集、678 个细胞类型、108 种疾病情境。下游又删除没有细胞类型注释的细胞,并要求细胞类型–疾病组合至少 50 个细胞,因此 44M 是 primary data 的总体规模,不应套用于每项过滤后的分析。作者对三类既有模型嵌入分别建树,再选 1 万至 100 万代表;主要比较使用约 100 万代表。这是 44M 输入上的分层组织与抽样后评测,不是重新训练了 44M 细胞模型。
“信息保留率”定义为入选代表及其所辖 clade 覆盖的原始细胞比例。Augmented 分析保留代表原有嵌入,再按 clade 大小加权标签计数;并没有把未入选细胞的所有表达细节恢复出来。因此覆盖率接近 1 和保留约 2.3% 代表,可以同时成立,却不能称为 97.7% 无损表达压缩。
作者先在多个 Leiden 分辨率下计算 ARI、AMI、homogeneity,再组合生物标签得分与批次得分的补数。另一套评估利用树上信息增益:
其含义是在父节点内,知道细胞属于哪个子分支后,标签不确定性减少多少。补图 4.5 明确采用减去乱序标签对照的 IG,之后按 clade 大小汇总;此指标无需另选 Leiden 分辨率,但仍依赖输入表征、树构建、标签和归一化方式。
在本文评分体系下,Geneformer 通常优于 scGPT、scVI。关键前提是,作者把 dataset ID 和 donor ID 与细胞类型、疾病等一起归为 biological,batch 只包括 assay 与 cell/nucleus suspension。研究或供者差异同时可能携带技术因素,因此这一排名不能直接改写成“Geneformer 最善于消除批次”。图 4i 本身也显示 Geneformer 保留了更多批次相关结构。此外,抽样使用部分被评价标签、模型来自同一 Census 的已训练嵌入,未建立独立外部数据上的通用胜出结论。
图谱评测中的极小 P 值来自模型、抽样设置和分辨率上的比较,不能视作众多独立数据集的外部重复实验;不同分辨率还反复使用同一批细胞。对新的方法基准,值得把留出研究/供者的泛化、同一 biological/batch 口径和多次重建树的变异分开检验,避免让更多超参数配置被误解成更多生物学证据。
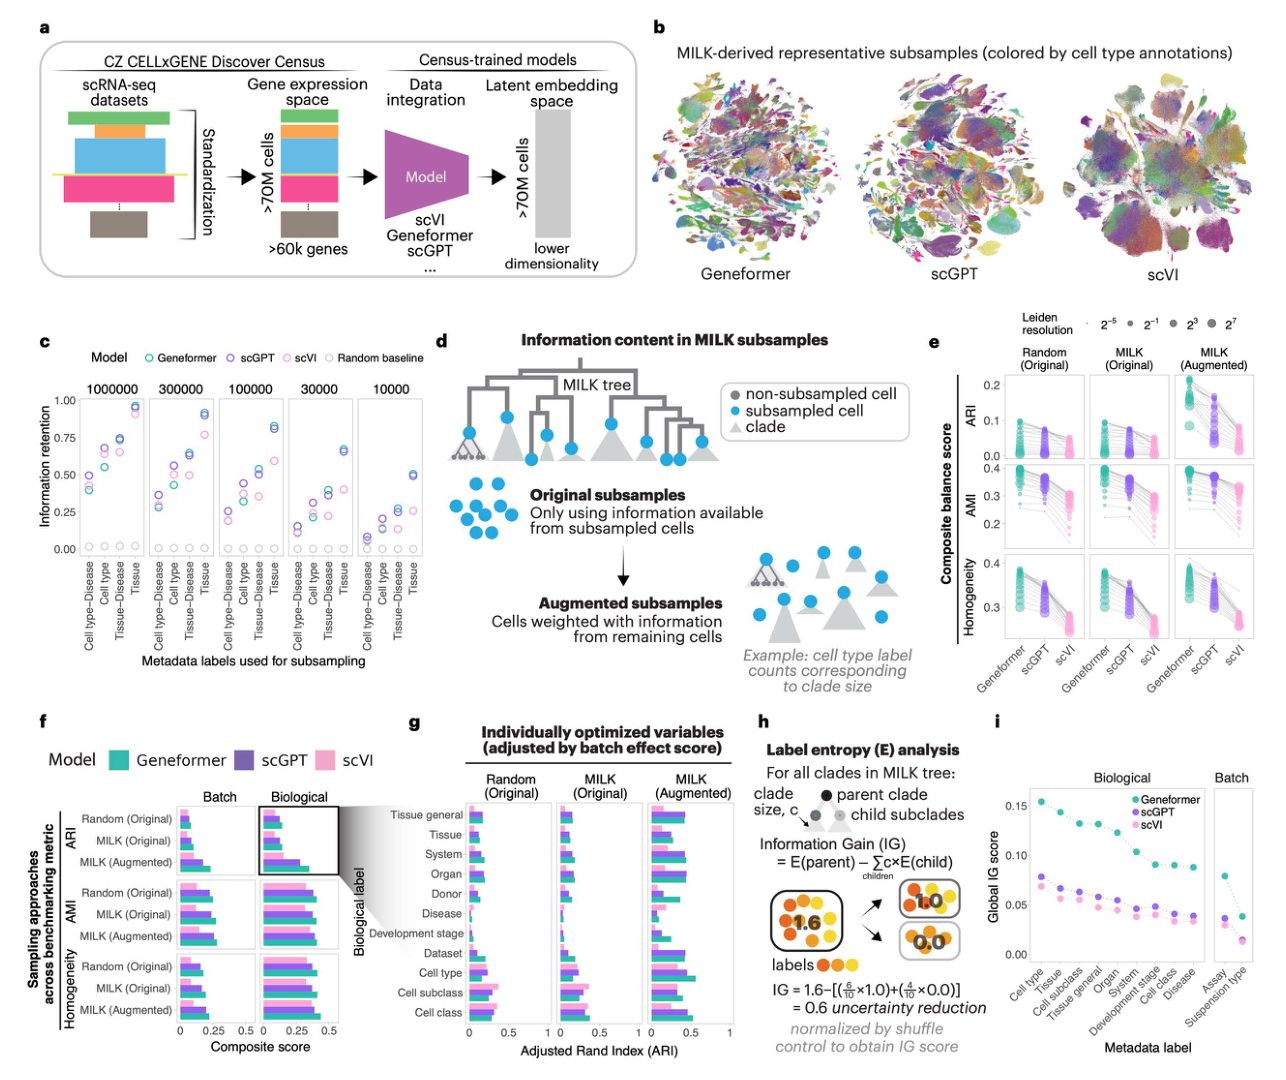
Census 嵌入的抽样后比较。A–D 展示既有模型嵌入、代表覆盖率和按 clade 大小加权,E–G 为多分辨率聚类评价,H–I 为树上的标签信息增益。图 A 的 >70M 为 Census 整体规模,本文去重 primary data 输入约 44M;模型排名应按作者 biological/batch 标签定义理解。
Brett Kiyota et al., bioRxiv (2026), DOI: 10.64898/2026.08.31.747971 · CC BY 4.0 · 原图未修改 · 原文图 · 放大生物学应用支持关联结构,不能代替谱系或疾病效应推断
发育分析从 83 个胚胎、16 个 Theiler 阶段的 11,441,407 个细胞出发,先分阶段抽样再重建全局树。细胞类型平均分支深度与平均发育阶段相关约 ,中间大小 clade 与原图谱整理的细胞类型关系更一致。这支持表达结构含有时间信息;树边表示逐轮合并,不是细胞分裂或真实祖先关系。胚胎身份与阶段混杂,作者未做批次校正;DPT、WOT 比较所用细胞对和约束也不同,不能当作相同条件下谱系重建精度的全面排名。
疾病分析以正常和疾病细胞在各 clade 中的相对分布差异定义 dysregulation coefficient。该系数与差异基因数量在按细胞类型和疾病汇总后分别有 、 的相关,且示例包含疟疾情境成纤维细胞和阿尔茨海默病神经元。但所谓 hit 是超过用户阈值的描述性结果,不是有已校准零分布的疾病关联检验。
其 DEG 参照采用标准化、log1p 表达上的 Scanpy 细胞级 t-test,Methods 未描述 donor 聚类、混合效应或供者级 pseudobulk 模型,也未控制研究间混杂。因此相关性说明两类描述指标有一致性,不能排除伪重复与批次造成的共同信号。将 clade 改成 donor 内汇总单位并重新检验,是值得研究的扩展,而非本文已完成的验证。
跨物种部分使用的是 UCE 公布的 2,969,114 细胞子集,8 个物种、49 个细胞类型,主文代表树约 40 万细胞;并未直接分析完整 3,600 万细胞 IMA。部分类型更按物种分离、另一些更按细胞身份组织,能提出保守性假说,但同时受 UCE 的跨物种对齐、标签粒度与物种采样组成影响。
对方法开发的具体启发
最值得借用的是“代表细胞 + 完整成员映射”的数据结构,而不是单独保存一份抽样矩阵。它允许同一棵树服务于不同分辨率、抽样配额、标签加权与局部聚合。若用于单细胞 QTL 或差异分析,应同时保留 donor、原始计数和抽样权重,避免把树上的近邻关系误当独立性或把平衡后的样本当原始群体比例。对 GPU 优化,本文没有 GPU 基准;距离计算与分区并行值得测试,但应将 I/O、缓存更新和递归轮数一同纳入端到端计时。
论文的分析代码另行公开,可与方法实现及结果资料配合核对。