AB-PRS:在已有 PRS 上补充目标队列的预测信号
A pre-train and fine-tune framework for adaptive boosting of pre-trained polygenic risk scores
AB-PRS 保留已有多基因风险评分,在目标队列中重新编码 SNP 并筛选额外预测成分,再与原评分组合。它讨论的是预测模型更新,而非将非加性信号直接解释成致病机制。
本文目录
核心问题
一个预先训练好的 PRS 到了目标队列后,可能遗漏额外的加性信号,也可能无法充分描述基因型与表型之间的非线性关系。AB-PRS 不从头重建整套评分,而是在已有 PRS 的基础上学习补充成分。因而,它的首要评价标准是独立样本中的预测改进,而不是选出了多少看似非加性的 SNP。[1]
SNP 如何重新编码
对候选 SNP ,作者在包含原有 PRS 的回归中,以 AA 基因型作参照,分别估计 Aa 和 aa 基因型的附加关联。以一般的广义线性模型形式概括:
随后用估计的 、 将三种基因型编码为 。上式为解释用写法,截距及连接函数按表型类型展开;论文 Methods 的式(1)给出条件于原 PRS 的核心模型。[1]
与固定使用 不同,这个编码允许杂合子与纯合子的表型差异不满足线性剂量关系,也能补充原评分漏掉的加性信息。作者将其称为原评分未捕获的“orthogonal”信号;更直接的理解是控制已有 PRS 后的补充预测信息。它不是对基因型矩阵进行简单正交分解,也不能保证选出的 SNP 对应独立因果效应。
变量选择与模型组合
候选变量很多,直接把所有重新编码的 SNP 加入模型容易过拟合。AB-PRS 先在训练部分用 LASSO 选择候选,再在验证部分重新估计系数,通过 mirror statistic 利用两部分系数方向的一致性筛选变量。[1]
论文采用的统计量为
训练和验证系数同号时, 为正;若主要是噪声,其符号应近似对称。方法据此估计错误发现比例,并在一组正则化参数中自适应选择补充变量,最后与原评分组合。
FDR 控制依赖零假设下镜像统计量的对称性及选择过程的条件。它不是对任意 LD、任意反复调参都成立的无条件保证。重新编码本身使用表型,因此编码估计、筛选和参数选择都必须与最终测试样本严格分开;不能先用全数据生成编码,再只对最后的回归做训练–测试划分。
真实数据:哪些预测改善了
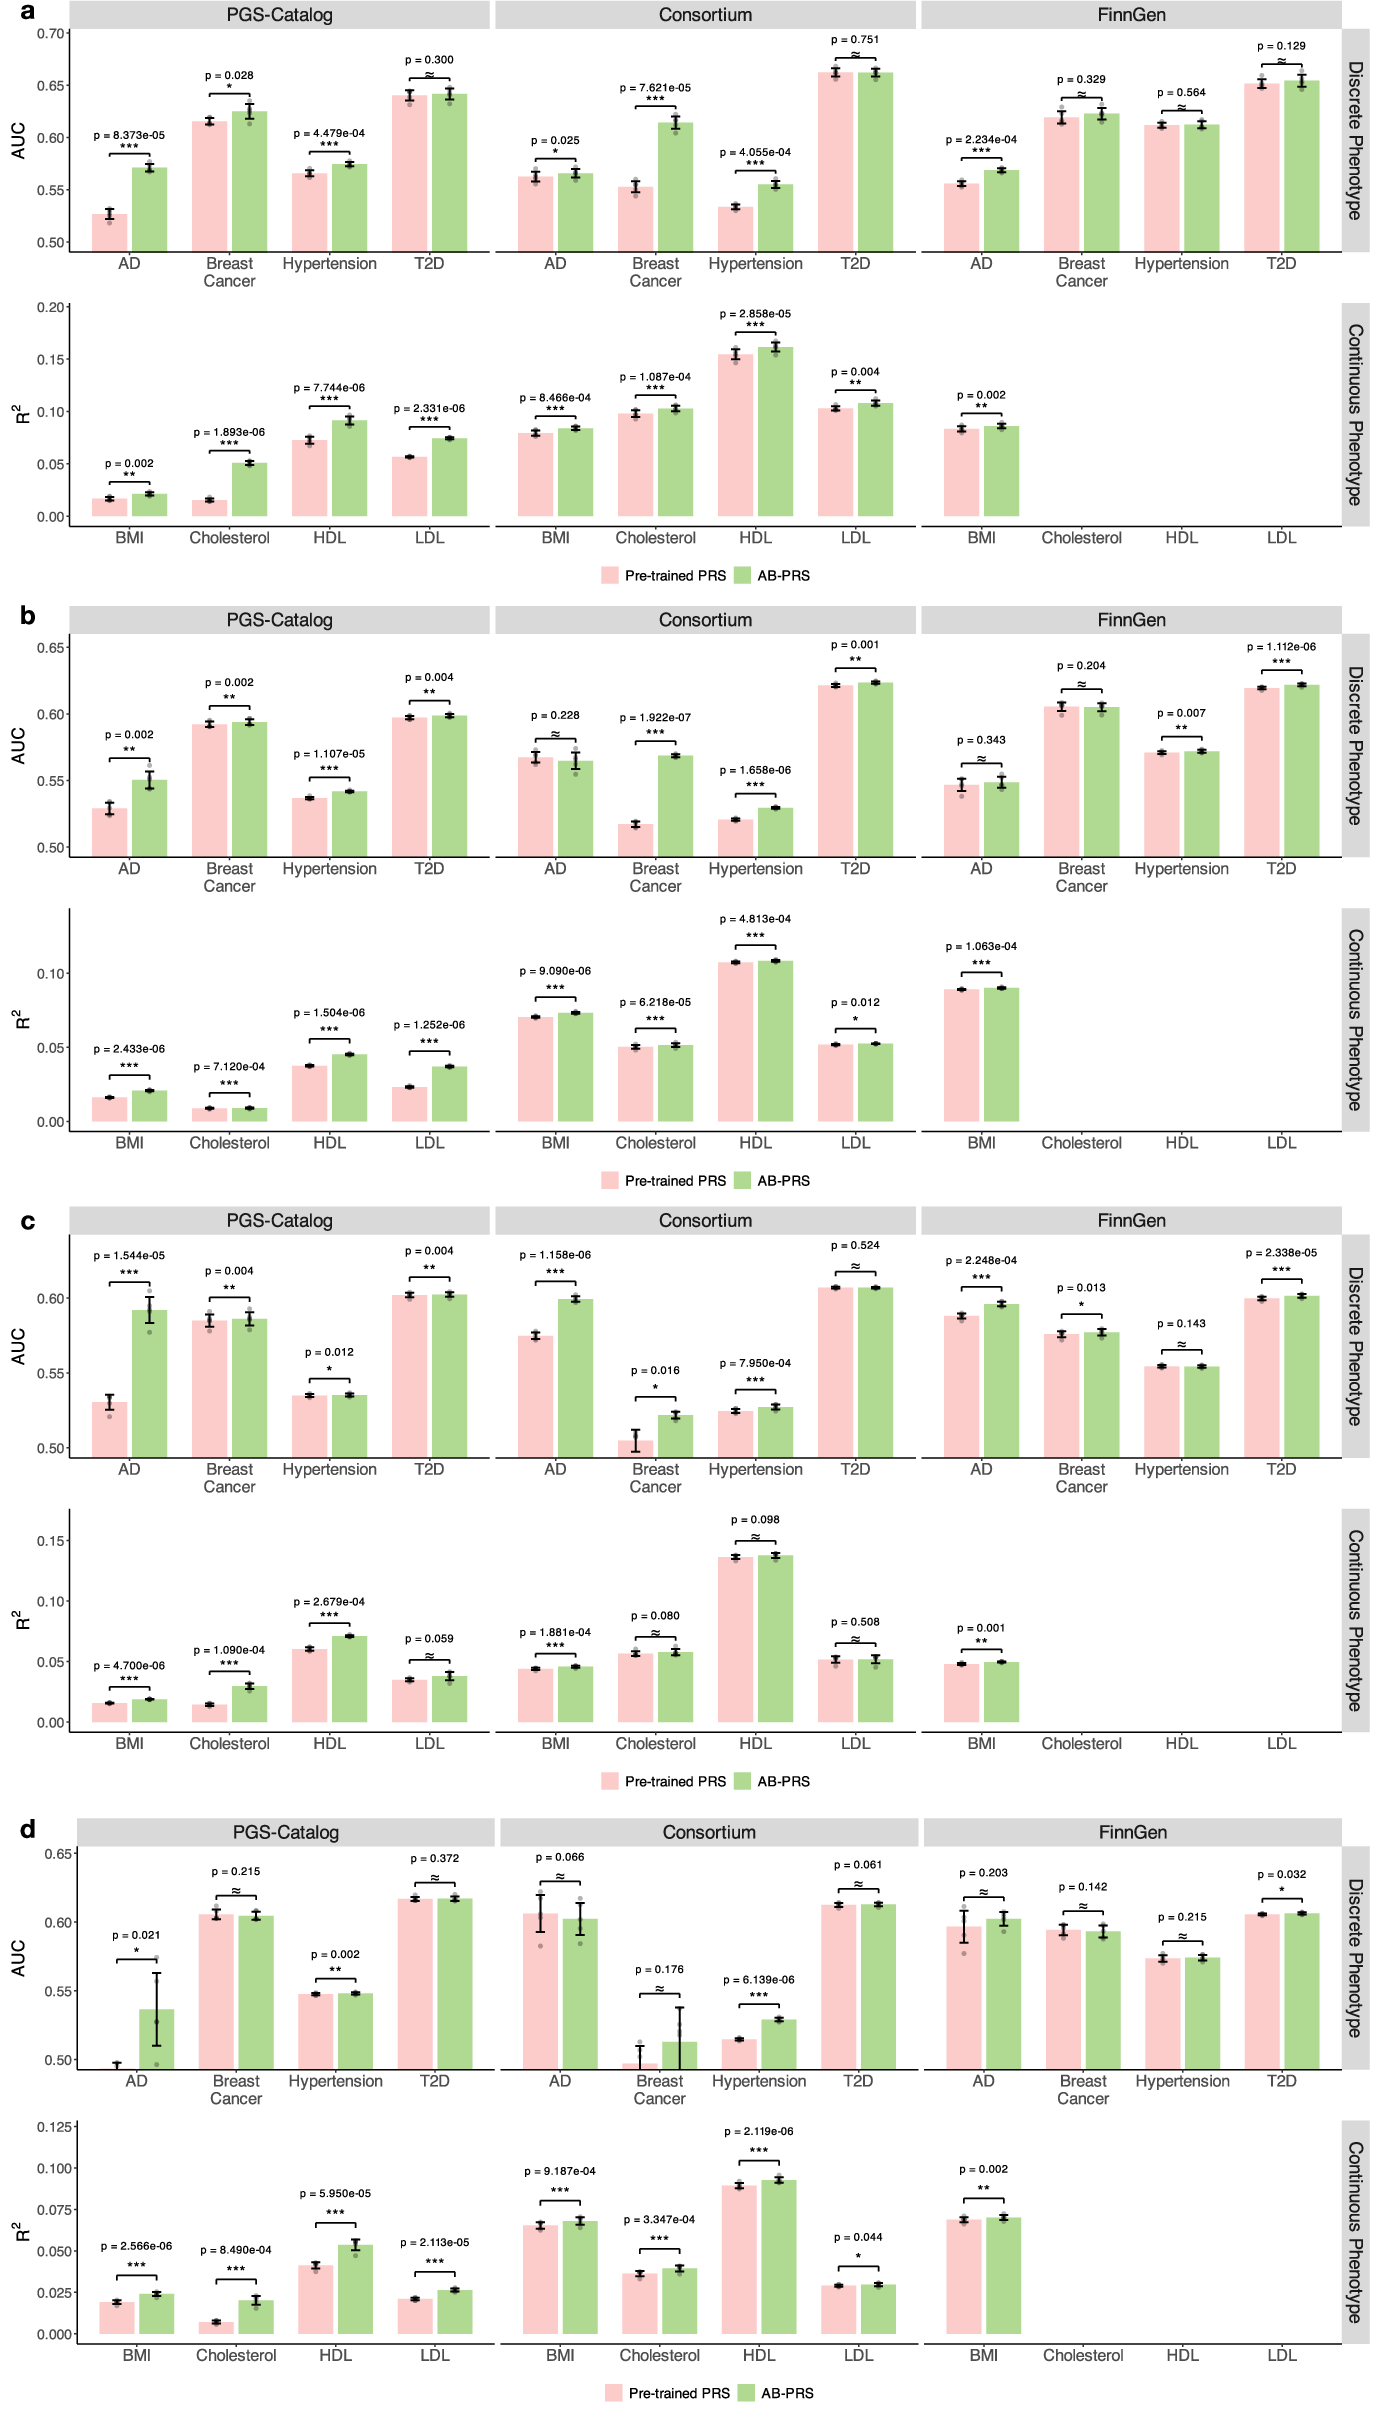
真实数据评估区分二分类与连续性状,以及原有 PRS 的来源。比较应在相同测试集和同一原始评分内进行;相对提升百分比不是 AUC 的绝对百分点。
Hu et al., Nature Communications (2026) · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大UK Biobank 的分析覆盖阿尔茨海默病、乳腺癌、高血压、2 型糖尿病,以及 BMI、总胆固醇、HDL、LDL。作者比较不同来源的原有 PRS,并在独立测试数据上评价 AUC 或解释方差;外部评估还包括 All of Us、eMERGE 和 Penn Medicine Biobank。[1]
Figure 3 的重要信息是收益依赖原有评分和性状。文中报告,PGS 来源的阿尔茨海默病模型 AUC 相对提升为 8.43%,而 FinnGen 来源的同一性状模型为 2.31%。这些是作者报告的相对变化,不能写成 AUC 分别增加 0.0843 或 0.0231。较强原始模型的剩余改进空间往往较小;论文也有差异较小、仅保持竞争力的场景。
因此,不能将某个较弱评分上的最大提升推广为对所有 PRS 方法的优势。复用时应保留原始评分、相同测试集、协变量和指标定义,并同时报告绝对性能与差值。
风险分层与外部评估
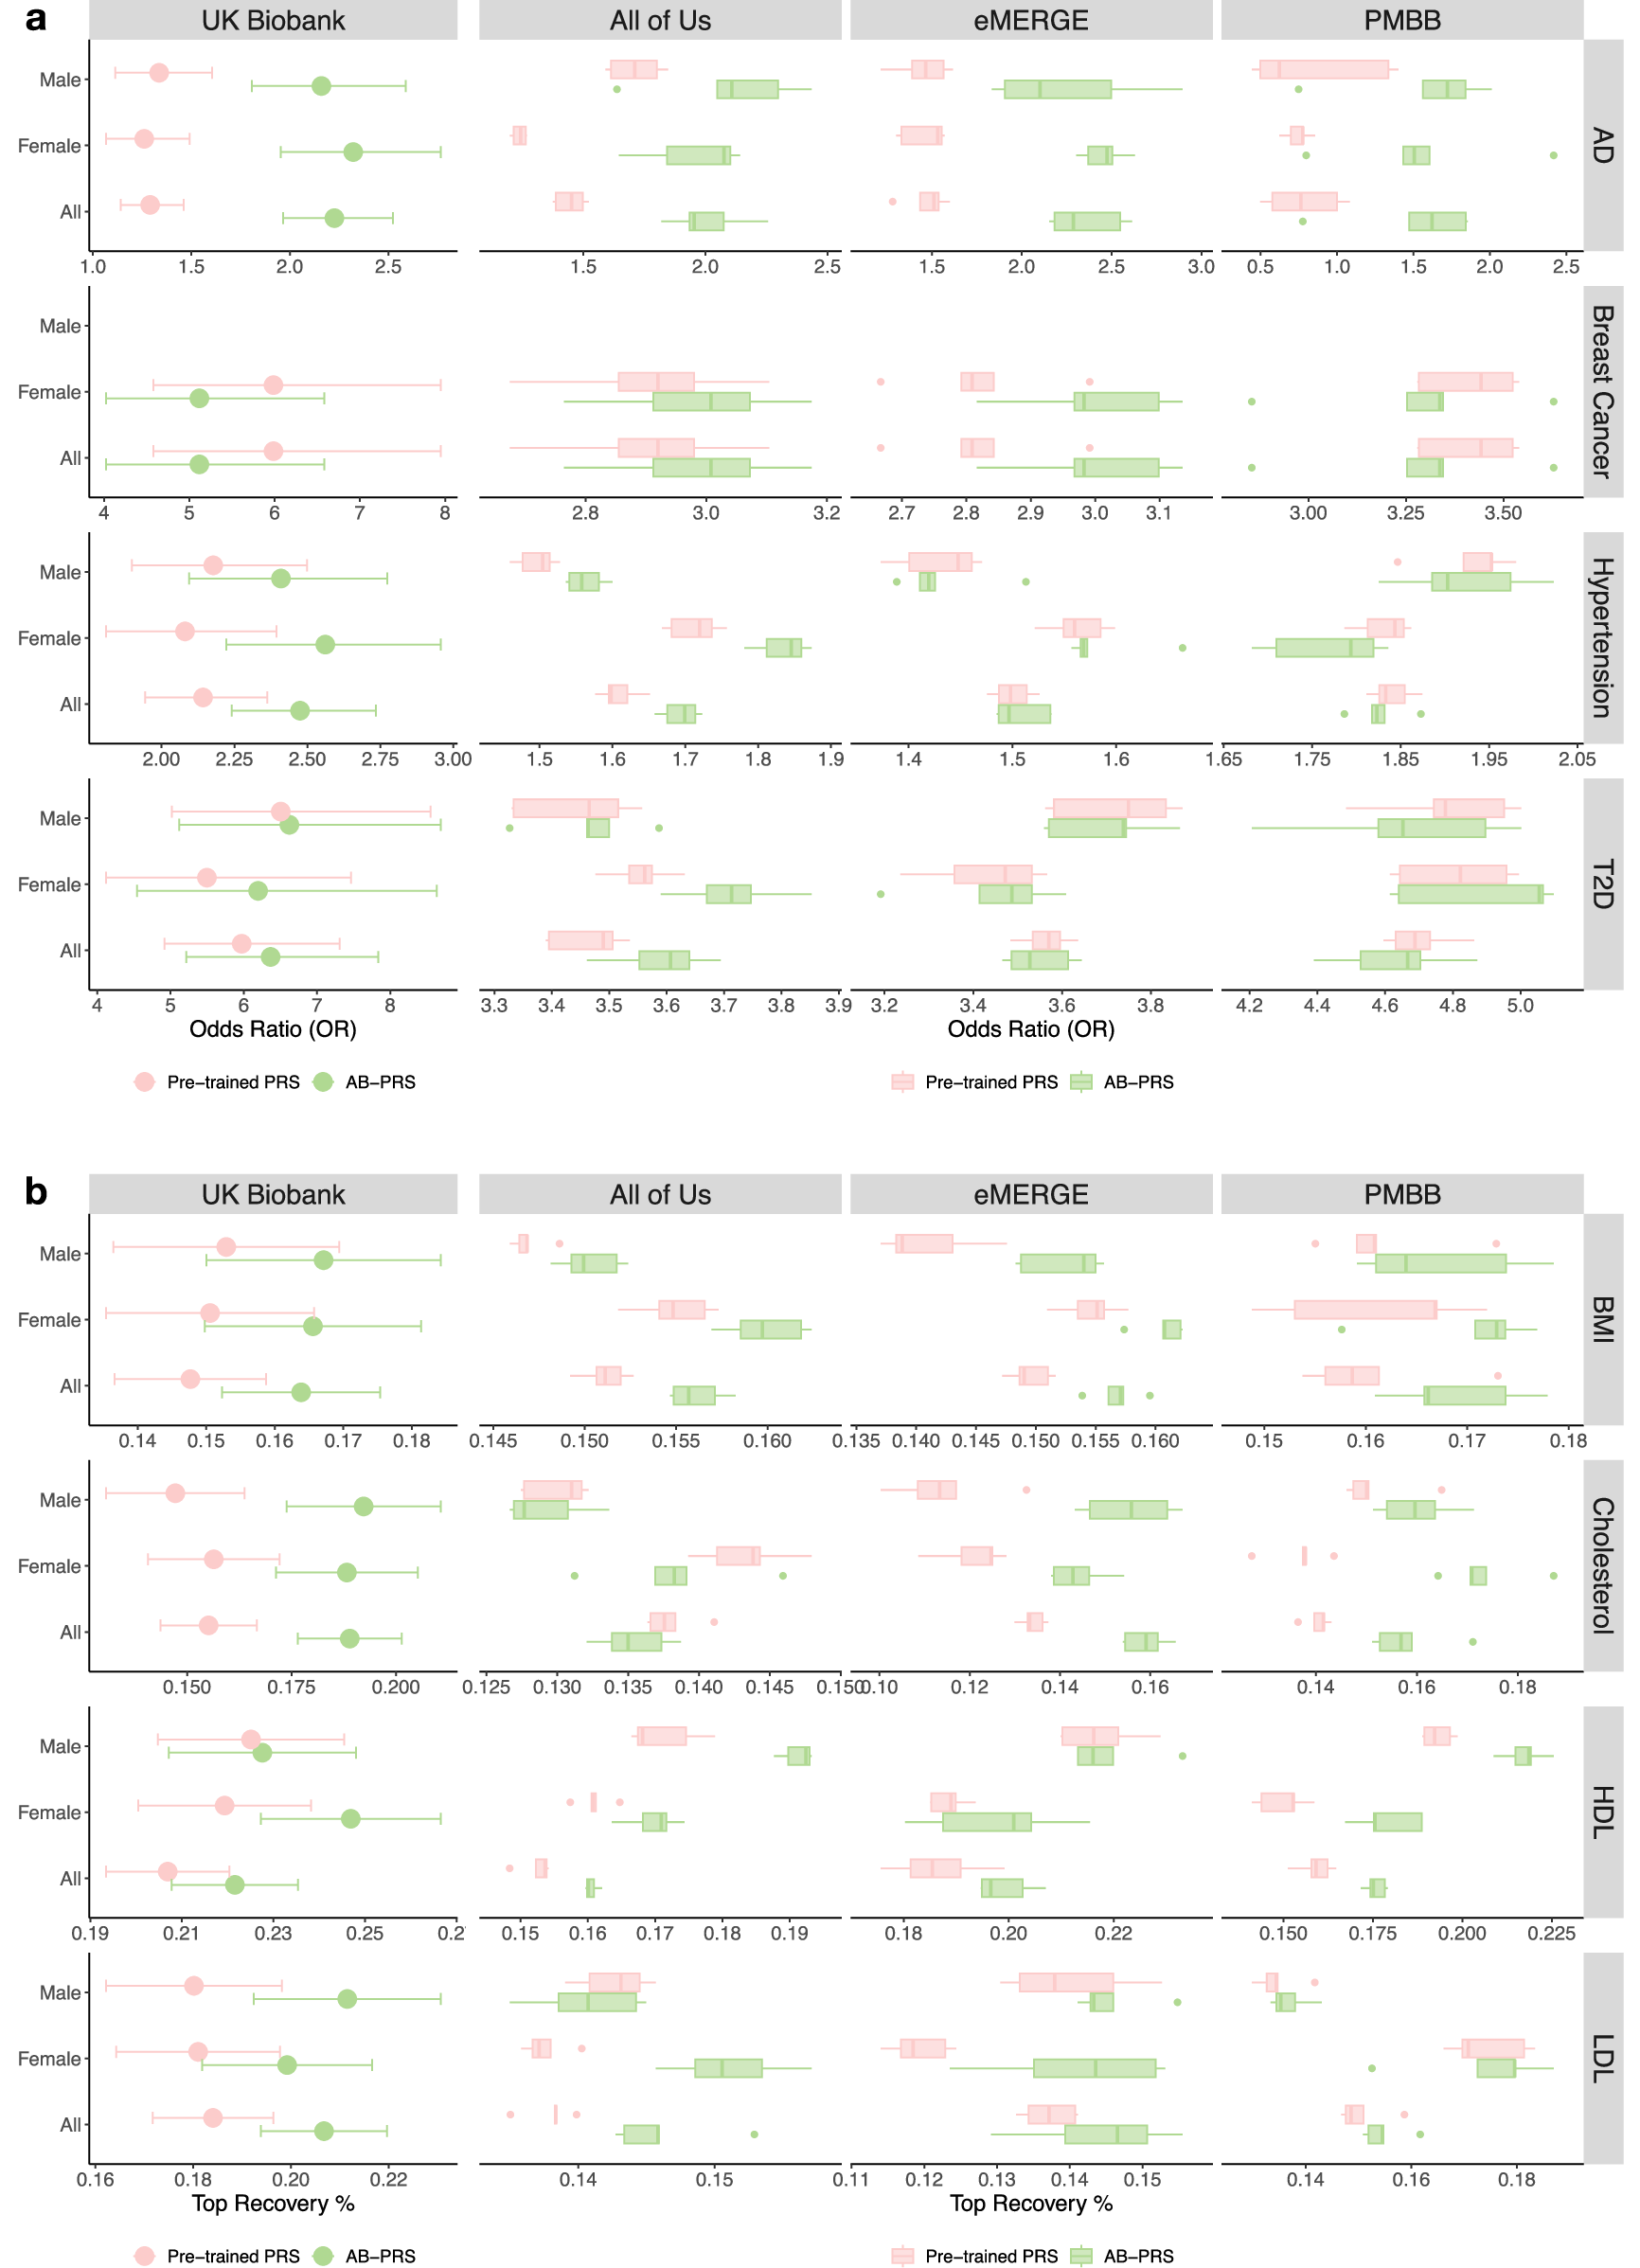
A 比较预测风险最高与最低各 10% 人群的疾病比值比;B 比较连续性状最高 10% 人群的识别率。外部队列箱线图汇总 5 次微调划分,不代表 5 个独立外部人群。
Hu et al., Nature Communications (2026) · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大Figure 7A 比较预测风险最高与最低各 10% 人群的疾病比值比。Figure 7B 的 top recovery rate 则衡量预测排名最高的 10% 人群中,实际表型也属于最高 10% 的比例。前者是相对风险分层指标,不能当作绝对患病概率;后者依赖选定的分位数。[1]
外部队列的箱线图汇总 5 次微调划分。这个设置能检验目标队列中模型更新是否稳定,但并不等同于把 UKBB 中固定好的模型不作任何调整地迁移到新队列。实际使用前要先明确:目标队列是否已有表型可供微调,还是只能对完全未标记的新样本进行预测。
非加性解释需要保留的边界
本文另外按固定加性、显性、隐性、超显性编码重新检验已选 SNP,并以最小 P 值进行模式分类。Figure 4 图注明确说明四种编码间没有进行多重比较校正。因此,“被归到非加性一类”是探索性描述,不是对分子遗传模式的独立确认。[1]
这与昨日收录的罕见变异非加性检验也不是同一个任务:后者侧重检验基因剂量关系偏离加性,AB-PRS 则侧重在现有预测器上增加有效信息。LD 下的标记效应、原始模型遗漏及目标队列差异,都可能产生可用于预测的补充项。
方法开发上值得借鉴什么
最可复用的思路是将“已有预测模型”保留为基线,再对其不足进行带验证的增量建模。对这一方向的延伸,应优先检查额外计算与调参是否带来稳定的测试集改进,而不是仅增加模型复杂度。
若进一步加入 QTL、染色质或序列模型注释来约束候选 SNP,也应在独立位点或队列检验其增益。本文没有证明这类功能注释一定会改善 AB-PRS;这是与功能遗传学结合的后续问题。
参考资料
[1] Hu et al. A pre-train and fine-tune framework for adaptive boosting of pre-trained polygenic risk scores. Nature Communications, 2026-08-29. 论文 · 接受稿全文。主要依据 Methods 式(1)–(5)及 Figures 3、4、7。