Dynema:在连续细胞状态中检验遗传调控效应
Efficient genome-wide mapping of reproducible, context-dependent eQTLs at single-cell resolution
Dynema 将逐细胞 Poisson 建模、donor 聚类稳健 score 检验与自适应 bootstrap 结合,在 TBRU 和 OneK1K 中发现可复现的细胞状态交互 eQTL,并揭示部分交互信号独立于主效应 lead variant。
本文目录
全文解读|bioRxiv v1,2026-08-29 公开,尚未经同行评议。 本文依据 v1 全文、Methods、Supplementary Notes 1–2 及原图更新。所读 PDF 未附独立的补充图和数据表文件,相关结果按正文及补充说明报告。论文 · 全文 PDF
为什么需要扫描所有 cis 变异的状态交互
Dynema 关注同一变异的表达效应如何沿细胞状态变化。先把 T 细胞汇总成 donor 级 pseudobulk、再只对主效应 lead variant 做交互检验,可能漏掉两类信号:不同状态中的效应被平均而减弱;或交互信号由另一个与主效应 lead variant 不完全连锁的变异驱动。Dynema 的价值在于让逐细胞、逐 cis 变异的状态交互扫描在计算上可行,同时处理同一 donor 内细胞的相关性。
Poisson 均值模型与三种遗传检验
令 为 donor 的细胞 的原始 UMI 计数, 为候选变异剂量, 为第 个细胞状态, 为协变量。用条件均值记号整理原文模型:
真实数据中 。协变量包括年龄、性别、5 个基因型 PC、5 个表达 PC、线粒体表达比例及标准化后的 log 总 UMI。log 总 UMI 在本文是估计系数的协变量,不是系数固定为 1 的 offset。 Poisson 提供均值拟合和 score;方差推断随后通过 donor 聚类稳健化,不要求逐细胞计数严格满足均值等于方差。
| 检验 | 本文使用的模型和零假设 | 自由度 |
|---|---|---|
| Main effect | 不含基因型×状态交互项的模型中,检验 | 1 |
| Multi-context interaction | 保留基因型主项及状态主项,检验 | 3 |
| Total effect | 联合检验 | 4 |
这里的 main-effect 检验按 Methods 式(30)拟合简化模型,不能与完整交互模型中“状态取零时的基因型系数”混为一谈。作者另用只纳入一个 CV 及其交互项的模型,评估单状态交互的一致性。总效应显著说明至少一个遗传分量非零,并不单独证明存在状态依赖性。
完整模型给出每个细胞的拟合遗传效应:
TSCE 表示固定状态和其他协变量时,每增加一份效应等位基因带来的 log 均值变化;取指数后是均值比。它是模型在不同细胞状态上的预测,不是从每个细胞独立估计出的遗传效应。
donor 聚类稳健 score 检验与自适应 bootstrap
Dynema 在零假设下拟合模型,计算每个细胞的 score ,再按 donor 汇总。协方差的 sandwich 中间项由 donor 级 score 外积构造,并使用 有限样本修正。广义 score/Lagrange multiplier 统计量据此检验指定的一个或多个系数,解析推断采用相应自由度的卡方近似。
这种构造允许同一 donor 内存在任意相关结构,但仍依赖 donor 之间独立及足够的 donor 数量。它能够放松方差和相关结构假设,不能自动纠正错误的条件均值、遗漏混杂或不恰当的状态表示。
当 donor 较少或细胞数极不均衡时,作者进一步对 donor 级 score 乘以随机 权重,构造 wild score bootstrap。每个零假设模型只需拟合一次,重抽样阶段无需反复拟合 GLM;程序根据尾部超越次数自适应增加抽样,减少不显著变异的计算量。这项节省发生在同一检验的重抽样内部,不能理解为所有 SNP、所有检验都共用一个零模型。
统计校准、功效与计算基准
作者在 TBRU 的 2,202 个 lead variant–gene pair 上置换 donor 基因型,保留真实表达和细胞状态结构。在 检验、名义阈值 下,解析 Dynema 和 bootstrap Dynema 分别有 0.8% 和 0.7% 的检验显著;scPME、CellRegMap、scLME 分别为 2.6%、4.6%、3.9%。这支持 Dynema 在该零假设设计下的校准,而不是任意数据分布下的保证。
补充说明还考察了存在基因型主效应或状态主效应、但没有交互效应的模拟,以及多状态交互和总效应检验。极端 donor 数量/细胞数失衡场景中,解析检验的膨胀因子范围为 1.04–1.22,bootstrap 为 0.99–1.05。功效实验则基于三个不同表达水平的代表基因进行 Poisson GLM 模拟,不能把这些曲线当成所有稀有细胞状态和表达分布的功效下界。
在约 50 万细胞的基准中,原文 Figure 2d 报告 Dynema 解析检验平均约 1.4 秒/变异–基因对,bootstrap 约 1.6 秒;相对于 scPME 和 CellRegMap,正文报告平均加速约 10.5 倍和 1,442.3 倍。作者还报告 4 线程下一个 locus 的扫描约需 10 分钟。逐对耗时与 locus 耗时对应不同工作量,均不是全基因组端到端耗时;其计算优势也不来自 GPU。
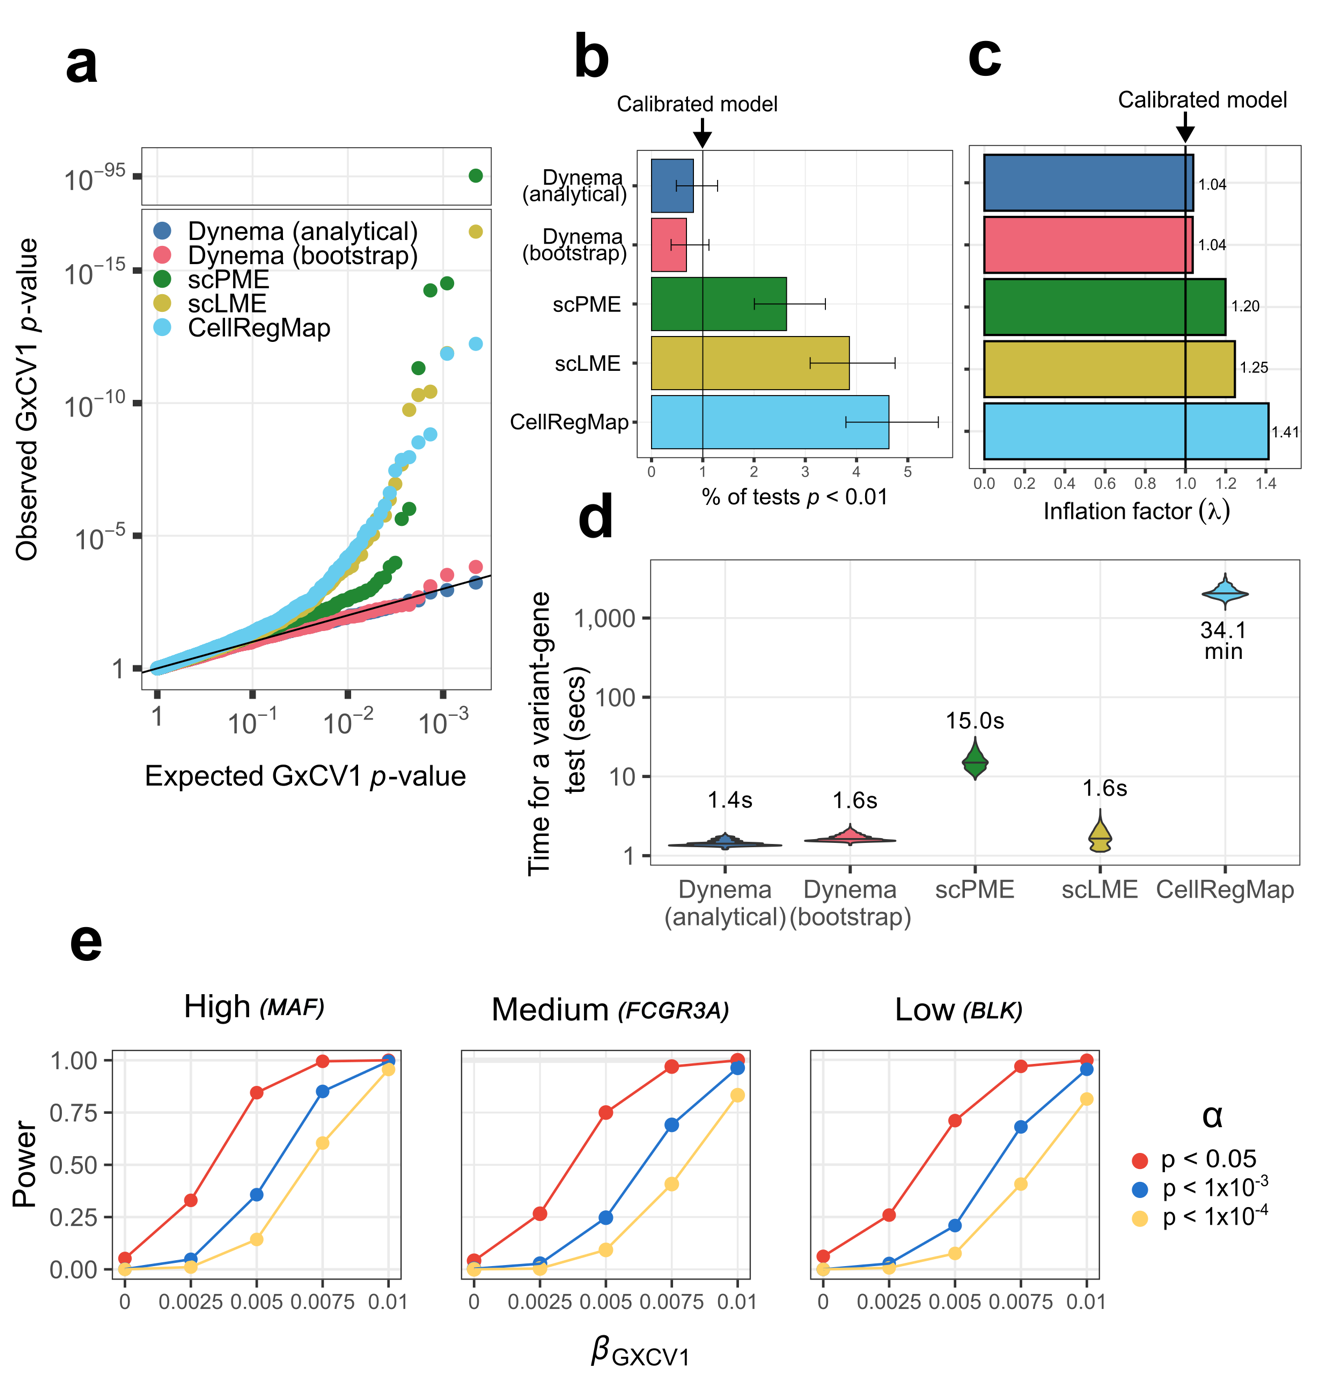
a–c 比较 2,202 个 lead variant–gene pair 的 G×CV1 置换检验;d 为单个变异–基因检验的平均耗时;e 为三个表达水平的 Poisson 模拟功效。图中 MAF 为基因名称。该基准不代表所有数据条件下的性能保证。
Alquicira-Hernandez et al., bioRxiv v1 (2026-08-29), Figure 2 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大TBRU 与 OneK1K:共享状态坐标中的跨队列复现
| 队列 | donor 数量 | 质控后 T 细胞 | 本次分析范围 |
|---|---|---|---|
| TBRU | 259 | 500,089 | 秘鲁队列的记忆 T 细胞 CITE-seq;6,289 个基因 |
| OneK1K | 969 | 约 579,000 | 澳大利亚队列的 CD4/CD8 T 细胞;3,821 个基因 |
TBRU 用 RNA 与表面蛋白的 CCA 定义细胞毒性(CV1)、调节/活化(CV2)和中央记忆(CV3)三个连续状态。OneK1K 没有对应的蛋白测量,因此通过 Symphony 映射到 TBRU 参考坐标。两个队列共享 3,740 个满足表达过滤条件的基因;细胞数、基因覆盖和状态分布不同,不能只凭 donor 更多便预期所有信号更强。
在各队列自己的 pseudobulk lead eQTL 中,以 Storey 检验三状态交互,TBRU 的 631/1,682(38%)及 OneK1K 的 513/1,456(35%)具有交互证据。另一个复现分析先通过两队列 pseudobulk meta-analysis 选出 1,719 个共享变异–基因对:TBRU 中交互 的 117 对里,83% 在 OneK1K 达到名义 。这是特定候选集合和阈值下的复现率,不是所有全基因组新发现的无偏复制率。
对于两个队列均名义显著的单状态交互,CV1–3 的效应方向一致率分别为 0.98、0.92、0.95,Figure 3 的 z 分数相关分别为 0.88、0.85、0.84。ATM–rs1893813 展示了为何保留连续状态有用:等位基因的表达效应随细胞毒性增加而下降,在中央记忆/辅助 T 细胞中偏正,在细胞毒性 T 细胞中偏负,状态汇总会掩盖这种差异。
全 cis 扫描与条件于主效应的交互信号
作者扫描 TSS 上下游各 250 kb 的变异,先以 4 自由度 total-effect 检验筛选 eGene,并按全基因组变异–基因对作 Šídák 校正;正文报告 TBRU/OneK1K 分别有 849/985 个 total eGene。随后在这些基因内,用 locus 级多重校正分解主效应和交互证据,得到 835/973 个 main eGene、262/273 个 interaction eGene。total-effect 筛选与 main/interaction 集合是不同检验的产物,不应简单相加。
AP1G2 是平均效应可能被遮蔽的例子:pseudobulk meta-analysis 的名义 ,全局校正后不显著;Dynema 却在两个队列中都于 rs34015250 检出 total 和多状态交互信号,拟合效应集中在 GZMK+ T 细胞状态。其价值是找出原有汇总与筛选流程可能漏掉的关联,不是证明 pseudobulk 在所有任务中都更差。
为判断交互信号能否由主效应 lead variant 解释,条件模型加入该 lead variant 的基因型及其与 CV1–3 的交互项。Results 报告,在阈值约 和 下,71 和 117 个交互信号仍显著,占各自 interaction eGene 的 27% 和 43%;这些位点主效应与交互 lead variant 的中位 分别为 0.15 和 0.11。RCSD1 和 NDUFS5 展示保留的信号,SMDT1 则展示条件后消失的信号。
原文对“独立”的判定还存在需要复核的细节:Methods 另列 locus 级 Bonferroni 校正及条件前后 相关性 ,而 Results 报告的独立位点相关性中位数含 0.87。这里保留作者报告的显著性计数,不把它们等同于已经精确 fine-map 的独立因果变异数。
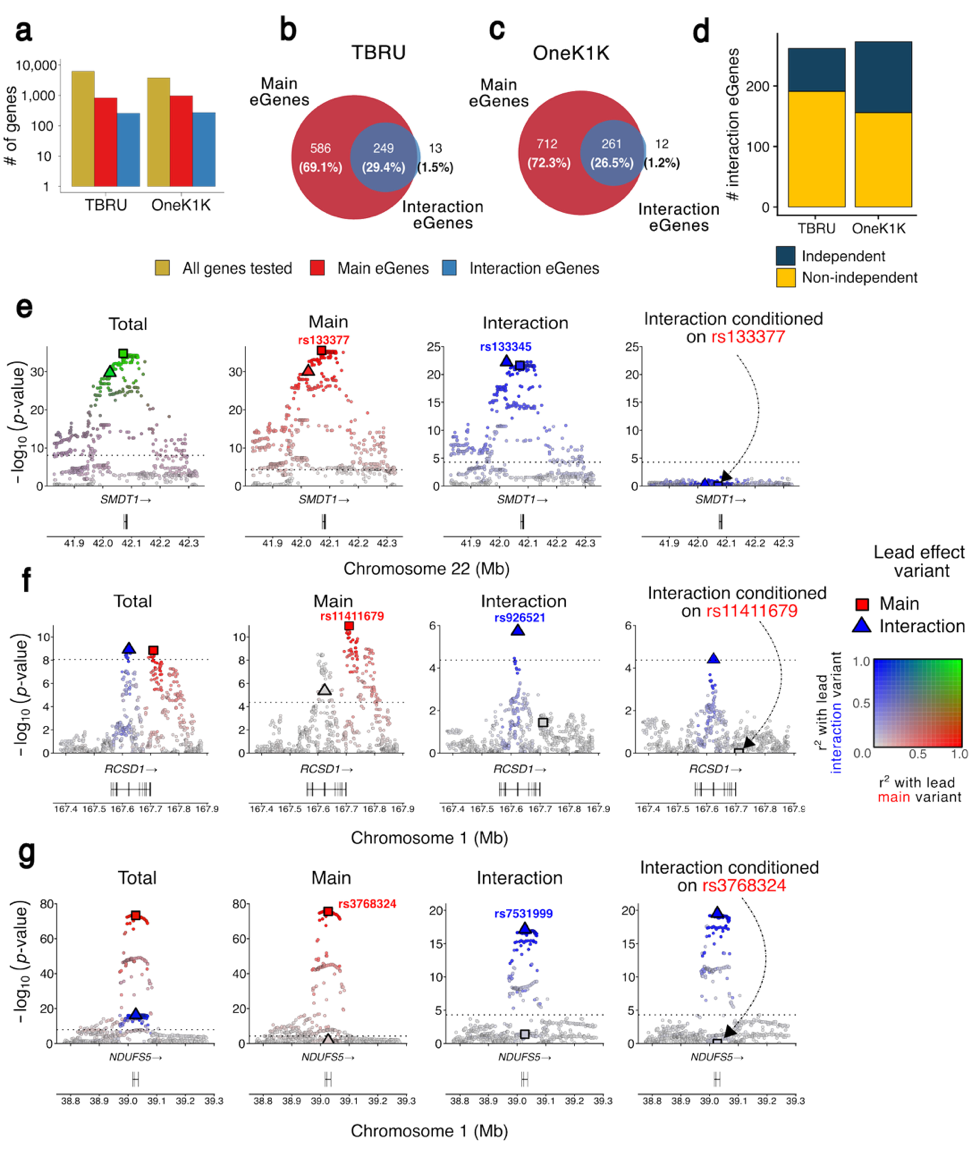
a–d 展示主效应及交互 eGene 的数量和条件分析;e–g 对照 SMDT1、RCSD1 与 NDUFS5 中消失或保留的交互信号。条件模型同时纳入主效应 lead variant 的基因型及其 CV1–3 交互项;结果不能直接等同于因果变异数。
Alquicira-Hernandez et al., bioRxiv v1 (2026-08-29), Figure 6 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大TSPAN32、CTSS 与自身免疫病共定位
作者在 total eGene 中选择 cis 窗口内具有 GWAS 变异的 357 个候选位点,分析 7 类自身免疫病 GWAS。使用 coloc 5.2.3,以至少一个队列 为标准,分别报告 59 个 total、60 个 main 和 32 个 interaction eGene 与疾病信号共定位;三组会重叠,不能相加为独立位点总数。
TSPAN32–血清阳性类风湿关节炎:交互效应的 在 TBRU/OneK1K 为 0.99/0.98,正文报告主效应仅为 /。与疾病信号相符的遗传效应在 CD8 T 细胞状态更突出。CTSS–炎症性肠病:交互 为 0.71/0.69,效应在活化 CD8/CD4 T 细胞中较明显,作者称该状态约占外周血 T 细胞的 2%。CTSS 主效应的 TBRU 在正文为 0.15、Figure 7c 为 ,存在图文不一致,因此不据此作精确倍数比较。
这些是作者在指定模型和先验下得到的共享信号证据。论文未详细说明如何把 3/4 自由度的交互/总效应统计量转化为 coloc 所需的单效应证据;复现时应核对这一环节,而不能把多自由度检验的 值直接视为带方向的单参数效应。共定位也尚未证明表达变化介导疾病,UMAP 上的 TSCE 不能替代功能干预。
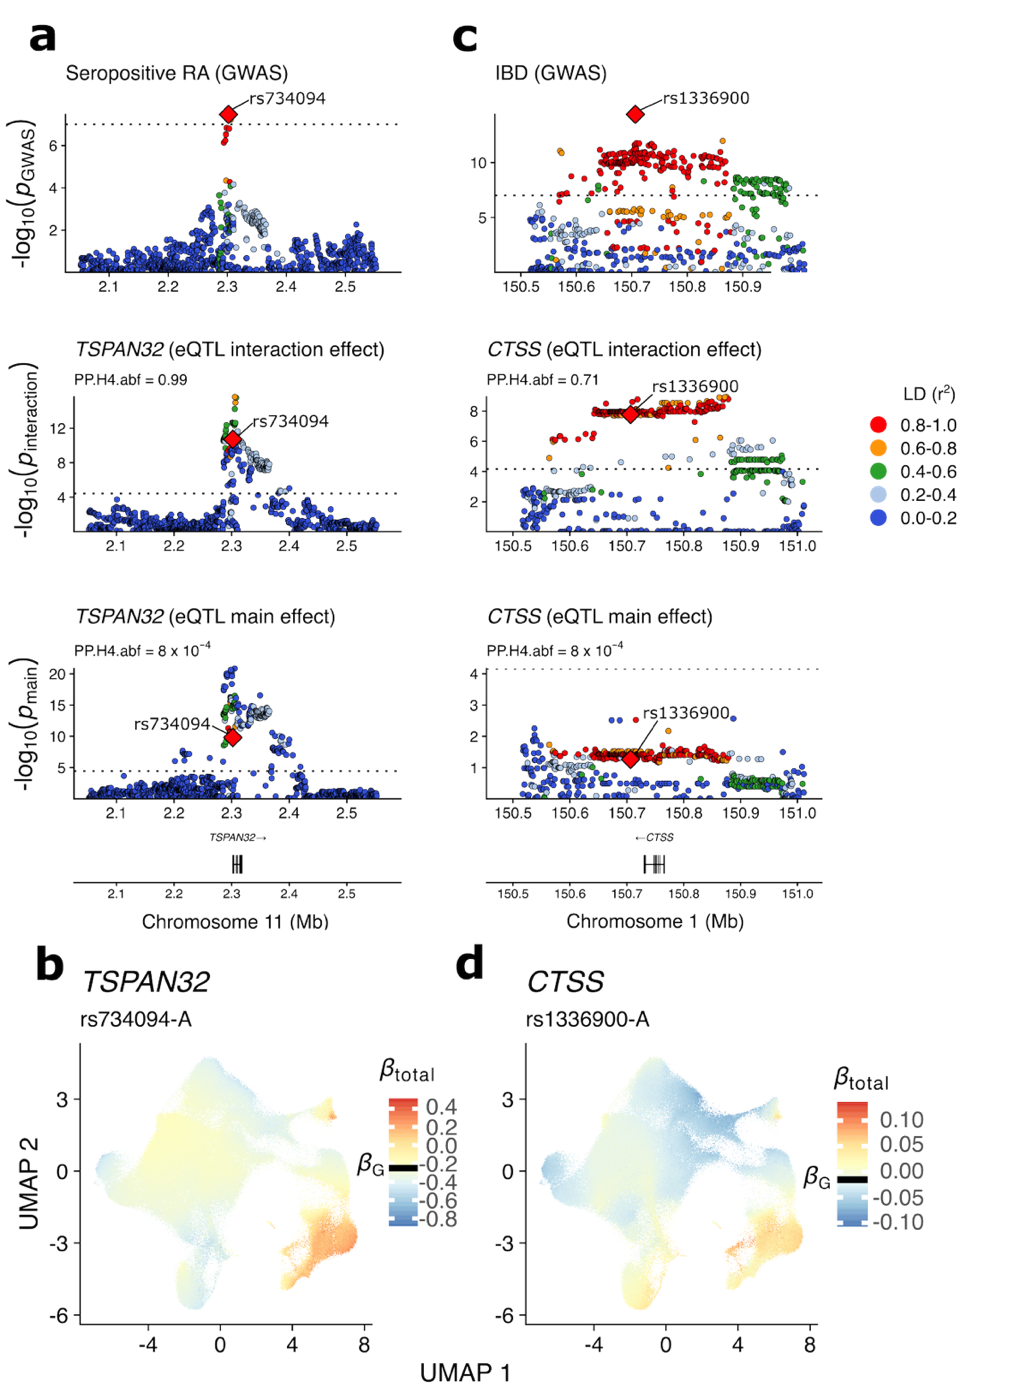
a、c 分别为 TSPAN32–血清阳性类风湿关节炎和 CTSS–炎症性肠病的区域关联;b、d 为拟合 TSCE 的 UMAP。CTSS 主效应 PP.H4 在图中标为 8×10⁻⁴、正文为 0.15,图文不一致,本解读不据此作精确定量比较。
Alquicira-Hernandez et al., bioRxiv v1 (2026-08-29), Figure 7 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大对单细胞方法开发的启发与适用边界
值得借鉴的是把问题分成三个层次:逐细胞条件均值建模、donor 级稳健推断,以及遍历 cis 区域的状态依赖遗传结构分析。对性能优化,主要机会在零模型拟合、score 的 donor 级汇总和重抽样矩阵运算;对统计方法,重点则是小 donor 数量、不平衡细胞数、亲缘关系及数据驱动状态表示带来的不确定性。
本文当前假设 donor 之间独立,不能直接用 donor 聚类替代亲缘关系建模;状态由表达或多模态数据学习,其可迁移性是跨队列比较的前提。研究主要基于血液 T 细胞及常见变异,不能据此保证其他组织、疾病激活状态或稀有变异下的同等校准与功效。