东亚精神分裂症 CNV:频率、检测与跨祖源效应
Contribution of copy number variants to schizophrenia in East Asian populations
在44,161名东亚参与者中开展罕见CNV负担和基因水平关联,再与欧洲数据整合。重点是区分携带频率、检测能力、效应共享与因果基因定位;补充材料限定了正交验证覆盖的位点,也显示CNV–PRS交互依赖负担定义。
本文目录
这项研究改变的是变异可见性,而不只是样本量
这篇论文的主要贡献,是在东亚精神分裂症病例–对照样本中建立跨队列的罕见 CNV 检测和关联分析流程,再与欧洲祖源数据比较。它不是新的 fine-mapping 方法,也没有把 CNV 区间内的多个基因逐一确认为致病基因。最重要的结论是:一些 CNV 在东亚样本中更容易被观察到,因而能够贡献欧洲研究难以取得的关联信息;这与“效应只存在于东亚”是两个不同命题。
阅读时应区分四个层次:分段是否真实存在、携带某类分段是否与疾病相关、哪个基因解释这一关联、机制是否跨祖源共享。论文对前两个层次给出最直接的证据,后两个层次仍有明显不确定性。主文
样本结构、检测对象与技术误差
| 分析部分 | 样本量与作用 | 不能混淆的边界 |
|---|---|---|
| 东亚发现分析 | 15 个队列样本,质控前 51,667 人,质控后 20,903 病例、23,258 对照 | 总计 44,161 人;不是 15 个独立重复实验 |
| 欧洲比较数据 | 17,506 病例、16,751 对照,共 34,257 人 | 来自既往 PGC callset,不是同一平台重新测量的队列 |
| 跨祖源 meta-analysis | 38,409 病例、40,009 对照,共 78,418 人 | 各基因可用祖源与携带者数不同 |
| CNV–PRS 联合分析 | 原文另报告 14,788 病例、15,671 对照,共 30,459 人 | 排除 PRS 发现 GWAS 的参与者;不能作为新增样本加到主分析中 |
| WES 验证 | 16,623 人有可用外显子组数据 | 技术验证子集,不是独立疾病关联复制队列 |
东亚样本来自不同地区和五类芯片平台。作者采用 PennCNV 与 iPattern 双算法,仅保留共同支持的分段,并进行个体、平台与分段质量控制。高质量罕见 CNV 的规则包括约 20 kb 以上、至少 15 个探针、合并样本频率低于 1%、至少两份样本中检出,以及两个 caller 均支持;基因注释关注外显子重叠。最终东亚 callset 包含 58,536 个罕见 CNV。结论针对经过筛选、可被芯片检测的事件,不能外推为所有结构变异的遗传架构。
欧洲原研究使用至少 10 个探针,东亚使用至少 15 个,理由是 10–14 探针的 CNV 在 WES 中验证较差。作者在欧洲子集复用新流程,并分别测试两个探针阈值,约恢复既往 callset 的 84%;遗漏的 CNV 倾向于更短、探针更少。这支持流程的一致性,但不是灵敏度和特异度均达到 84%:既往 callset 也不是无误差真值。两个 caller 的交集提高一致性,却可能共同遗漏短事件或探针覆盖不足区域。
来源:主文 Table 1、Rare CNV calling and QC、Methods 的 Rare CNV detection,以及 Supplementary Note。PRS 补充表与主文部分队列的质控后人数口径不完全一致,本笔记保留原文各分析报告值,不反推出精确交叠人数。
全基因组负担:三个暴露变量、三个 OR 尺度
作者分别考察与基因重叠 CNV 的总长度、genic CNV 数目,以及受影响基因数,并按分段长度阈值及 deletion/duplication 分层。可将暴露记为 、、。长度以每 100 kb 为单位,另外两个指标以每个事件、每个受影响基因为单位,三幅负担图的 OR 不能直接比较大小。
原文的模型书写有一处需要保留的差异。 Results 称其为 logistic mixed-effects model,但 Methods 展示了 及正态残差的线性混合形式。核读作者公开的负担脚本,可见调用为 relmatGlmer(..., family = binomial),包括性别、平台、前五个 PCs 和基于亲缘矩阵的随机效应。以下是依据代码对其二分类模型的数学表述,而非把 Methods 原式悄悄改写:
是亲缘关系矩阵, 是负担增加一个指定单位时的条件 OR。代码核验不等于重跑分析,也不能证明生成主文表格的所有参数与公开脚本完全相同。作者负担代码
东亚病例在三个指标上均有负担增加。例如,对大于 20 kb 的 CNV,每多一个受影响基因,OR 为 1.007,95% CI 1.005–1.009,P=6.82×10⁻¹²。对大于 600 kb 的事件,deletion 的每基因 OR 为 1.069,duplication 为 1.025。前者关联更强,不意味着所有 deletion 都致病,也不意味着受影响基因数本身具有可直接干预的因果作用。
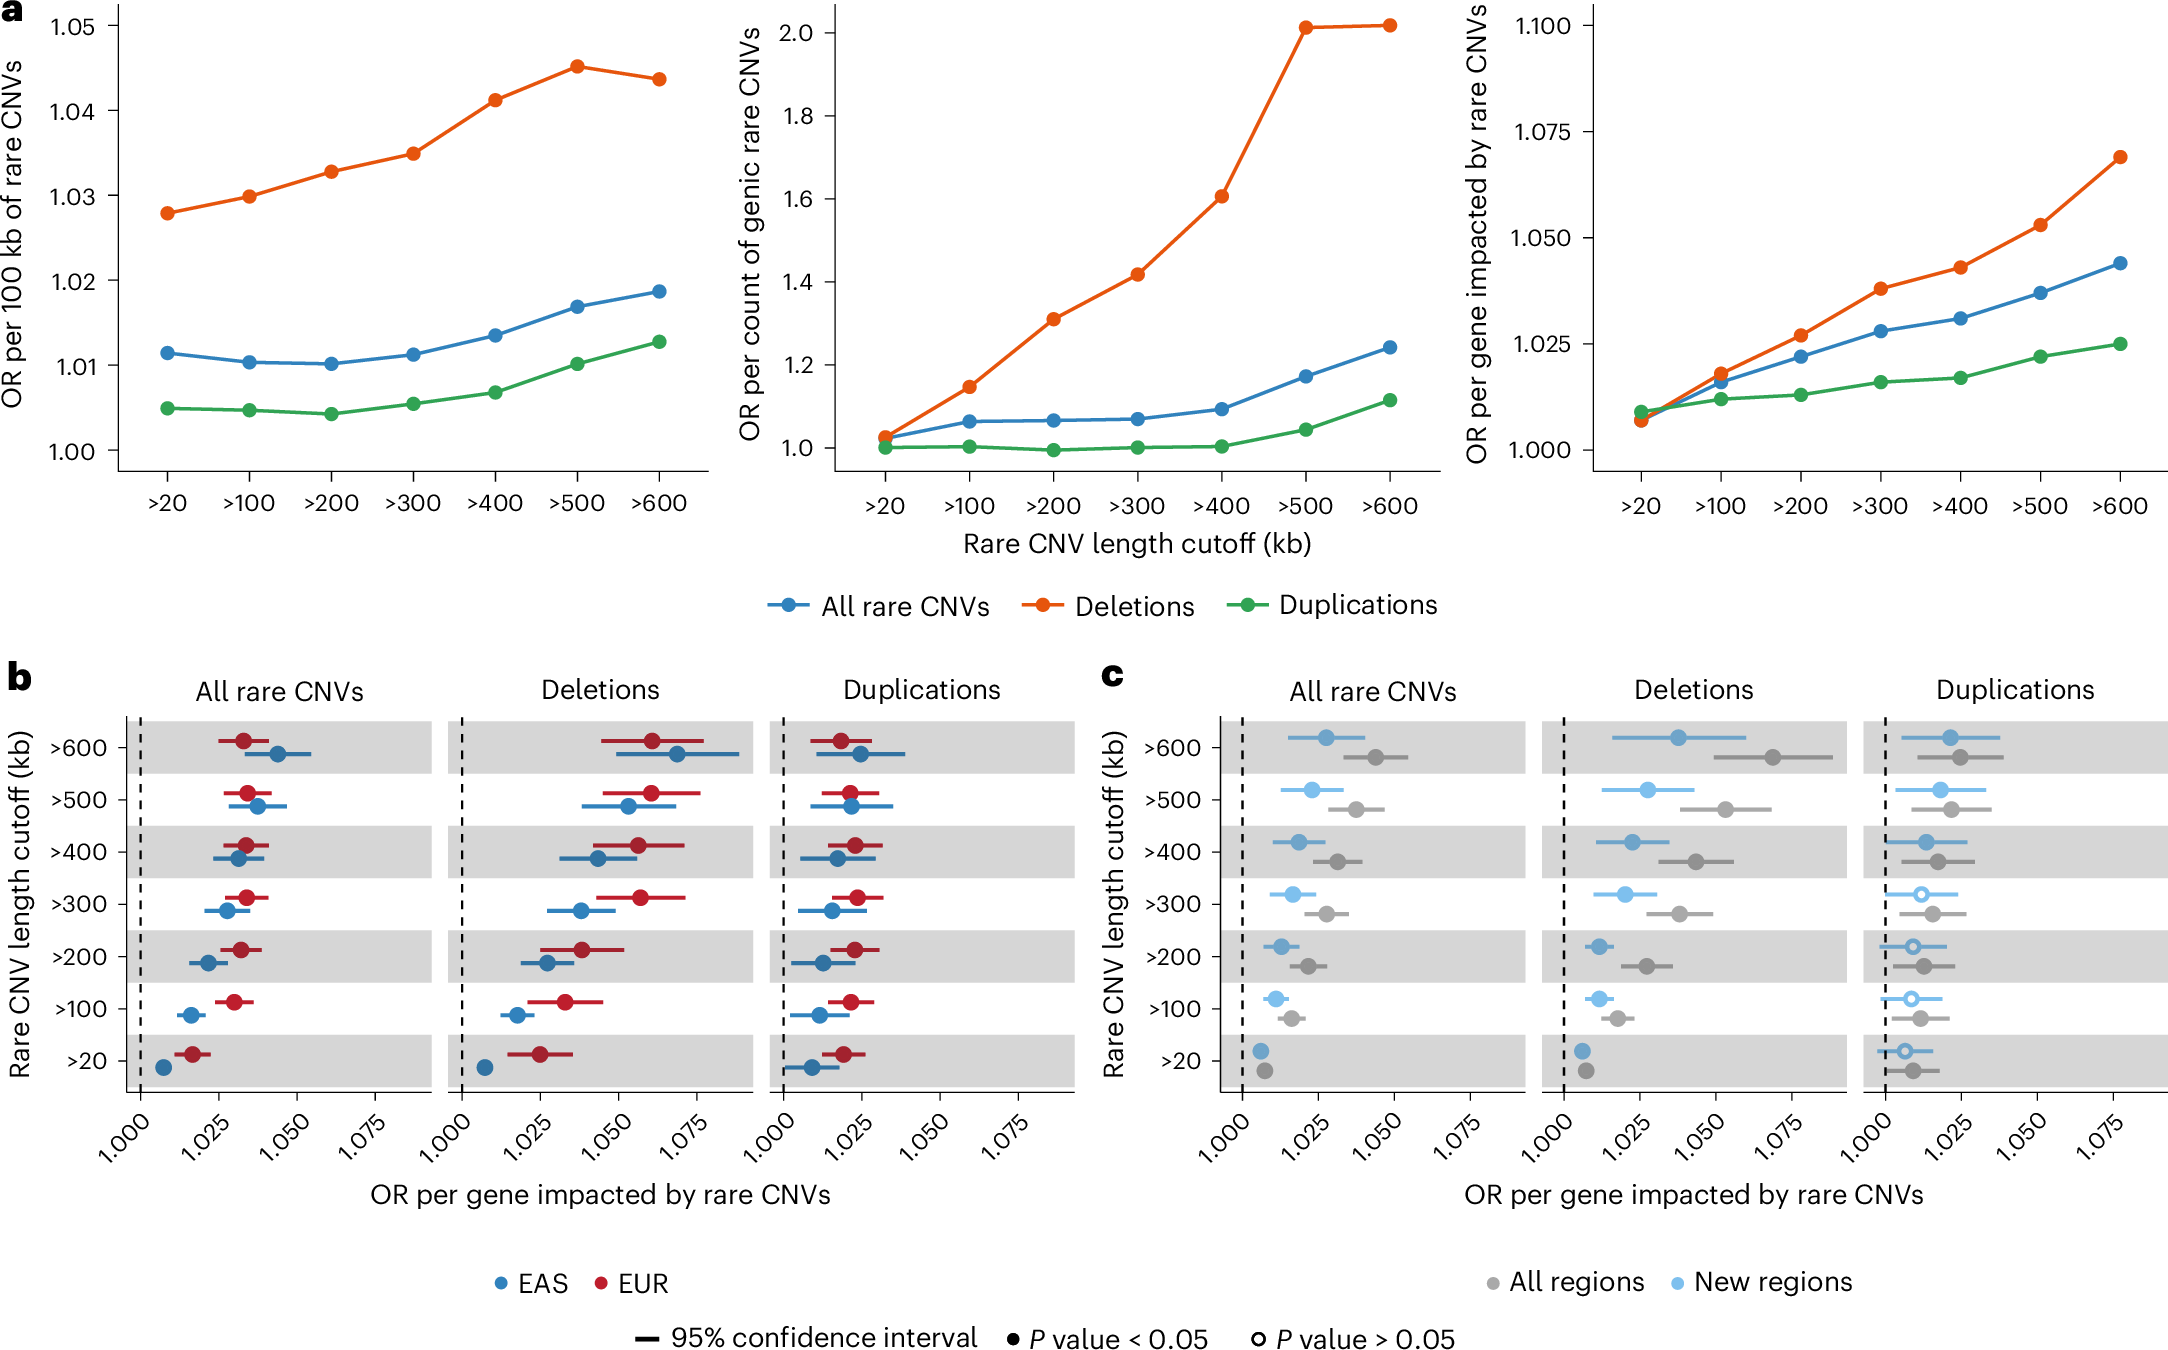
长度、事件数与受影响基因数对应不同OR单位。长缺失具有更强关联;去除既往位点后仍有负担,但嵌套长度阈值不是独立复制。
Chen et al., Nature Genetics 2026, Figure 2;出版商原始图像。 · CC BY 4.0 · 原图未修改 · 原文图 · 放大去除既往关联 CNV 区域后,病例负担仍显著,支持已知位点没有解释全部关联。长度阈值是嵌套分层:大于 600 kb 的集合属于大于 500 kb 的集合,不能视作多次独立复制。大 CNV 的每基因 OR 更高,还可能涉及基因组成、剂量敏感性与分段结构,而不只是物理长度的独立作用。
从分段到基因:REGENIE 两阶段与 Firth 校正
作者先构造“个体×基因×CNV 类型”的二元变量,而非把每一条不同断点的 CNV 当普通 SNP 检验:
仅检验至少八名携带者支持的基因。REGENIE 第一步利用经 LD pruning 的常见变异估计多基因背景;第二步将其作为 offset,调整性别、平台及 PCs,进行基因水平的 Firth-regularized logistic regression。关联部分可概括为
是第一阶段的 offset,不等同于在第二步显式估计完整 GRM 方差分量。Firth 校正缓解小携带者数和病例–对照分离造成的偏差;不是普通 ridge 或 SuSiE 先验。典型 Firth 形式是在 logistic 对数似然上加入 ,其中 是信息矩阵;这是帮助理解校正的标准数学表示。
22q11.21 的区域携带者为病例 41、对照 0,主文代表基因 OR 约 103.75。零对照携带者不意味着总体 OR 已知为无穷,也不能由病例–对照样本直接估计外显率。 OR 与 P 来自调整后的基因检验,区域总计数与某基因的外显子重叠计数也未必相同。
同一长 CNV 覆盖多个基因,会使多个 完全相同或高度相关。作者将对应 CNV 在参与者间重叠超过 50% 的显著基因归并为位点:87 个显著基因归为九个位点,不是 87 个独立因果基因。 进一步 prioritization 仍需断点差异、剂量–表达关系和功能证据。来源:Methods 的 Gene-level rare CNV association analysis、Table 2。
置换阈值控制的是什么
作者置换病例–对照标签 100 次,第 次重新关联并记录最小 P 值 ,再取这 100 个最小值的第 5 百分位:
东亚阈值为 6.88×10⁻⁵,meta-analysis 为 3.17×10⁻⁵。这是相关基因检验家族的经验阈值,不是常见 SNP GWAS 的 ,也不是说每个基因的关联 P 值只能取 0.01 以上。
“使用置换”不自动保证最终分析在所有条件下都控制 5% FWER。为降低计算量,置换排除了 trio-based 样本,东亚少检验 73 个基因、meta-analysis 少检验 56 个基因。阈值在与最终分析略有差异的样本及检验集合上估计。 100 次置换的尾部分位数也有 Monte Carlo 不确定性。
公开的标签脚本将 AFF 整列打乱,没有显示按平台或队列分层。若病例比例与队列、祖源坐标或技术变量相关,标签交换性需要额外论证。后续可用保留这些结构的置换或零模型参数模拟,并增加重复数;不能仅由脚本片段断言原结果失效,也不宜将经验阈值写成无条件校准保证。置换脚本
九个位点:新增发现并不全是风险增加
九个位点包含六类 deletion、三类 duplication;六个位点首次达到本文全基因组显著性,其中四个 deletion 区域此前没有在其欧洲文献清单中报告。“首次全基因组显著”与“此前从未报告”不是同一分类。
| 新区域 | 代表基因 | 代表基因 OR | 基因水平 P 值 |
|---|---|---|---|
| 8p21.3 deletion | DMTN | 9.09 | 8.14×10⁻⁸ |
| 19p13.3 deletion | TMEM259 | 3.74 | 2.12×10⁻⁷ |
| 11q13.1 deletion | MAP3K11 | 1.84 | 4.33×10⁻⁶ |
| 19q13.42 deletion | KIR3DL1 / KIR2DL4 | 0.42 | 5.38×10⁻⁶ |
这是 Table 2/3 的基因检验结果,不是独立 fine-mapping 得到的 effector gene 名单。尤其 19q13.42 是保护性关联,不能把所有新增 deletion 统称为“高风险缺失”。
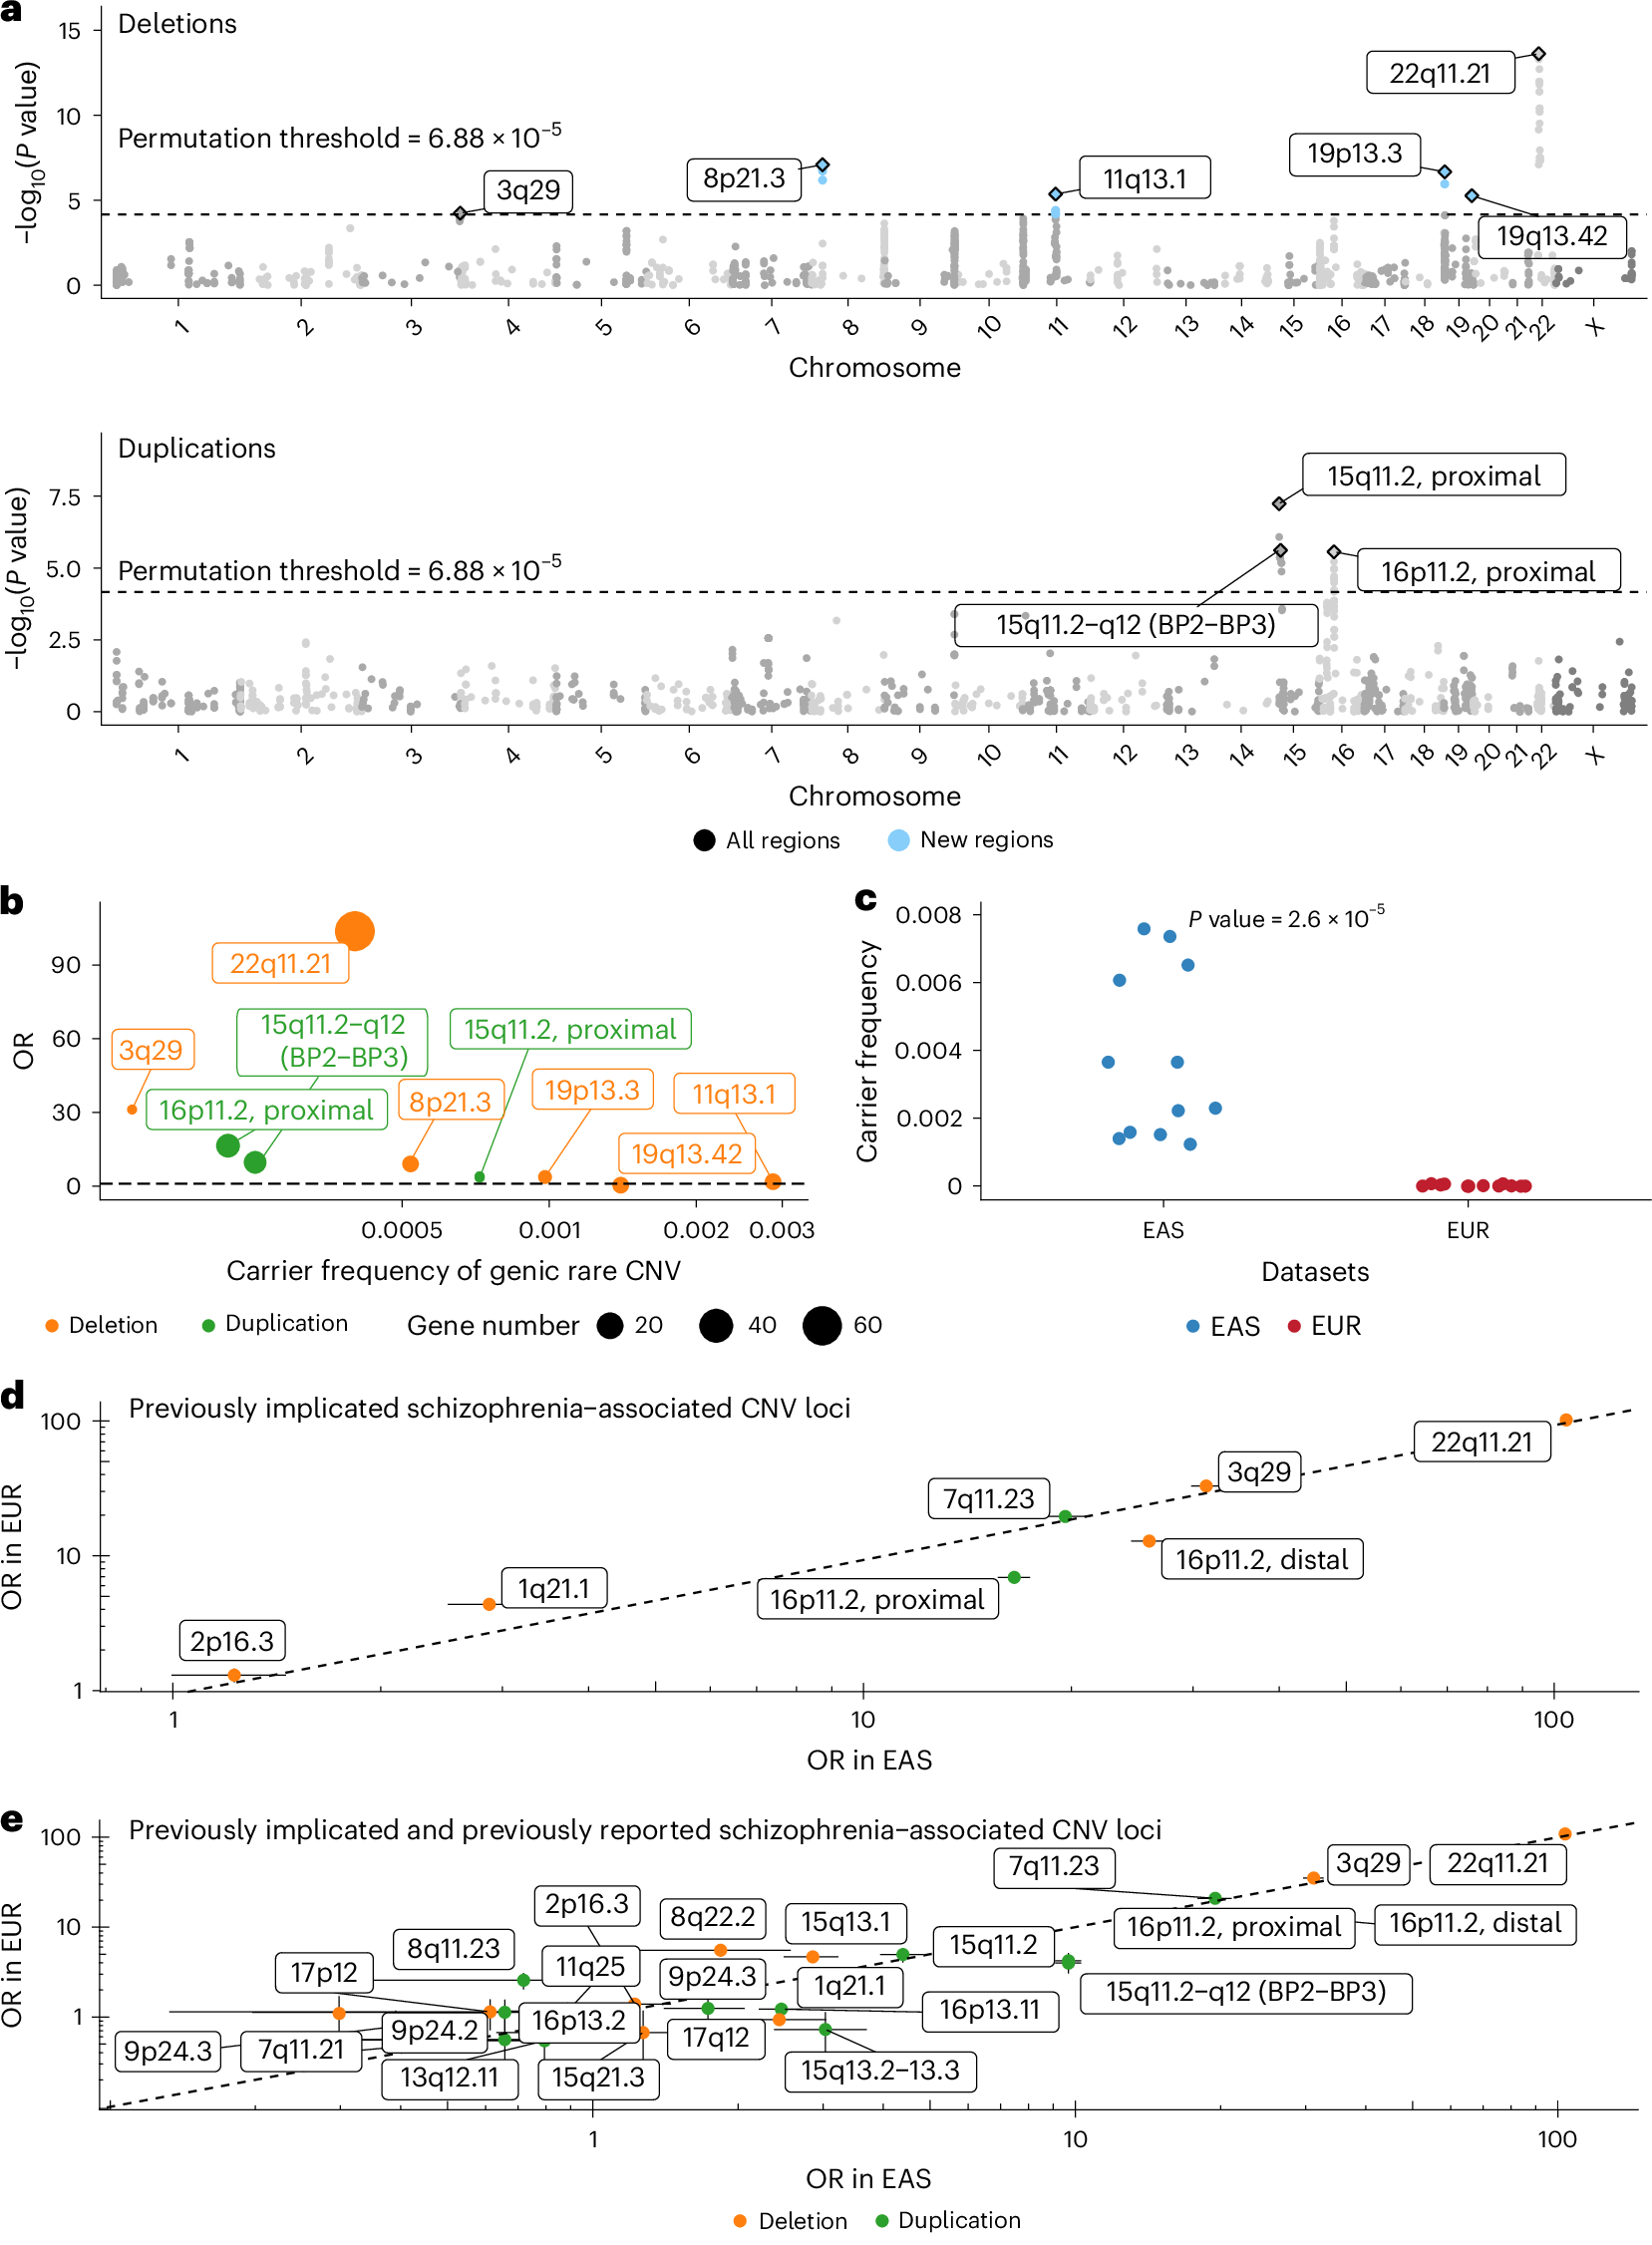
87个显著基因归并为9个区域;19q13.42为保护方向。新区域内12个基因的平均携带频率不是四个位点去重后的联合携带率;未检出异质性也不等于效应等价。
Chen et al., Nature Genetics 2026, Figure 3;出版商原始图像。 · CC BY 4.0 · 原图未修改 · 原文图 · 放大四个新区域内 12 个显著基因的相关 CNV 携带频率,平均为东亚 0.38%、欧洲 0.0017%。这不是全部 CNV 携带率,也不是四个位点去重后的联合携带率;同一分段影响多个基因会造成重复计算。先由东亚显著性筛选,再比较频率,还带有发现集合选择的影响。
既往欧洲八个全基因组显著位点有七个在东亚达到至少八名携带者,其中三个达到东亚全基因组显著,另三个达到名义显著。效应比较与 Cochran’s Q 未发现经校正的明确异质性,支持可检测位点上的效应大体相容,不等于证明所有 CNV 效应一致。欧洲几乎无携带者的新位点缺乏效应辨识信息,不能先宣称效应相等,再把全部收益归因于频率。
Meta-analysis:样本量加权 Z,而不是逆方差合并 OR
作者用 METAL 的 SCHEME SAMPLESIZE 整合基因检验的方向、P 值与样本量。其算法的通常表示为先构造有符号 ,再合并:
因此不能写成“逆方差加权得到共同 OR”。作者纳入 3,413 个基因,155 个显著基因归为 14 个位点,其中八个位点首次全基因组显著。Methods 允许纳入任一祖源有结果的基因,meta-analysis 显著不一定意味着两个祖源分别复制。METAL 配置
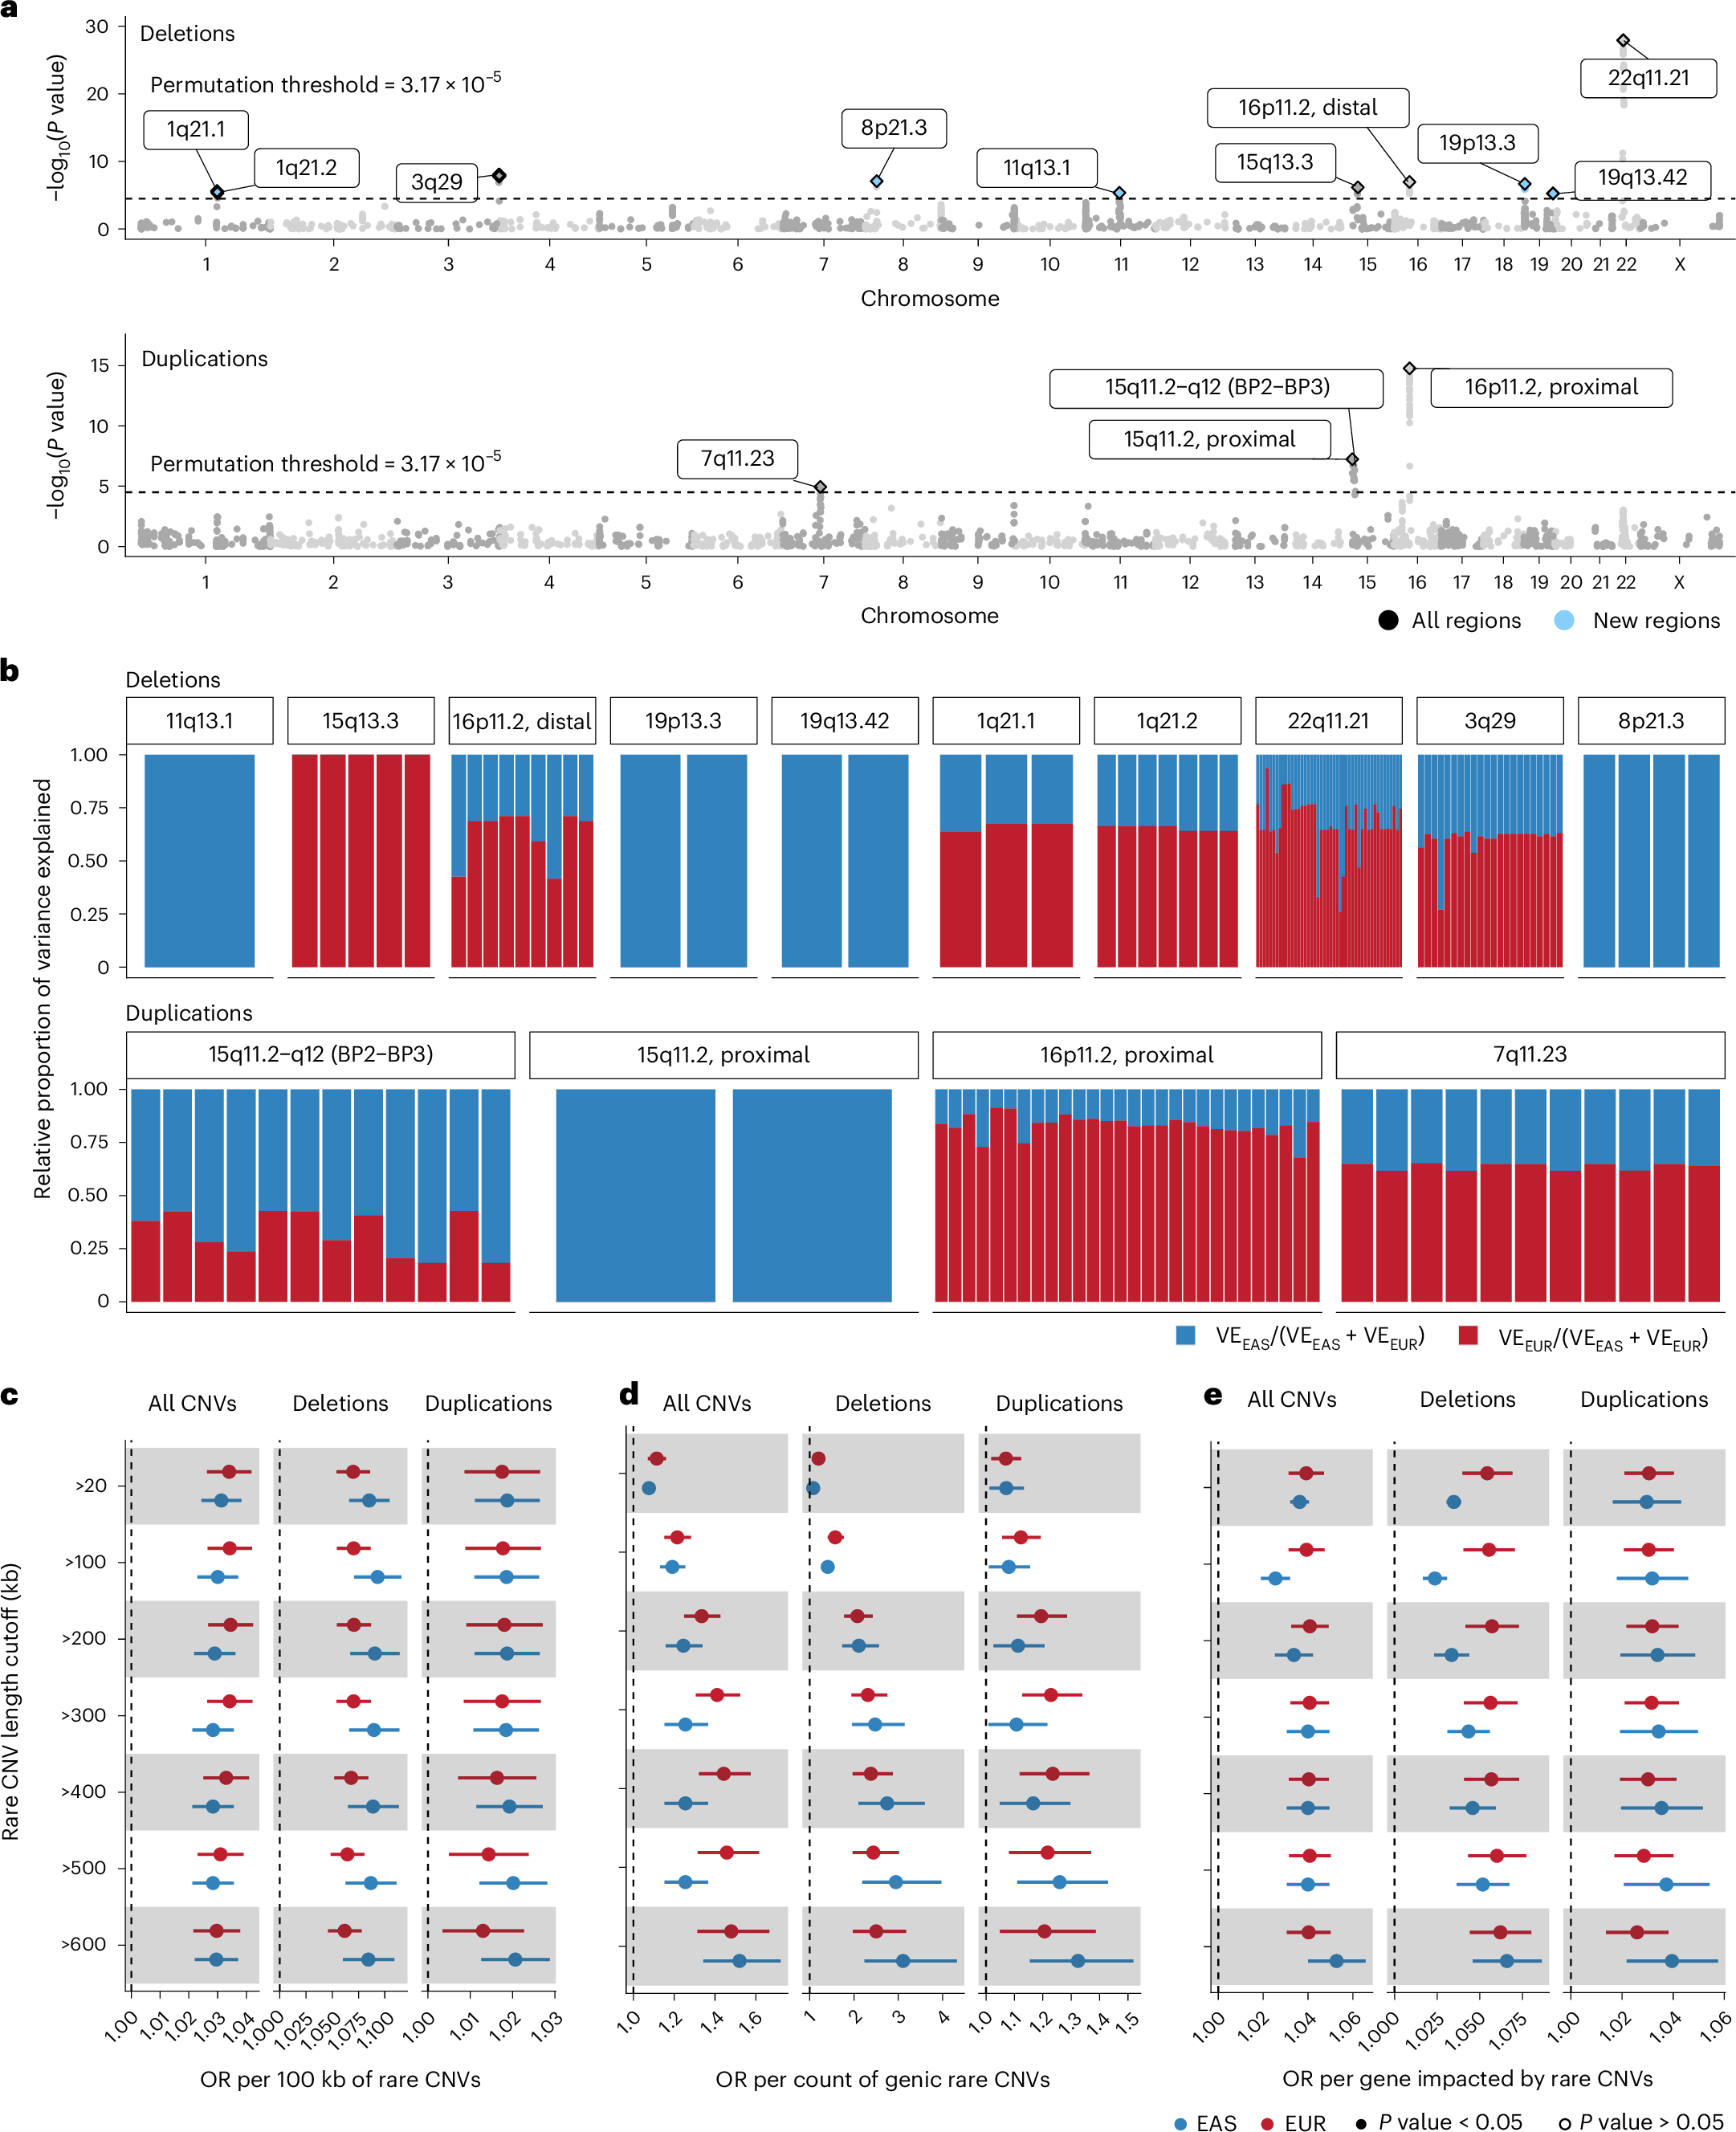
样本量加权meta-analysis提高发现能力;基因层面贡献按位点展示,同一区域的多个基因共享CNV,不能相加为独立遗传力。
Chen et al., Nature Genetics 2026, Figure 4;出版商原始图像。 · CC BY 4.0 · 原图未修改 · 原文图 · 放大Figure 4b 用 构造近似方差贡献,再显示祖源间相对份额。原文将 定义为携带频率。这个描述性指标不是 155 个基因可相加的遗传力分解:基因共享 CNV,病例–对照样本频率也不是外部人群频率。二元携带变量方差为 ,不同于二倍体等位剂量的 ;相同常数在相对比例中抵消,但绝对值不能据此解释为严格的 liability-scale variance explained。
CNV 与 PRS:互补风险、病例选择与交互尺度
PRS-CS 使用既往东亚精神分裂症 GWAS 和 1000 Genomes 东亚 LD,固定全局收缩参数 0.01,去除链模糊变异及 MHC,再在未参与发现 GWAS 的样本中计算、标准化 PRS。这不是 PRS-CS-auto。
作者比较协变量模型、单独 CNV、单独 PRS、相加模型及乘积项模型。交互部分可表示为
其中 和 按分析规则标准化。主文报告大 deletion 携带病例的平均 PRS 较低(0.39 对 0.49,P=0.01),且 CNV 负担在调整 PRS 后仍有关联。但 Supplementary Table 9 显示交互不能统一概括:
| 负担指标 | CNV×PRS 系数 | 乘积项 P 值 | 可以支持的表述 |
|---|---|---|---|
| 受影响基因数 NGENE | −0.030 | 8.1×10⁻⁹ | 该指标下,负担增加与 PRS 的 log-odds 斜率减弱相关 |
| 分段总长度 KB | −0.0092 | 0.088 | 没有明确交互证据 |
| 分段数 NSEG | +0.020 | 0.003 | 方向为正,不支持统一的“补偿”描述 |
Table 9c 的 liability-scale R² 约为 PRS 0.0267、CNV 受影响基因数 0.00258;Table 9d 在 PRS 模型上增加 NGENE 的增量为 0.00238。该表另列 NGENE 回归 P=0.000209 与模型比较的似然比检验 P=0.00209,两者不能混用。Supplementary Table 9
这些结果不能简化为“罕见 CNV 与常见变异在分子上相互补偿”。病例内较低 PRS 可能来自以患病为条件的选择:当疾病由多种遗传贡献推动时,较强的一项可与较弱的另一项在被选中病例内相关。正式乘积项超出了病例内均值比较,但解释仍依赖 logistic 尺度、负担线性假设及少数高负担观察值。非线性负担、删除高杠杆样本、分队列复制及诊断误分类情景,是本笔记建议的进一步检查,不是作者已完成的实验。
作者按精神分裂症人群患病率 1% 将增量 R² 转换到 liability scale。这依赖特定患病率假设,不是从病例–对照比例直接读出的人群解释率,也不是独立验证集预测性能。
技术验证覆盖四个位点,而不是八个
WES 用 GATK-gCNV 独立检测,ddPCR 验证选择的区域。主文概括“八个新位点在可用样本中验证成功”,但 Supplementary Note 明确指出:只有四个位点有可用生物样本,另外四个没有完成 WES/ddPCR 验证。
Supplementary Table 17b 列出 15q11.2 proximal 的 18/18、15q11.2–q12 BP2–BP3 的 14/14、15q13.3 的 3/3、1q21.2 的 16/16,共 51/51 WES 验证。另有三名无 WES 的待验证携带者通过 ddPCR 得到支持,还纳入七名 WES 已确认携带者及三名阴性对照。补充文字对 1q21.2 携带者总数另有不一致,故这里逐列引用表格,不拼接为新合计。
东亚发现中此前未报告的 8p21.3、11q13.1、19p13.3、19q13.42 均因缺少生物样本而未完成上述正交验证。它们恰是“东亚频率较高带来新发现”的核心例子。跨队列/平台支持和强度图仍有价值,但不能替代同一事件的独立测量。
更广泛的可验证外显子重叠事件中,Table 17a 为 deletion 3,502/4,324(81%)、duplication 3,942/4,928(80%)。这与特定位点 51/51 是不同分母,既不能推断全体 CNV 零错误,也不能将约 20% 不一致全部认定为芯片假阳性。最重要的是,技术验证确认 copy-number event,不是复制疾病 OR,更不是证明区间内每个基因都是功能靶点。Supplementary Note 的 WES validation、Supplementary Tables 17–18。
约束富集与尚未闭合的基因机制
作者在 3,063 个 pLI>0.9 的 LoF-intolerant 基因中看到更强的 CNV 负担,并对 SynGO 基因集富集,使用 10,360 个脑组织表达基因为背景。这个背景比直接用所有基因更有针对性,但不能完全解决长 CNV 的基因相关性和芯片覆盖概率差异。
pLI 不是 CNV 致病后验概率;duplication 的三倍剂量敏感性尤其不能等同于 LoF intolerance。主文 155 个显著基因的平均 pLI 为 0.28、其他受检基因为 0.17,也不意味着每个显著基因都高度受约束。将区域关联推进到单个 effector gene,需要进一步区分共同受影响的基因及其细胞背景,而非仅列出可能相关的通路。
对统计遗传与单细胞 QTL 研究的具体启示
跨祖源设计应分开评估“能否看见”和“效应是否相同”。 在统一测量条件下估计事件检出概率,再评估频率、效应与功效;不能把检测灵敏度差异直接解释为人群生物学差异。对低频 QTL,除样本总数外,还应比较有效携带 donor 数,而不是细胞数。
基因集合关联不能替代因果基因定位。 可针对同一 CNV 联合分析跨 donor 的断点变化、细胞类型特异表达剂量效应和疾病关联。多个基因共享完全相同的携带向量时,同一病例–对照模型无法区分它们;全部赋予高功能先验会重复计算同一证据。
校准应覆盖整个分析流程。 一个可检验的模拟设计是保留真实亲缘、平台和病例比例,变化事件频率、分段长度、基因重叠、caller 假阴性和跨祖源效应;重跑筛选、编码、关联、阈值与归并,评价 FWER、功效与效应覆盖率。这些是方法开发建议,不是作者已验证的单细胞扩展。
原文一致性与可复用材料
除负担模型书写与 binomial 实现差异外,Methods 的跨祖源 Z 公式在分母中同时使用了标为标准误的 SE 和额外的样本量除数。若 SE 确为估计量标准误,通常的独立效应差值标准误应为 。本笔记保留待澄清的符号问题,不按印刷式重算或据此否定所有异质性结果。补充说明的旧式全基因 Bonferroni 阈值 1.3×10⁻⁶ 也不同于主文最终置换阈值;这里使用主文最终发现清单,同时保留不同分析口径。
本次核读上传的 31 页期刊 PDF、期刊 HTML、Supplementary Note,以及负担、PRS、WES、ddPCR 相关表和公开代码。Supplementary Data 个体强度图未逐张重新审计,未重跑个体关联、置换或 PRS。数学解释与研究建议是本笔记的分析,不是作者完成的额外实验。
论文及补充材料;关联汇总统计量;CNV calling/QC 代码;下游关联代码。个体数据仍须遵循各队列申请条件。