Malva:在数千万单细胞原始 reads 中直接检索序列
Ultrafast and reference-free sequence discovery in single-cell data
Malva 把单细胞和空间转录组原始 reads 分解为 24-mers,以稀疏倒排索引保存 k-mer 到 cell identifier 的映射,使突变、剪接连接、病原体和未注释序列可在数千万细胞中直接检索。
本文目录
研究问题
大多数单细胞数据库只保存或公开 cell-by-gene count matrix。原始 reads 中的剪接连接、突变、病原体、未注释 RNA 和技术构建序列在比对和定量后被折叠掉。若研究者后来提出新的序列问题,通常需要重新下载 FASTQ、比对并处理大量数据。
Malva 的目标是预先把公共单细胞与空间测序 reads 建成可搜索索引,使任意核酸序列都能直接返回包含它的细胞、样本和空间位置。
索引结构
Malva 默认使用 。每条 read 被拆成非重叠 24-mers,并在末端加入一个重叠 k-mer 以覆盖尾部。每个 k-mer 可用 2-bit nucleotide encoding 转成整数。
索引类似搜索引擎的倒排表,由三部分组成:
- sequence array:排序后的唯一 k-mer;
- location array:每个 k-mer 出现在哪些 cell–dataset identifiers 中;
- pointer array:指出某个 k-mer 在 location array 中的起止位置。
查询一个 24-mer 时,只需在 sequence array 中二分查找一次,再读取对应的稀疏 cell list。不存在该序列的细胞不占存储空间,因此内存和磁盘访问由实际出现位置决定,而不是由“总细胞数 × 全部 k-mers”决定。
为什么能够扩展到数千万细胞
每个样本独立索引
FASTQ 先在 sample level 独立处理,再把排序后的 k-mer 和 cell list 增量合并。新增数据不要求重建全部索引,适合持续扩展的公共数据库。
不构建 de Bruijn graph
Malva 不为所有相邻 k-mer 建图,从而避开序列多样性极高时的巨大边集合。代价是它主要支持精确序列存在性与 coverage-like 查询,而不是在索引中直接完成 assembly。
查询时间与稀疏位置列表相关
常见 24-mer 可能对应很长的 cell list;稀有突变或病原体序列通常只读取较短列表。完整转录本由多个窗口组成,查询成本随序列长度和命中列表增加,但不需要扫描全部细胞。
长序列的匹配分数
对长度大于 的查询,Malva 在窗口 中检查多个 k-mers。论文给出的 cell-level match score 可写为
其中 是窗口 中在细胞 被索引到的 k-mers, 是窗口长度。低复杂度 k-mers 会被 mask,用户也可以过滤在参考转录组中过于常见的序列。
该分数是 k-mer coverage,不是 read alignment likelihood,也不是 UMI molecule count。不同 read length、3’ bias、测序深度和 PCR duplication 都会影响它。
性能结果
作者用约 610 亿 reads 的 Stereo-seq 小鼠肝脏数据测试索引。Malva 在 24 CPU-hours 内完成,峰值内存约 8 GB;与比较的 k-mer indexing 或 reference mapping 流程相比,速度提高约 4–25 倍。运行速度最终接近 gzip FASTQ 解压上限,说明瓶颈已经从计算转移到输入吞吐。
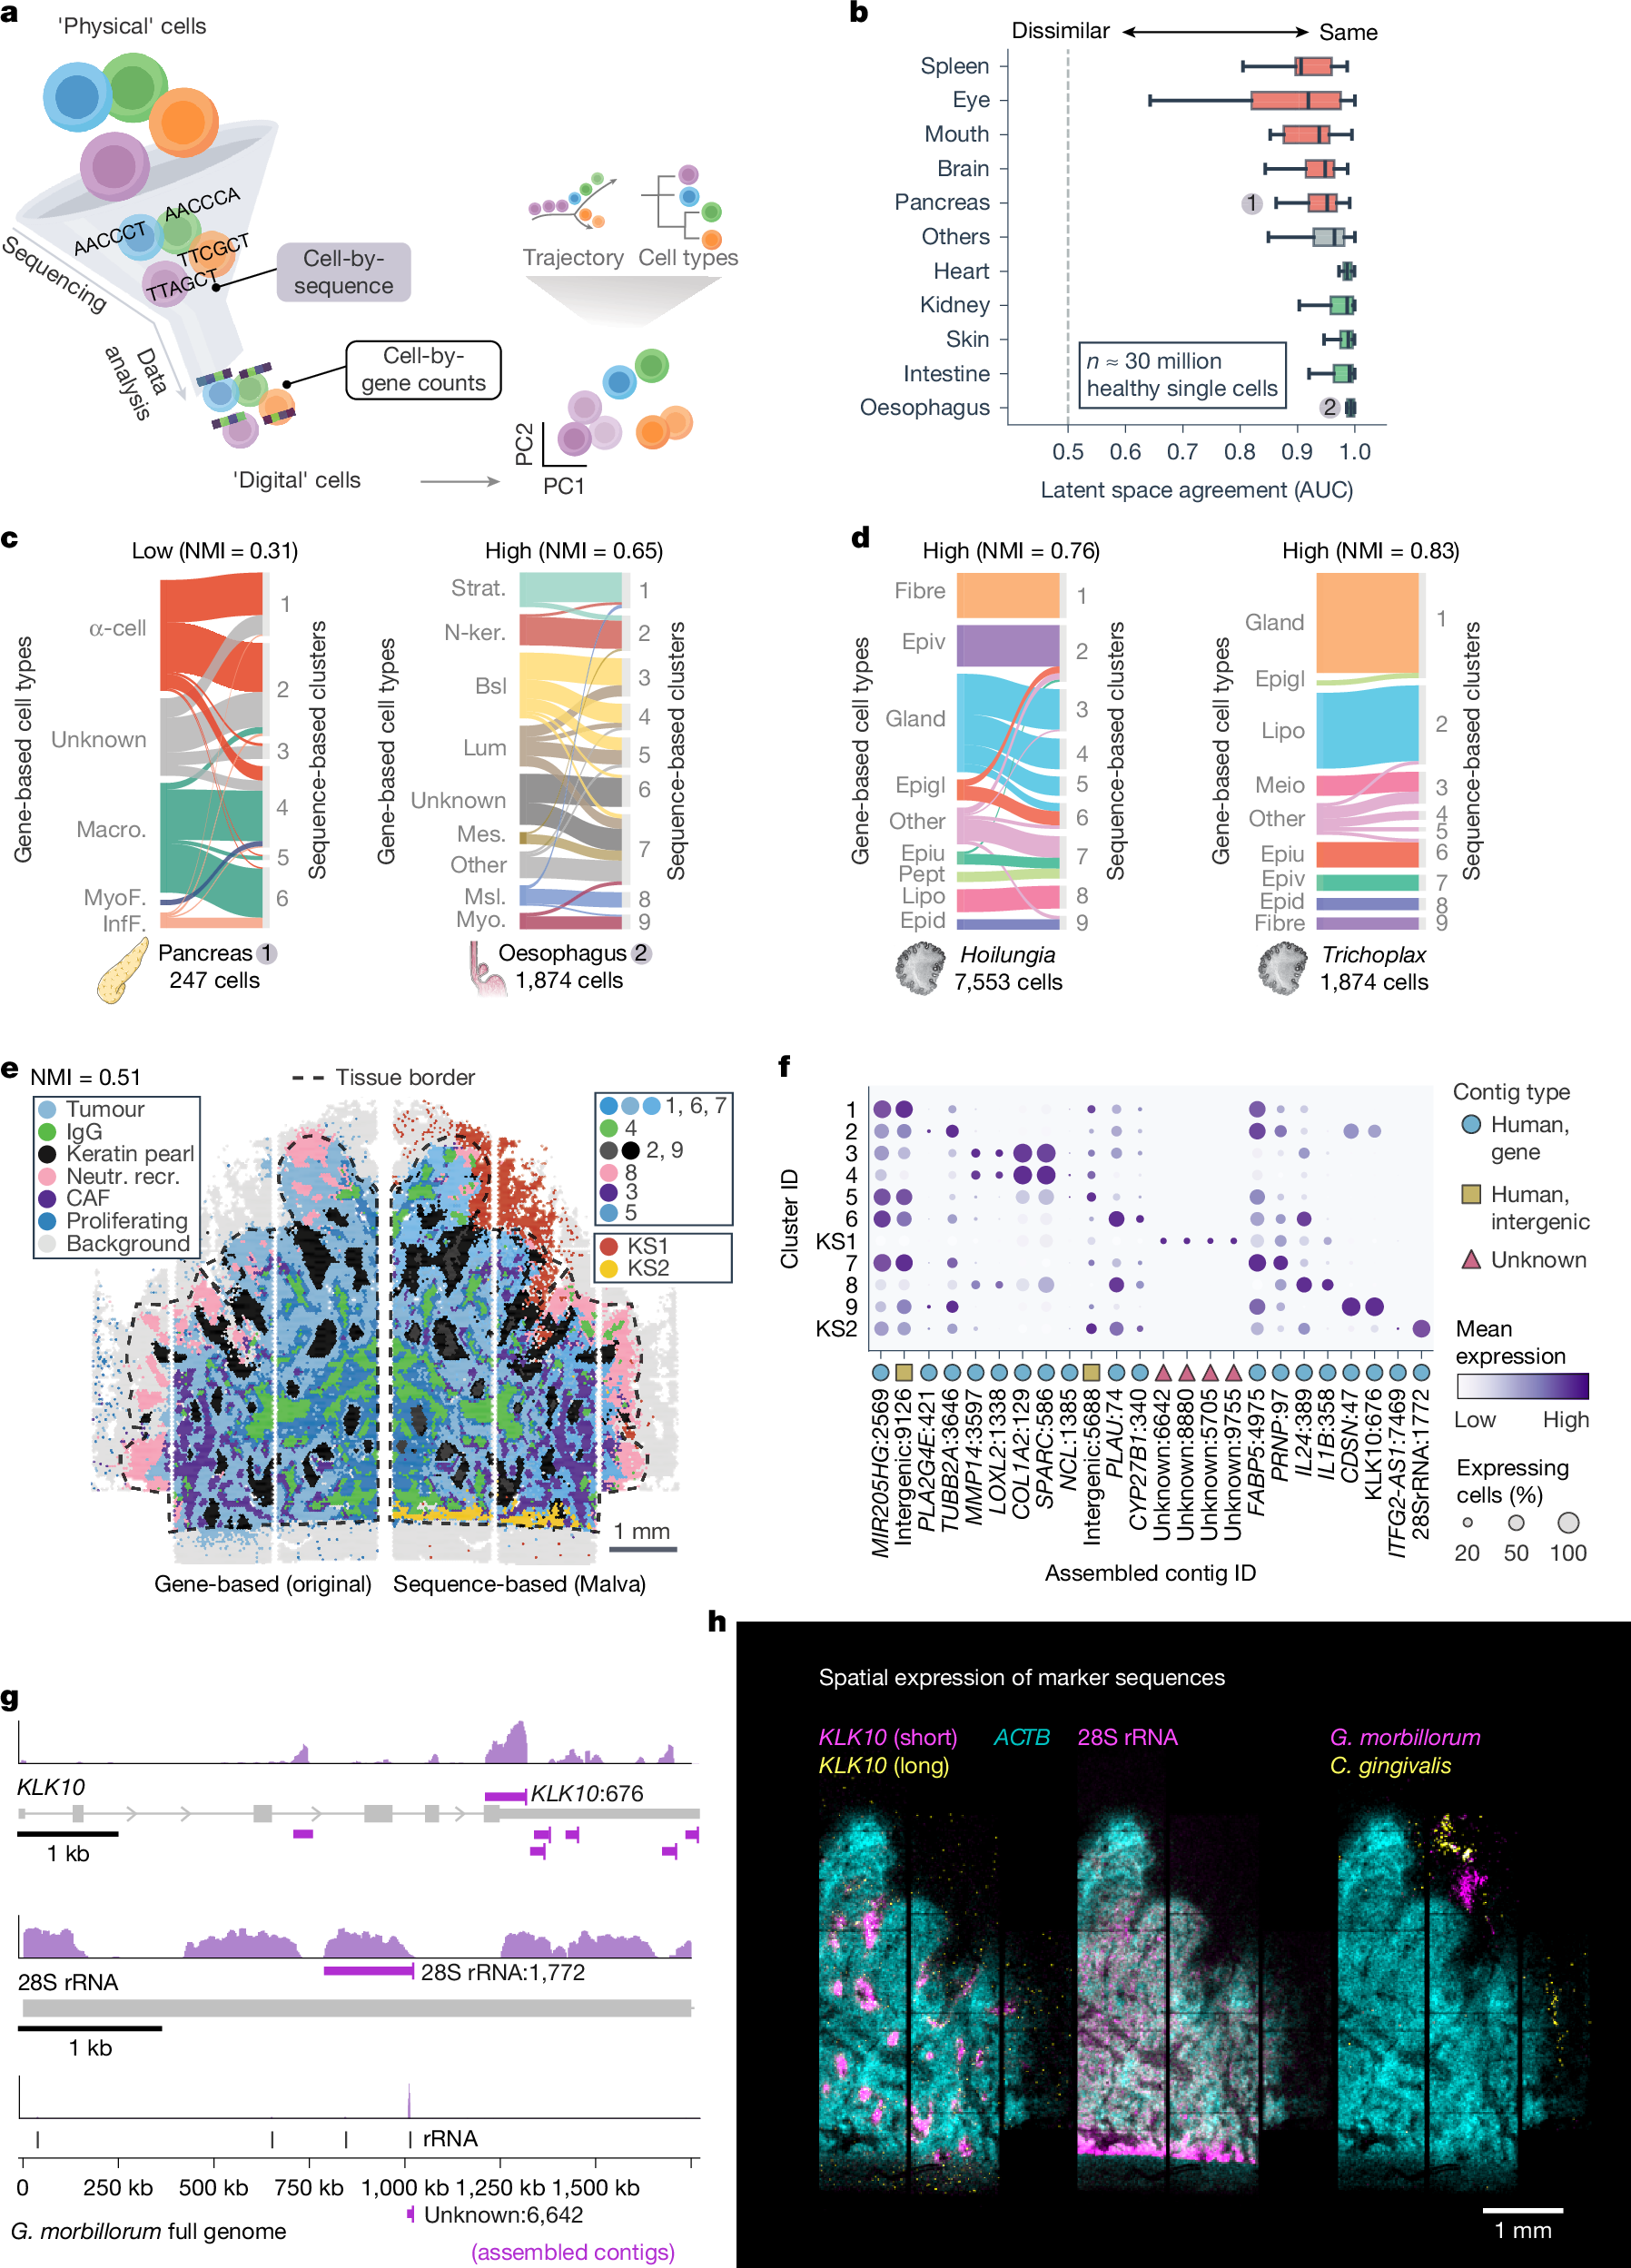
图中比较 sequence-bucket 与 gene-count 表示的邻域和聚类,并在肿瘤空间数据中组装 cluster-specific 序列。重点看哪些结构与 gene-based 分析一致,哪些只由序列表示揭示。
León-Periñán, Karaiskos & Rajewsky, Nature (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大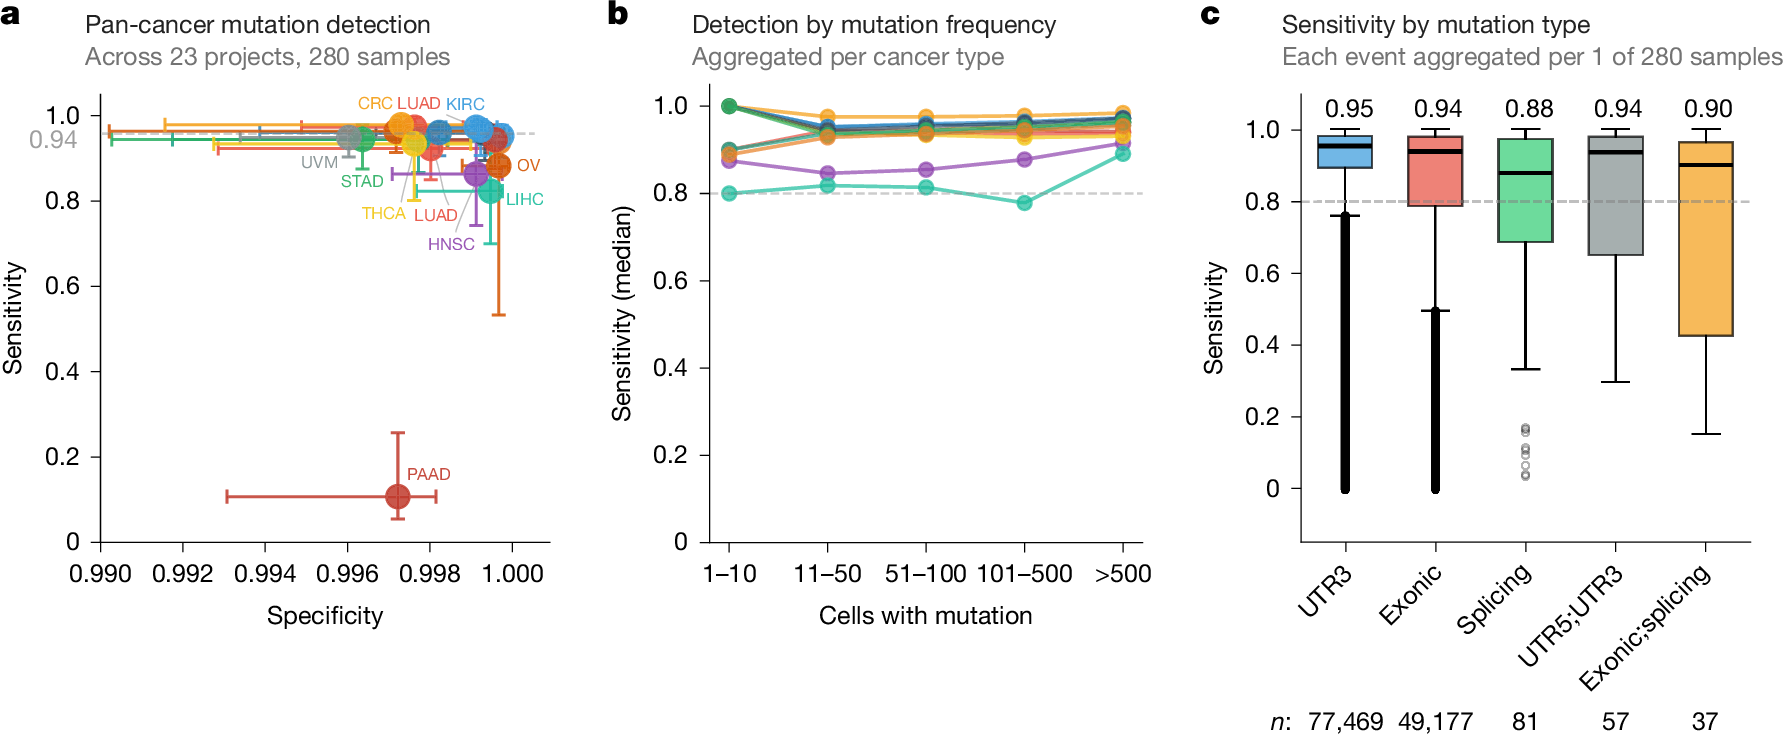
与 scTML 的匹配突变调用比较,图中给出不同癌种的 sensitivity 与 specificity,并检验变异出现细胞数和基因组位置对检出率的影响。
León-Periñán, Karaiskos & Rajewsky, Nature (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大论文构建时处理超过 140 TB 公共单细胞与空间数据,总 wall-clock time 约 70 小时、累计约 9,700 CPU-hours。分析版本的人类索引包含约 5,100 万细胞、592 个 studies、7,966 个 samples 和超过 1,000 亿个唯一 24-mers,另有约 1,000 万个小鼠细胞。在线索引此后扩展到约 7,400 万细胞。
在完整索引上,短序列通常毫秒级返回,完整 cDNA 为秒级,数千 transcript 的集合为分钟级。这里应同时关注服务器并发和缓存:单次 benchmark 并不等同于大量用户同时查询时的尾延迟。
序列索引与检索结果
上半部分说明现有两类工具的缺口:single-cell portal 没有 sequence search,bulk sequence index 没有 cell resolution。下半部分展示 Malva 的输出不是一个简单“命中/未命中”,而是:
- 含该序列的细胞和样本;
- 按 cell type 或 disease 分层的 pseudocount;
- 沿查询序列的 coverage;
- 有空间坐标时的组织分布。
自然语言入口只负责把概念转成 gene/sequence query。真正决定可重复性的是解析后的序列集合、过滤条件和索引版本,因此分析应保存结构化 query,而不只保存自然语言提示。
算法加速上的启发
Malva 的加速主要来自算法和系统设计:
- 使用定长整数编码,减少字符串比较;
- 稀疏倒排表避免 dense cell × sequence matrix;
- 排序数组支持顺序磁盘访问和二分查找;
- sample-level 并行与增量 merge 降低全局内存需求;
- 当 gzip decompression 成为瓶颈后,继续优化 k-mer kernel 的收益有限。
因此它不是典型 GPU acceleration 论文。对这类工作,最重要的 profiling 问题是 CPU time、解压吞吐、磁盘 IOPS、page cache 和网络存储,而不是 GPU utilization。
生物学应用与边界
Malva 可以检索已知突变、splice junction、病毒或细菌序列,以及 reference annotation 中没有的 RNA。作者还用序列组成构造 cell similarity 和 cell-type marker sequences。
但精确 k-mer 匹配对读长、测序错误和覆盖位置敏感。短于 24 nt 的 query 不支持;含高变异或较高错误率的序列可能漏检。论文模拟表明常见测序错误率下性能稳定,但非常高的错误率会逐渐降低 sensitivity。
局限
- 输出是 k-mer-derived pseudocount,不是严格 UMI 定量;
- 大量公共数据为 3’ biased short-read,不能均匀覆盖完整 transcript;
- cell type 与 disease metadata 来自不同 studies,标准化质量不一;
- exact matching 对近似同源序列和等位基因差异敏感;
- donor-specific sequence query 可能暴露遗传信息,访问控制和审计很重要;
- 数据库版本持续变化,同一 query 的样本集合可能随时间增长。
小结
Malva 把“重新处理 140 TB FASTQ”转化为“读取一个稀疏倒排表”。这是单细胞计算中很典型的高价值加速:不是在原有矩阵流程上寻找更快 kernel,而是保留新的信息层,并为最常见查询重新设计数据结构。