非线性 PRS:遗传架构与样本量如何决定预测收益
Genetic Architecture and Sample Size Impact Relative Performance of Nonlinear Machine Learning and Standard Polygenic Risk Scores
理论、模拟和 UKB 预测显示,非线性模型的收益取决于尚未被加性投影捕获的交互方差及训练样本量;在固定 SNP 集合的缺血性心脏病分析中,XGBoost 未见明显优势。
本文目录
已核对 v1 主文、理论推导、模拟、UKB 结果和作者代码;未取得补充表 S1–S2。
这篇论文讨论一个比“机器学习能否胜过 PRS”更具体的问题:在线性预测器尚未捕获的遗传变异中,有多少信号足够集中、足够强,能由有限样本中的非线性模型稳定学到?作者结合理论、受控模拟和缺血性心脏病预测,比较标准 PRS、elastic net、随机森林与 XGBoost。原文
边际效应不等于机制模型中的主效应
设两个相互独立、满足 Hardy–Weinberg 平衡的 SNP,其等位基因剂量为 ,遗传值为
加性 GWAS 对第一个 SNP 估计的总体边际斜率为 。因此,生物学机制中的交互项可以对统计学加性效应作出贡献。将交互项中心化后,线性模型真正无法表示的是 这一正交部分。这并不意味着加性 PRS 能解释超过加性遗传方差的变异;它说明的是,统计学加性方差与机制层面的“没有交互”不是同一概念。
模拟真正控制了什么
作者模拟 200 个独立常见 SNP,MAF 均匀分布于 0.1–0.5,设广义遗传力 。交互遗传方差占比 从 0 增至 0.5,交互 SNP 对数取 2、20、199;总样本量为 10,000 或 100,000,按 80%/20% 划分训练和测试,故实际训练量是 8,000 或 80,000。每种表型有 36 个配置,各重复 100 次;二元表型采用患病率目标为 10% 的 liability-threshold 模型。
四种方法使用完全相同的 200 个 SNP。标准 PRS 用训练集边际回归效应加权;elastic net 控制“拥有个体数据”本身的收益;XGBoost 与 elastic net 在训练集内三折交叉验证,随机森林使用袋外验证。Figure 2 显示,交互方差越集中、训练样本越大,XGBoost 越可能取得明显增益;较低交互占比时,线性方法仍很有竞争力。这里没有一个可直接移植到任意真实性状的交互比例阈值。
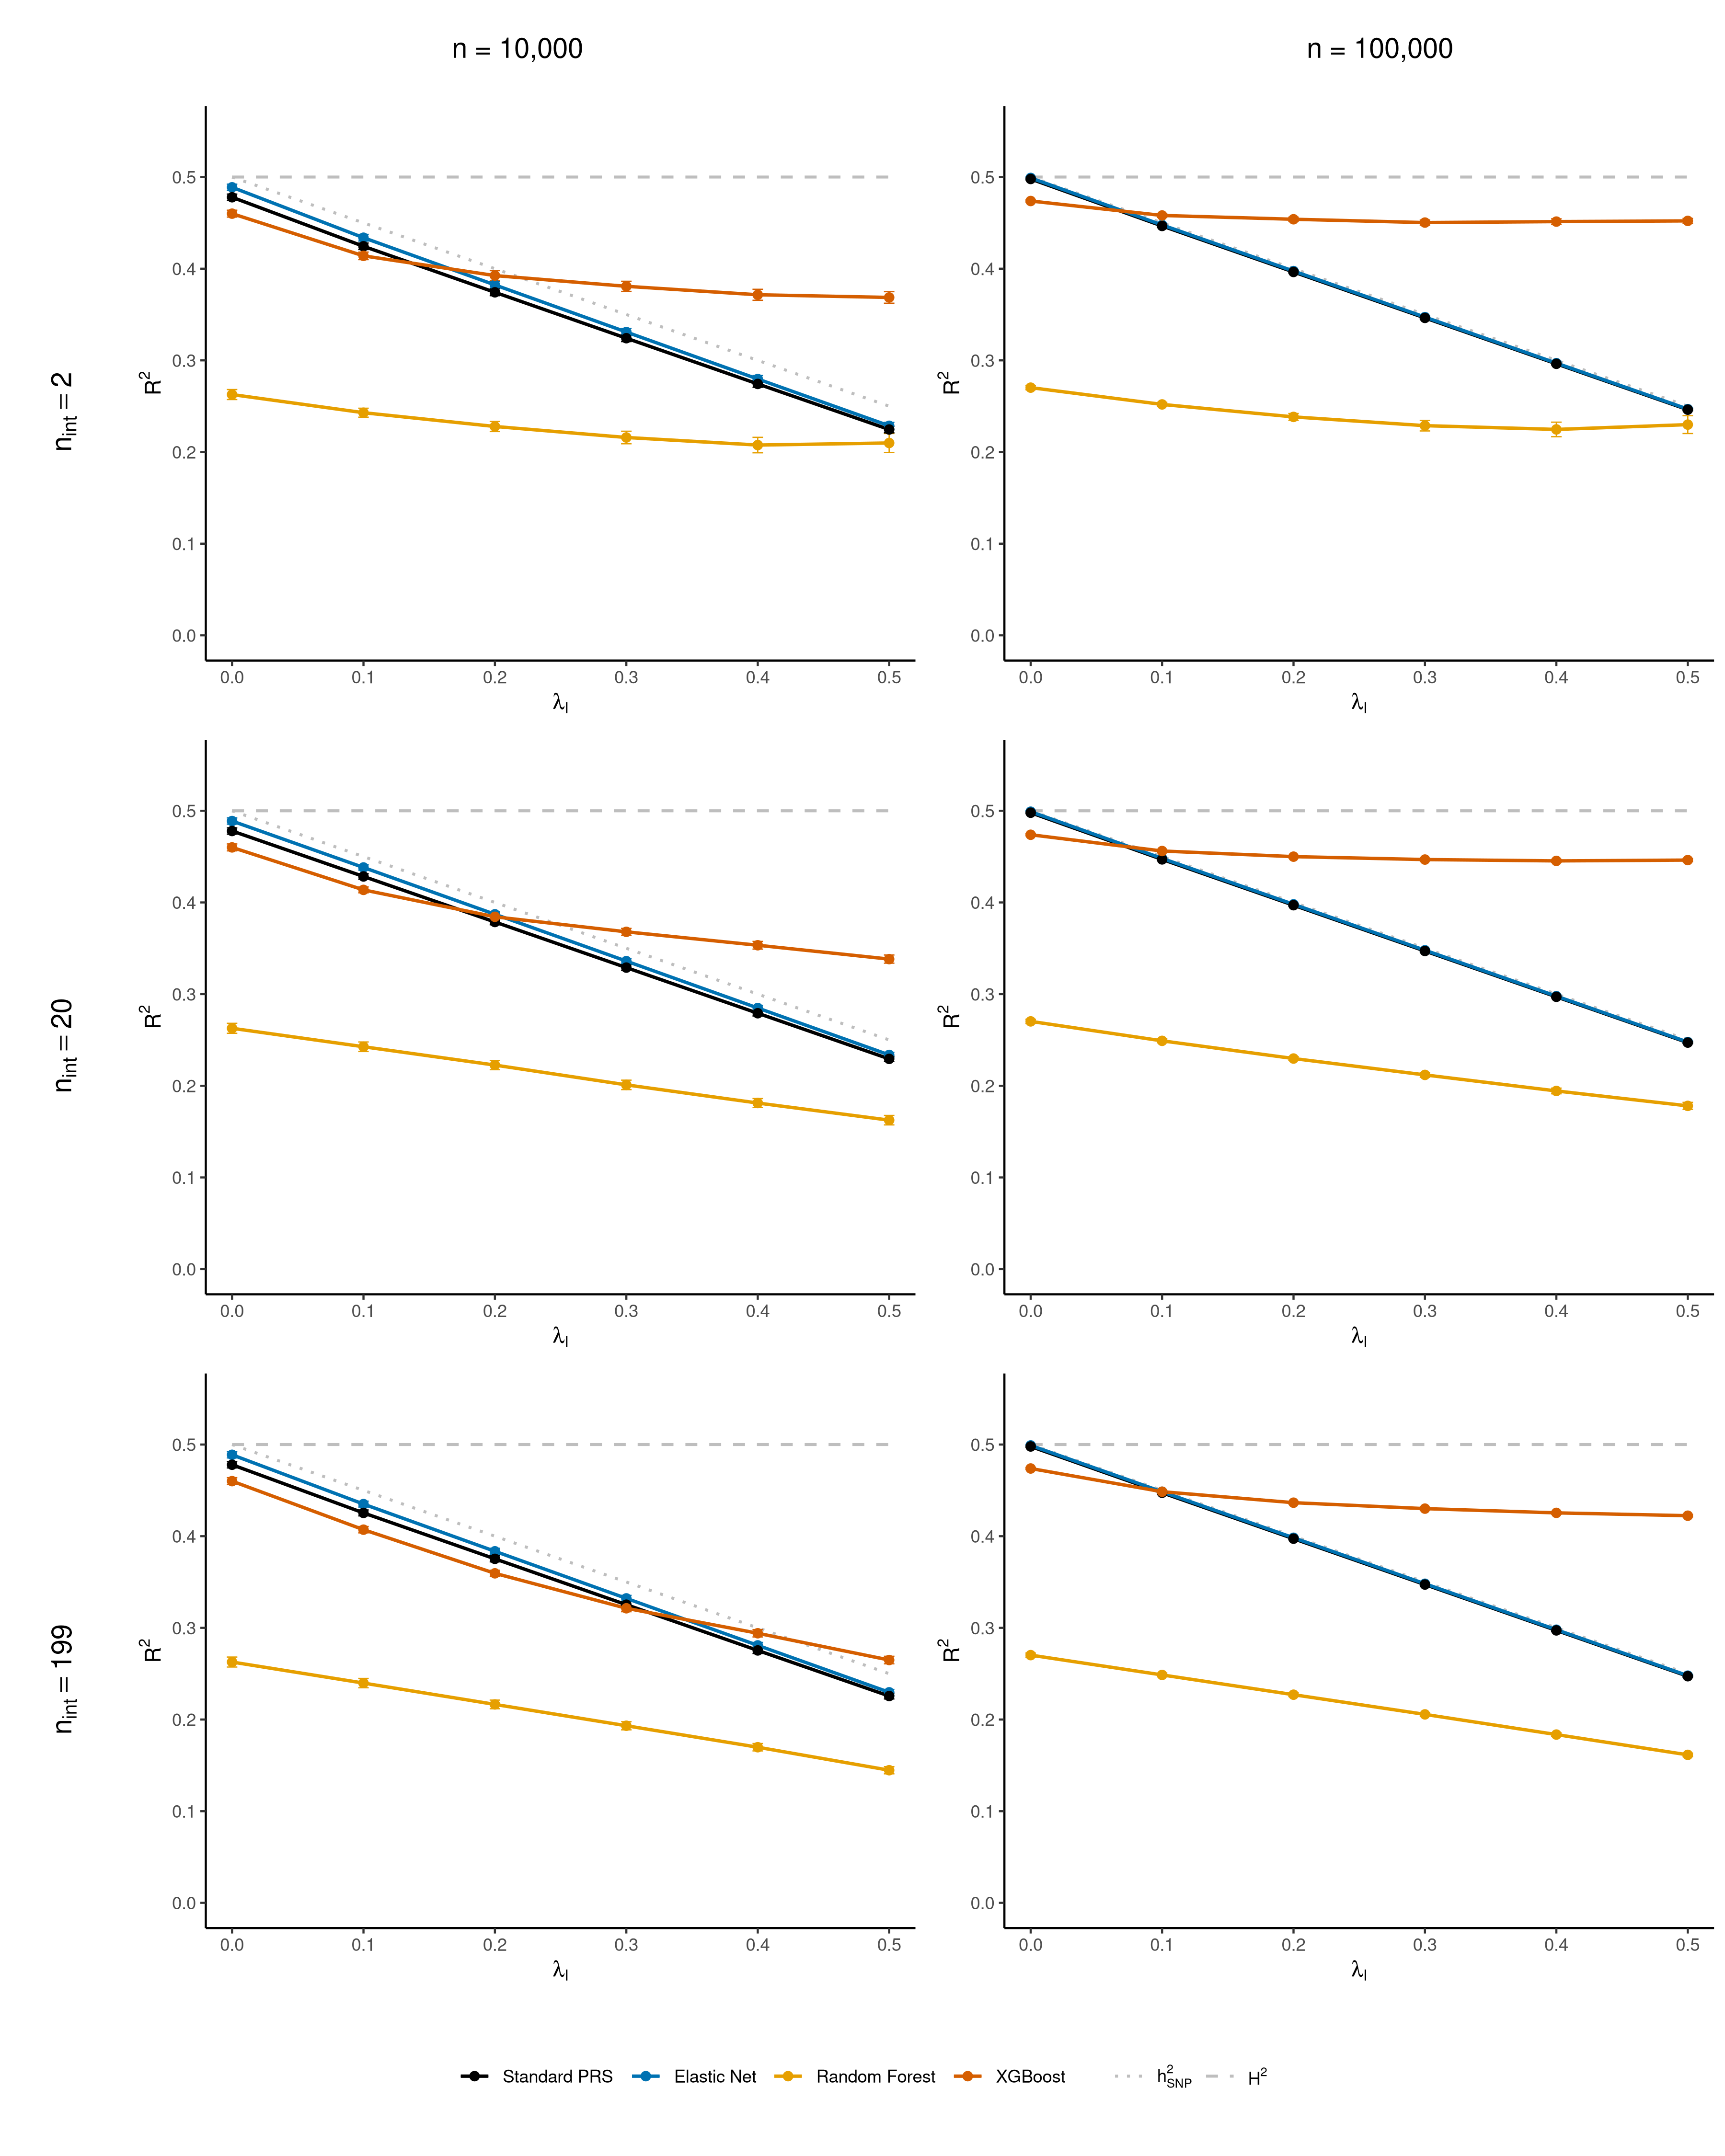
200 个独立常见 SNP 模拟:列为总样本量 10,000/100,000,行为交互对数 2/20/199,横轴为交互方差占比,纵轴为测试集 R²;训练集占总样本的 80%。
Zhu et al., medRxiv v1 (2026) · CC BY 4.0 · 原图未修改 · 原文图 · 放大两列分别是总样本量 10,000 和 100,000,三行是 2、20、199 对交互;横轴为交互遗传方差占比,纵轴为测试集 。橙线为 XGBoost,黑线为标准 PRS。灰色水平虚线是广义遗传力,下降点线是加性 SNP 遗传力。作者原图,未重绘;来源与许可见文末。
UKB:约 27 万训练样本下,提升仍依赖比较条件
真实分析包括 336,793 名无亲缘关系的 White British 参与者。训练集为 32,847 名病例与 236,587 名对照,测试集为 8,212 名病例与 59,147 名对照;病例按 Phecode 411 定义。作者仅用训练集进行 REGENIE GWAS,再以 、1 Mb 窗口进行 clumping,在 和 下分别保留 32 和 162 个 SNP,供所有模型共同使用。
Figure 4 衡量相对于年龄、性别及前 10 个遗传主成分基线的增量表现:C+T PRS、elastic net 和 XGBoost 的 Nagelkerke 、AUROC、AUPRC 与 Brier score 改善接近,区间大幅重叠;随机森林的增益较小。这支持“本研究条件下未见明显优势”,不能据此证明缺血性心脏病没有交互效应,也不能将区间重叠视为模型等效检验。
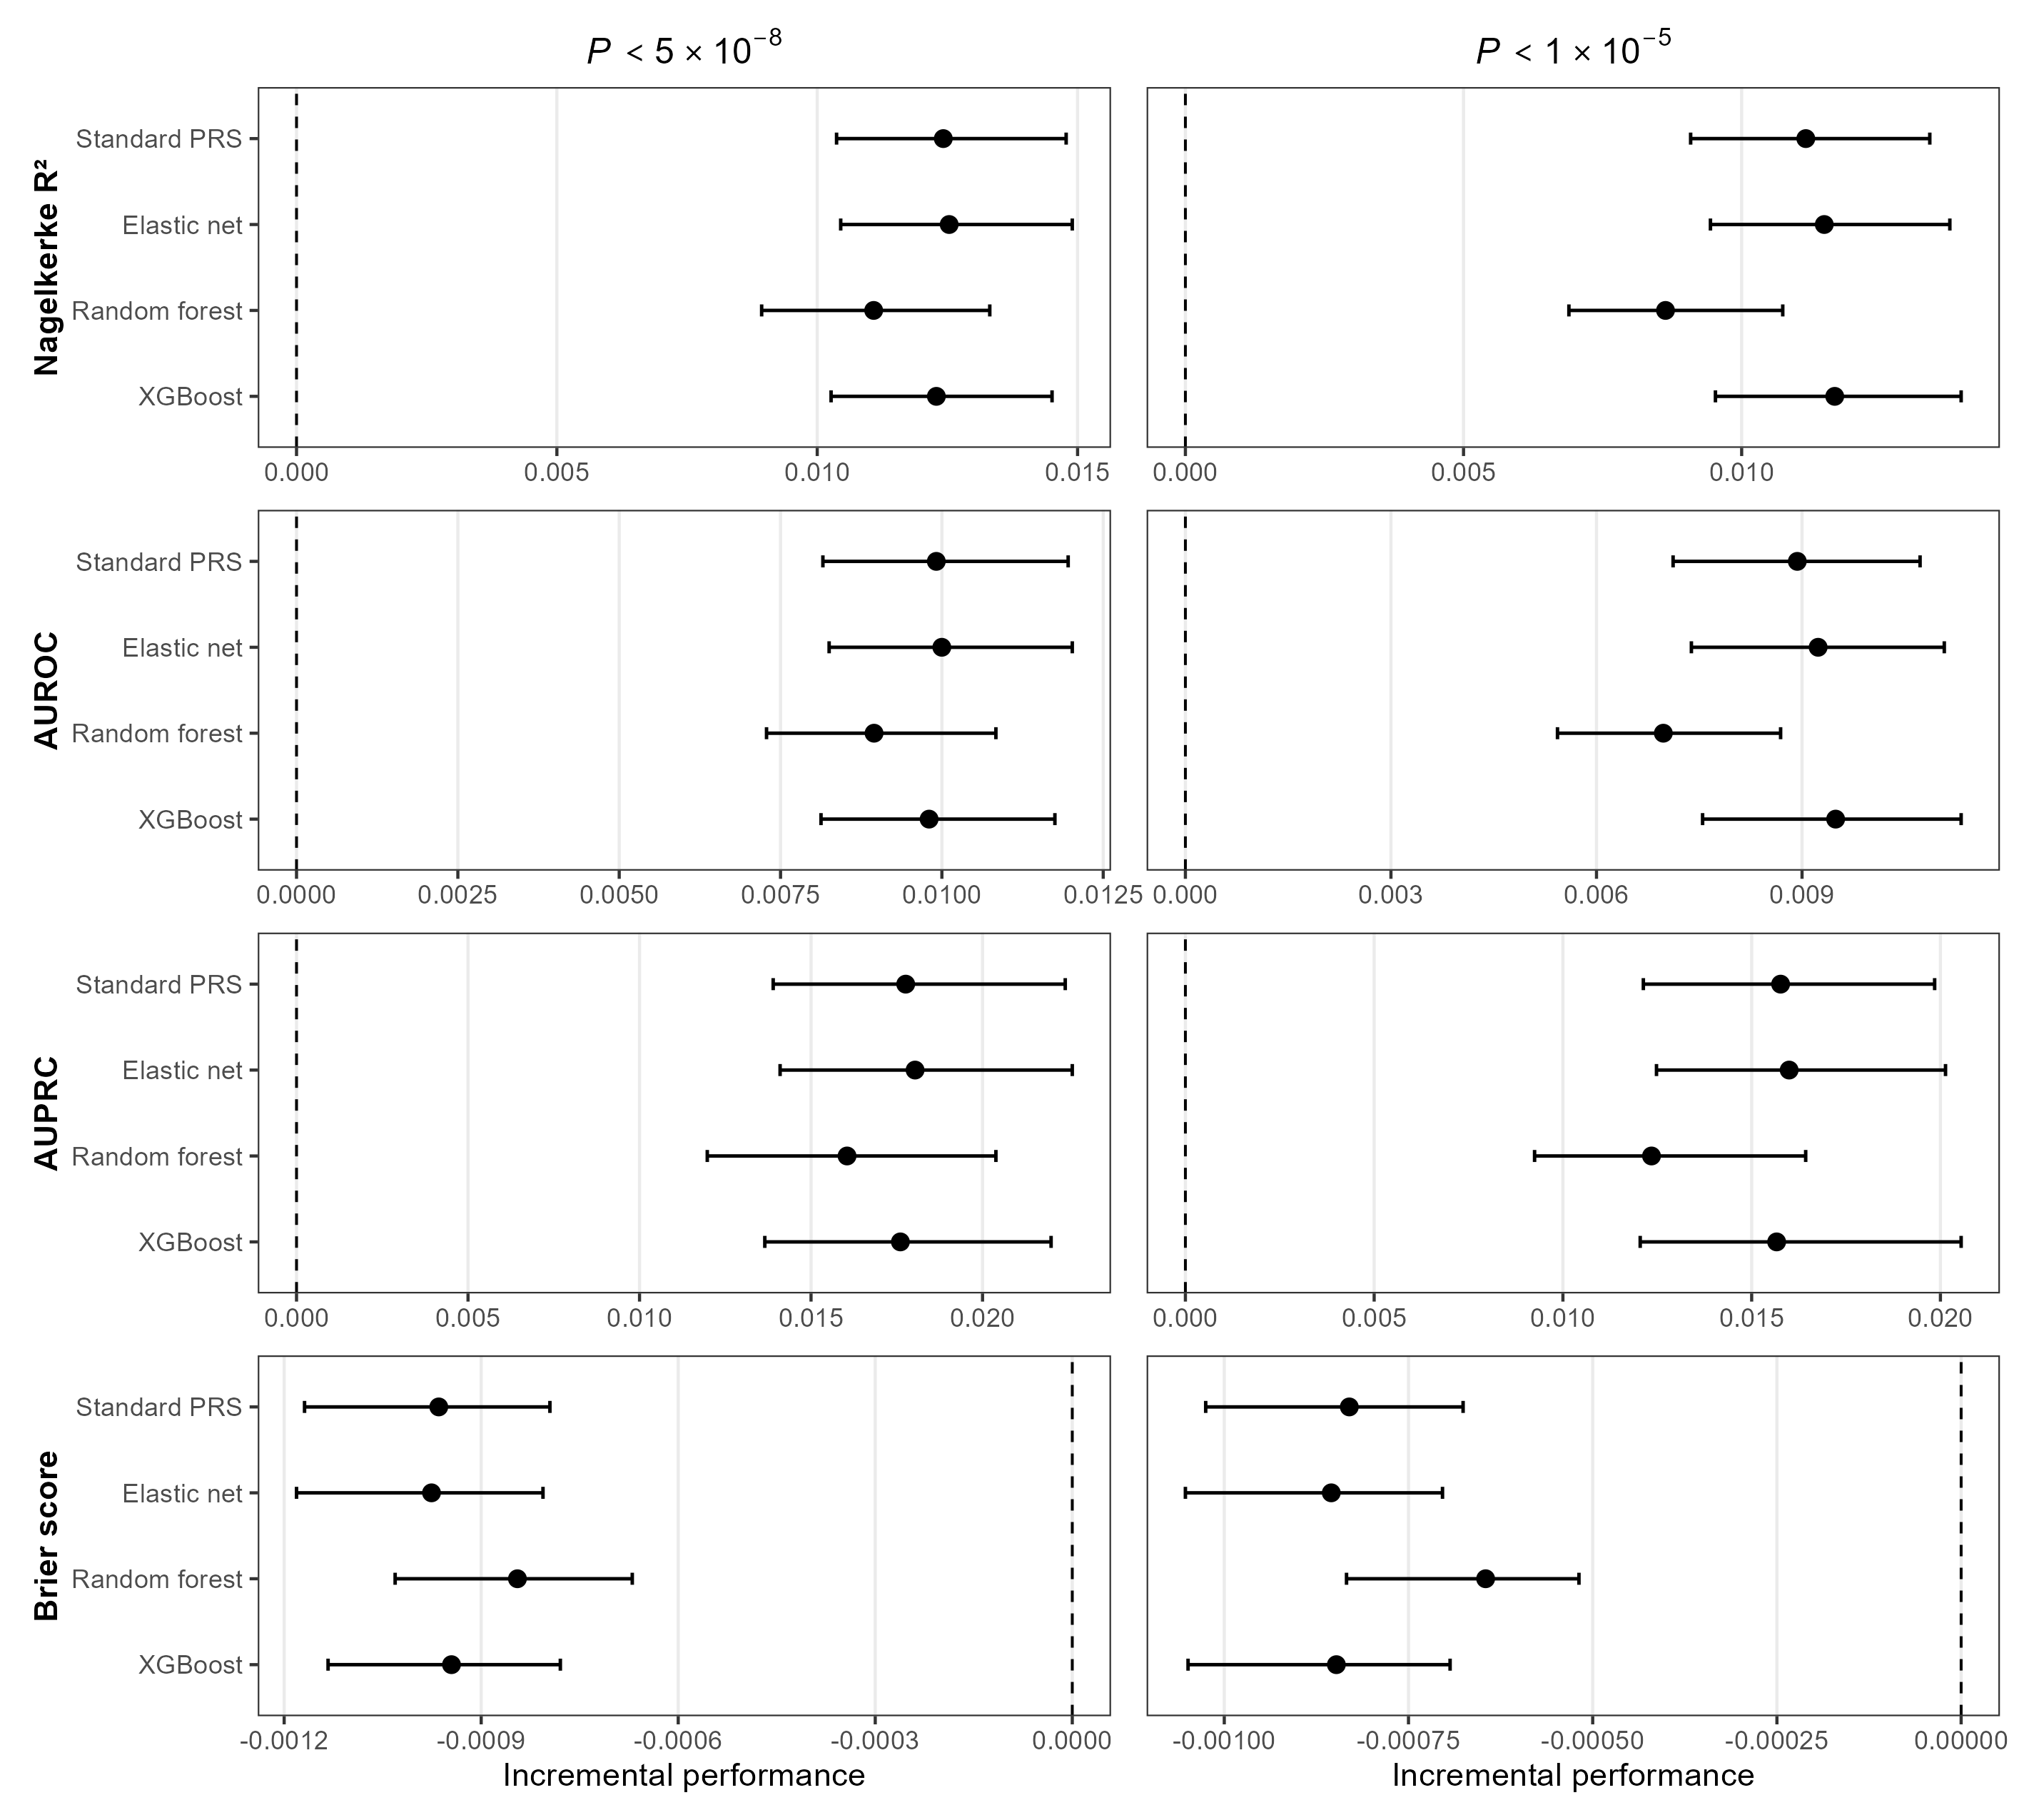
UKB 缺血性心脏病:四种 PRS 在两组 SNP 阈值下,相对年龄、性别和遗传主成分基线的增量表现;误差线为 bootstrap 95% 区间,负的 Brier 差值为改善。
Zhu et al., medRxiv v1 (2026) · CC BY 4.0 · 原图未修改 · 原文图 · 放大两列对应两种 SNP 纳入阈值;每行比较四种 PRS 的增量指标。前三项越大越好,Brier score 的差值越负表示概率预测误差下降越多。横线为 bootstrap 95% 区间。这里展示的是相对协变量基线的增量,而非 PRS 单独的绝对 AUROC。
SNP 选择与联合预测器的验证边界
模拟没有真实 LD 或全基因组级噪声变量,实证基线是小规模 C+T SNP 集合,未直接比较 LDpred2、PRS-CS 等方法。固定 SNP 集合有助于隔离建模差异,但可能漏掉边际效应弱、仅靠交互起作用的变异。另一个值得复现时改进的细节是:PRS 本身由独立训练集产生,但最终的 PRS 加协变量 logistic 模型在评估集上重新拟合并评估;这不等价于一个完全冻结的联合预测器在外部队列上的验证。作者 eval.R 可核查这一流程。
与已收录的 AB-PRS 对读很合适:本研究是在固定 SNP 集合上比较重新拟合模型,AB-PRS 则从既有 PRS 出发,筛选其尚未捕获的信号再作增量更新。两者共同关注剩余预测信息,但“与一个既有 PRS 正交”并不必然意味着非加性;尚未充分捕获的加性信号也可能贡献增益。这个区分对研究单细胞分子表型的预测模型尤其有用。
来源与图像署名
- 论文 v1 全文:理论见第 3–6 页;模拟见第 7–14 页;UKB 见第 10–11、15–17 页;局限见第 20 页。论文许可 CC BY 4.0。
- 官方版本元数据:核验 v1、2026-09-03 与作者信息。
- 作者代码与原始图表:固定提交 01f2f33421a754273fe8900cb2d916823830a622;仓库 MIT License,Copyright (c) 2026 JZhu919。两幅图已与 CC BY 4.0 论文对应图实查一致。
- 图像署名:Zhu J, Baousi A, Morris AP, Guo H (2026), medRxiv 10.64898/2026.08.29.26361109, Figures 2 and 4, CC BY 4.0;使用作者公开原始 PNG,未修改图内内容。