OmicsPred:多组学遗传预测模型数据库
OmicsPred as a centralized resource for genetic prediction of multi-omic traits
OmicsPred 集中收录转录组、蛋白组和代谢组的遗传预测权重,并为每个模型记录训练队列、组织、平台、祖源、变异数、建模方法和预测性能等元数据。
本文目录
资源解决的问题
遗传预测模型常以补充表、作者网站或不同格式的权重文件发布。即使都称为 transcriptome prediction model,不同模型也可能来自不同组织、祖源、基因注释、基因型参考版本和训练算法。缺少这些信息时,研究者很难判断某个权重能否在自己的 GWAS 或个体水平数据中使用。
OmicsPred 将 prediction weights 与结构化元数据共同存储,使模型可以按分子层、组织、平台、祖源和训练方法检索。
遗传预测模型是什么
对分子性状 ,常见模型写为
其中 是模型包含的变异集合, 是在参考队列中训练得到的权重。若只有 GWAS summary statistics,可结合 LD reference 计算 predicted trait–phenotype association;若有个体基因型,则可先计算 再做关联分析。
同一个基因在不同组织、祖源或方法下可能有多组权重。它们不是简单重复:Elastic Net、MASHR、Bayesian sparse models 和 protein/metabolite prediction models 对效应共享、稀疏性和 LD 的假设不同。
OmicsPred 保存哪些信息
Figure 1 的核心是 dataset–score 分离:
- dataset 描述某批模型的来源,包括 publication、sample、tissue、platform 和 molecular trait;
- score 保存具体变异权重、变异数、建模方法和性能指标;
- PheWAS 保存资源论文或用户分析得到的关联结果及 summary statistics。
这比只保存一个权重文件更重要。对可重复分析,至少需要知道 genome build、effect allele、variant identifier、训练样本量、ancestry、tissue、assay platform 和 cross-validation performance。
论文发布前的快照包含约 3,339,469 个模型,覆盖转录组、蛋白组和代谢组。大部分转录组模型来自 GTEx/PredictDB 等既有资源,平台也纳入独立 proteomic 和 metabolomic weights。资源支持 PGS Catalog Calculator 和 MetaXcan 等常用格式,以减少格式转换错误。
使用时应先做的检查
变异对齐
必须统一 genome build、reference/alternative allele 和 strand。A/T、C/G 模糊 SNP 在没有 allele frequency 辅助时容易翻转。模型变异在目标 GWAS 中缺失时,不能默认用 0 补齐;需要按资源说明进行 proxy、LD-aware 处理或放弃该模型。
训练祖源与 LD reference
同一组 在不同祖源中的预测 可能明显下降。原因包括 allele frequency、LD 和 eQTL effect heterogeneity。summary-statistic TWAS 还同时依赖权重和 LD reference;权重来自欧洲祖源而 LD 来自另一祖源时,方差归一化可能错误。
组织与 assay
“blood”不能代表所有免疫细胞状态,“brain”也不能代表所有脑区。蛋白模型还会受到 assay platform、epitope-binding artifact 和 cis/trans pQTL 区别影响。资源中的元数据是筛选起点,不能替代对原始训练论文的阅读。
预测性能
训练集内或交叉验证 不等同于外部队列性能。不同 study 的性能指标定义和表型转换可能不同,不宜直接按单一数值排序全部模型。
PheWAS 展示了什么
论文在 Million Veteran Program 中进行 multi-omic、multi-ancestry PheWAS,说明相同疾病表型可以同时关联到 genetically predicted RNA、protein 和 metabolite traits。这种跨组学一致性有助于靶点优先级排序,也能发现只有某一分子层显示的信号。
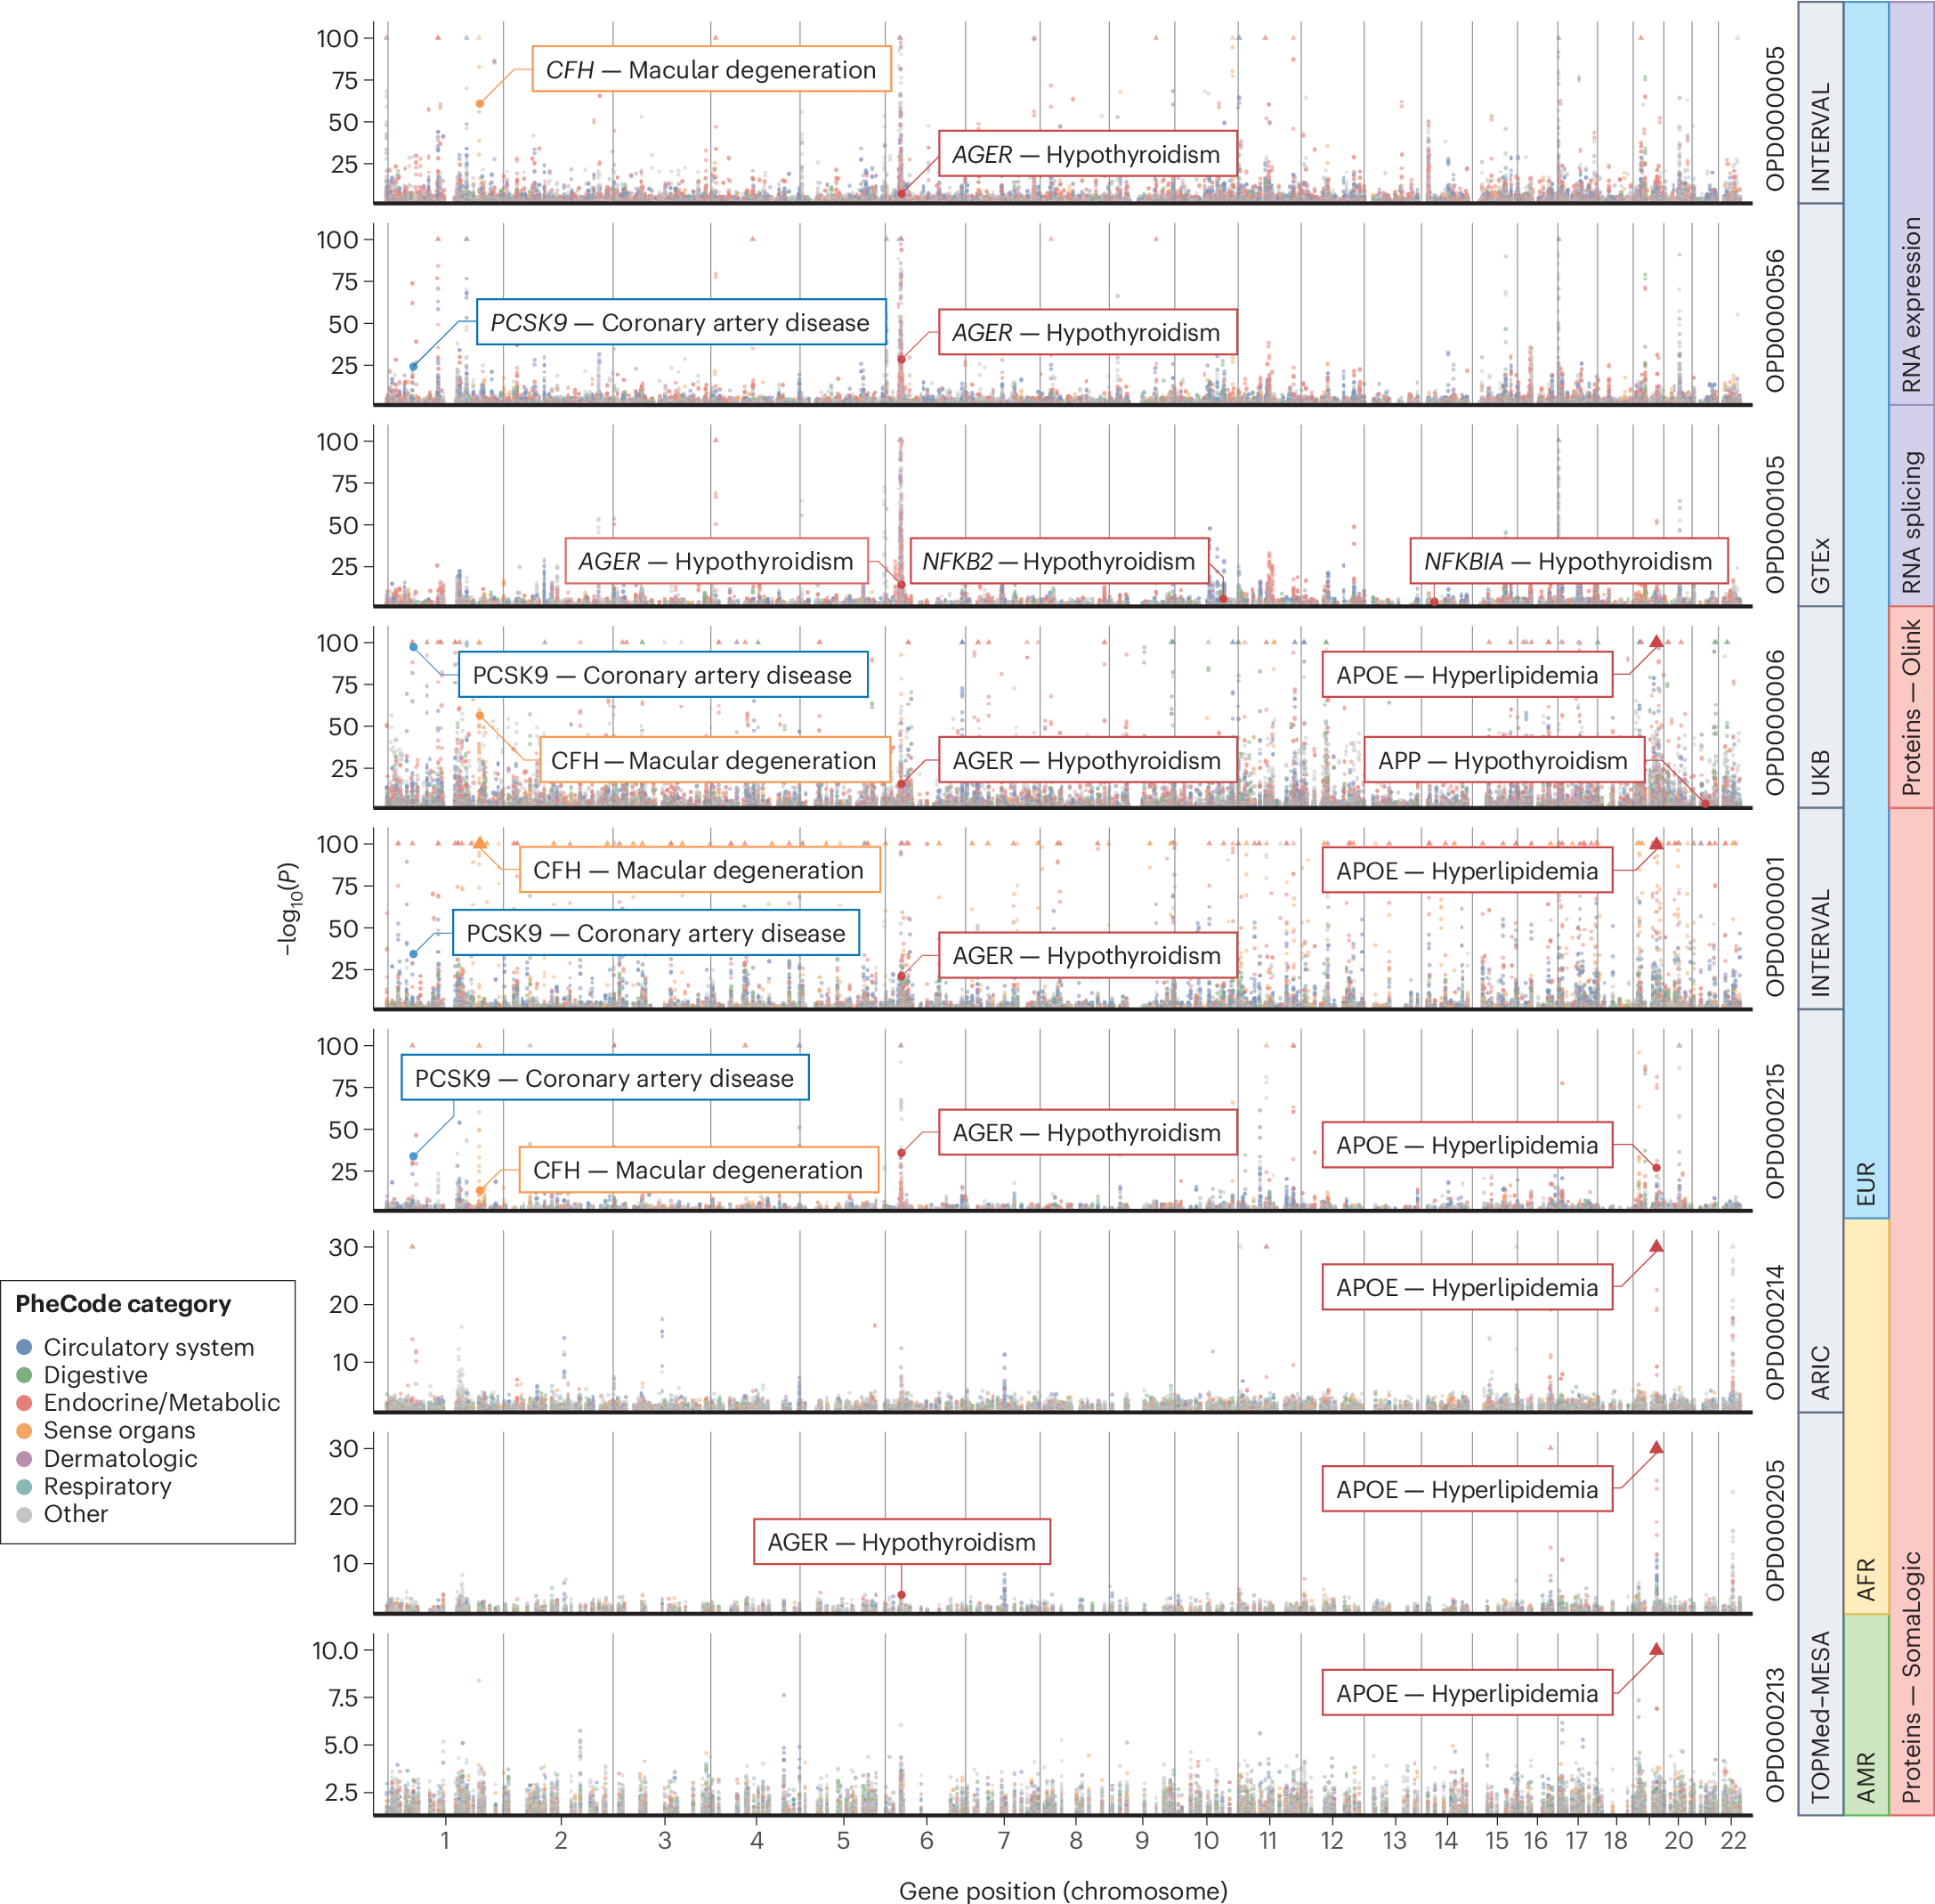
该图展示遗传预测的 RNA、蛋白和代谢物与临床表型之间的关联。阅读时应区分跨组学一致性、祖源间可重复性与单个模型的预测性能。
Foguet et al., Nature Genetics (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大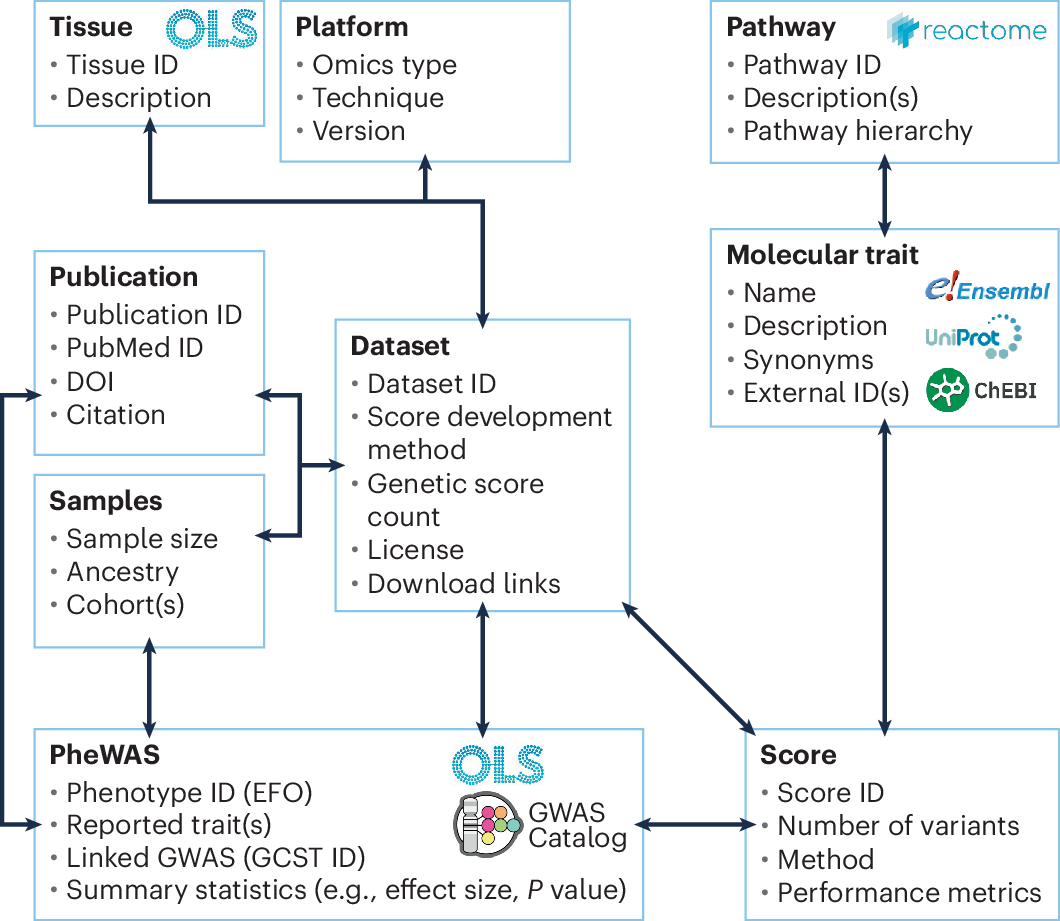
中心是 prediction-model dataset;周围连接训练队列、组织、平台、祖源、分子性状、变异权重、性能指标和下游 PheWAS。使用权重前应先核对这些元数据。
Foguet et al., Nature Genetics (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大但 association 仍不能自动解释为因果中介。预测模型中的变异可能通过水平多效性影响疾病;同一 locus 的多个基因和分子性状也可能因 LD 共同显著。后续仍需 colocalization、fine-mapping、条件分析和独立功能证据。
与 TWAS / PWAS 工作流的关系
一个较稳妥的使用顺序是:
- 按组织、祖源、平台和外部性能筛选候选模型;
- 统一 genome build 和 allele;
- 使用与 GWAS 匹配的 LD reference;
- 对显著 association 做位点内条件分析;
- 比较 GWAS 与 molecular QTL credible sets;
- 检查同一 locus 的其他基因和其他组学模型。
OmicsPred 能标准化前两步并帮助检索,但不会自动解决 LD confounding 或 causal gene identification。
数据库论文的价值与边界
资源的主要贡献是可发现性、标准元数据和下载兼容性。模型数量本身不是质量指标:若大量权重来自相同训练队列和高度相关组织,它们的有效独立信息远少于条目数。
未来版本最值得关注的更新包括:非欧洲祖源训练模型、单细胞或细胞状态 QTL weights、明确的 external validation、统一的 model calibration,以及与 fine-mapped QTL credible sets 的直接链接。
局限
- 不同来源模型的质量控制和性能指标仍存在异质性;
- 大量模型来自相同数据和相近组织,条目高度相关;
- 权重可下载不代表可跨祖源迁移;
- prediction association 对 LD reference 和 allele harmonization 敏感;
- 资源不能单独判断 predicted molecular trait 是否因果介导疾病;
- 数据库持续更新,分析必须记录 dataset 和 score 版本。
小结
OmicsPred 最适合作为模型检索和可重复性基础设施。真正使用某组权重之前,仍需回到训练队列、祖源、组织、平台和预测性能;真正解释显著 TWAS/PWAS 结果之前,仍需回到 LD、多信号 fine-mapping 和共定位。