sc-pcQTL:以局部多基因表达 PC 寻找遗传关联
sc-pcQTL: hurdle-based co-expression modeling for multi-gene QTL mapping in single-cell RNA-seq data
先用 hurdle 模型筛选邻近基因共表达,再以表达 PC 进行单细胞 QTL 和共定位分析。新增的 46 个 pcQTL-specific 信号组有生物学线索,但组件校准不能替代整个筛选流程的多重性验证。
本文目录
全文解读|bioRxiv v1,2026-08-23 公开,尚未经同行评议。 本文依据 12 页主文、Methods 与 Figures 1–4;附件没有独立补充方法、Figures S1–S15 和 Tables S1–S6。SMR/HEIDI 阈值、PIP 加权公式及部分敏感性分析细节未能独立核验,也未审计代码实现。论文与 PDF · 方法代码 · 分析代码 · 汇总结果
研究问题:遗传变异是否改变一组邻近基因的表达组合?
逐基因 cis-eQTL 分别检验每个基因的表达变化,但一个局部调控变异可能同时影响多个邻近基因。sc-pcQTL 先从单细胞表达中找出局部共表达基因簇,再用主成分概括这些基因的联合变化,最后检验基因型与主成分的关联。潜在收益是把分散在多个基因中的遗传信号转化为更容易检测的表达表型。
这里要分清两个阶段:hurdle 模型检验基因与基因的共表达,后续 SAIGE-QTL 检验基因型与表达 PC 的关联。本文也没有直接检验“基因型是否改变两个基因之间的相关系数”,因此不应把 pcQTL 与 genotype-dependent co-expression QTL 混为一谈。
模型与算法:先筛选共表达,再构建多基因表型
设一个细胞中响应基因为 、预测基因为 ,, 为协变量, 为对数文库大小。论文将两部分写为
正计数组件检验 ,检测组件检验 :前者考察已经检测到表达的细胞中的丰度关联,后者考察另一基因表达与“是否检测到该基因”的关联。零计数包含生物与测量因素,不能直接解释为基因关闭。两者均做双侧检验;作者对 SCTransform 校正后的 OneK1K counts 使用 Poisson 正计数组件,理由是其模拟校准优于所比较的负二项模型。
真实分析调整年龄、性别、6 个基因型 PC、2 个 PEER 因子及文库大小。每个无序基因对均拟合 、,分别在每个组件中取较小方向性 值;任一组件低于 就进入建簇,其中 为各常染色体内无序基因对总数。这个“方向取最小值,再对组件取并集”的规则属于筛选规则,其多重性问题见下节。
基因按染色体起点排序,以 50 个相邻基因为最大窗口,每次减少一个基因直到两个;同一窗口大小下逐基因滑动。一个窗口内至少 70% 的基因对通过筛选,就保留为簇并占用其中基因,后续与之重叠的窗口跳过。这是优先接受大窗口的贪心算法,不要求簇内所有基因两两显著,也不等价于按固定碱基距离或调控域分组。
每种细胞类型分别对簇内中心化但不缩放的 SCTransform-corrected counts 做 PCA,保留累计解释至少 95% 方差所需的最少前导 PC。由此得到的是每个细胞的 cluster-PC 分数;高方差基因可能主导载荷,PC 也未必是所有基因同方向升降。PC 整体正负号任意,只能解释载荷的相对方向和大小。
PC 分数经秩逆正态变换后,进入 SAIGE-QTL 的定量性状模式进行细胞层面混合模型关联;同一供者的基因型和供者协变量在其细胞间重复。检验范围是整个基因簇两侧各延伸 500 kb,仅保留 。细胞数增加了表达测量信息,不能把 124 万个细胞当作 124 万个独立遗传样本。
模拟究竟支持什么:组件校准与并集筛选需要分开读
主文的模型模拟每次包括 300 位供者、100 个基因,每种情形重复 50 次,分别注入检测、正计数及二者共同的潜在细胞效应。 时,正计数与检测组件的零假设拒绝率分别为 0.00962、0.00983;pseudobulk Pearson 为 0.0914,Spearman 为 0.0169。强检测效应下,检测组件功效为 0.931,两个 pseudobulk 对照为 0.108 和 0.0229。
真实数据置换保留各基因边际计数分布,但跨所有细胞独立打乱每个基因。 时,正计数、检测、组件并集的拒绝率分别为 0.0130、0.00915、0.0220。因此,单组件大致校准,不能推导未经调整的 本身也是校准后的 值;并集功效更高也伴随更高错误率。真实筛选还额外取了两个方向的最小值,主文所写 没有单独计入方向与组件的多重性,不能据此声称完整筛选的家族错误率已被证明控制在 0.05。
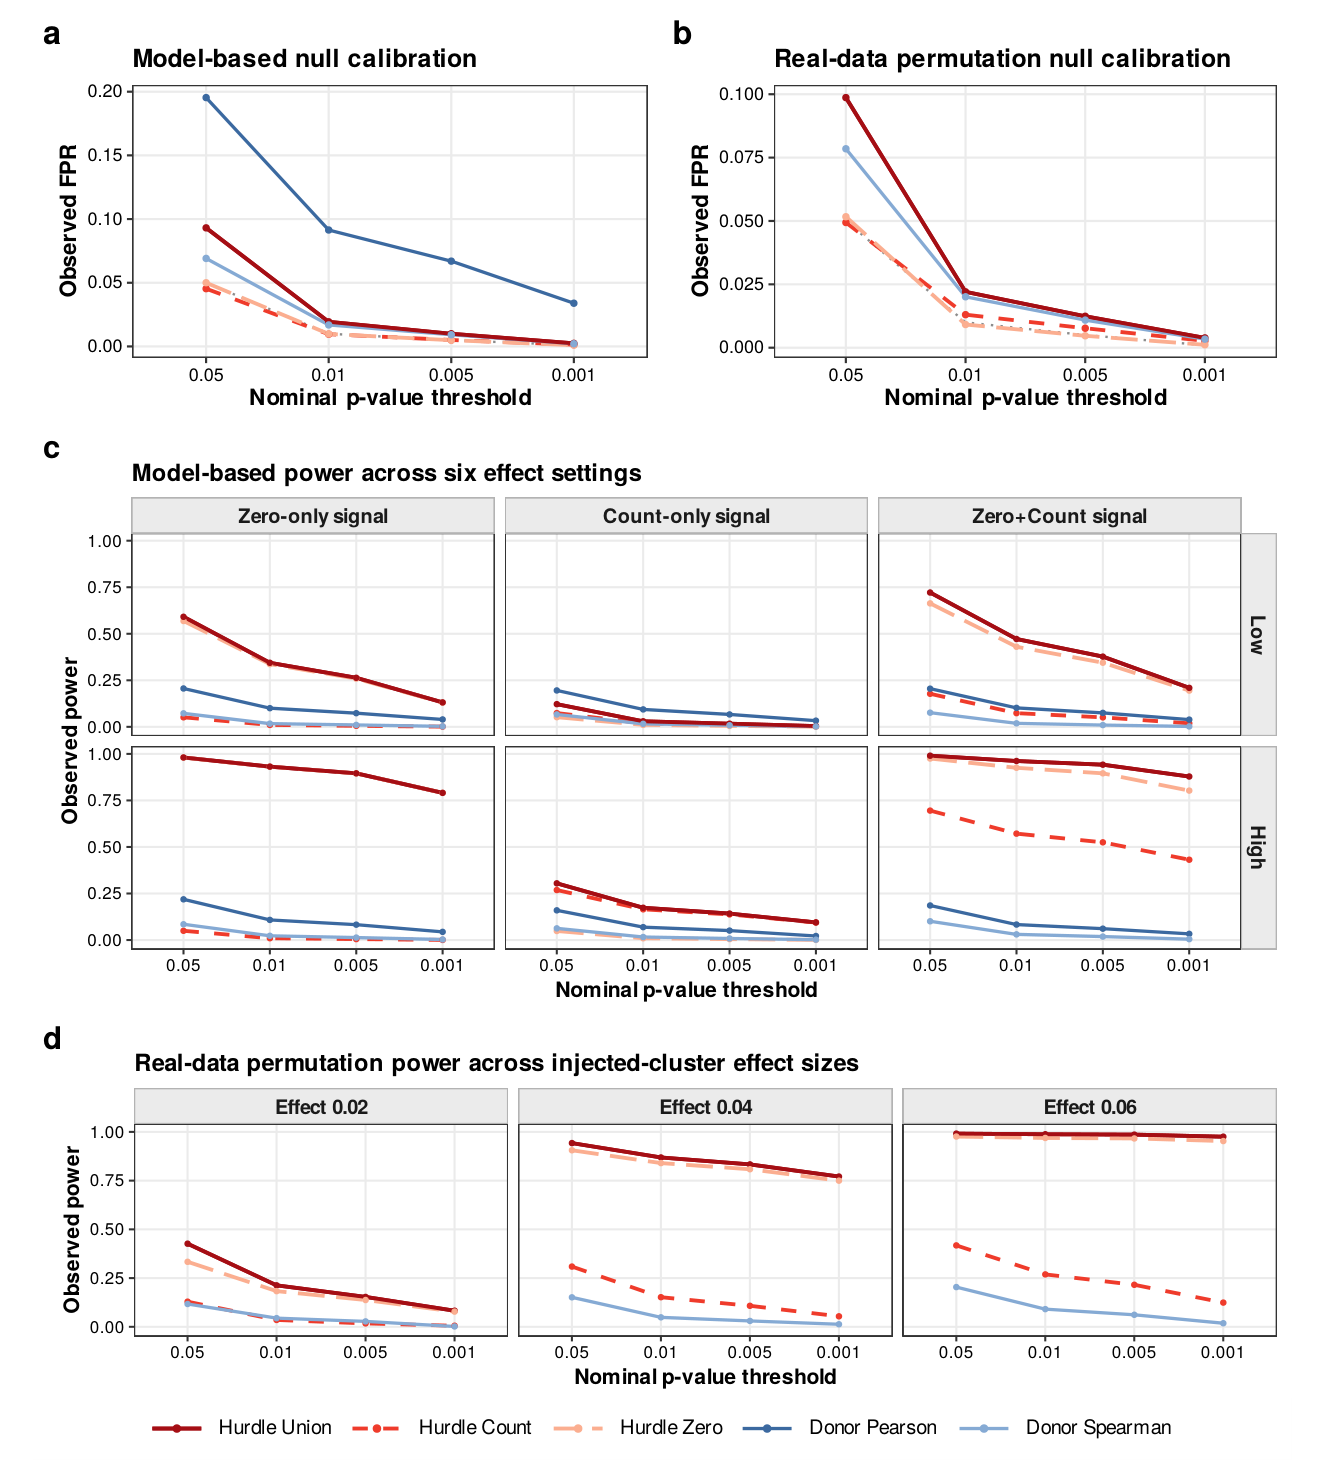
a、b 比较零假设拒绝率,c、d 比较功效。深红色 union 的拒绝率并非始终维持名义水平,不能只凭并集功效更高就称合并检验校准。完整保留 a–d 及图例。
Zhang et al., bioRxiv v1 (2026-08-23), Figure 2 · CC BY 4.0 · 原图未修改 · 原文图 · 放大同样,筛选模型把细胞当作观测,没有显式拟合同供者细胞相关性。作者报告补充模拟中引入供者内依赖未持续增加拒绝率,但把结论限定在所模拟依赖结构。跨细胞置换会破坏原有供者内结构与协变量对齐,不能充分验证真实相关结构下的校准。这里的对照又是供者平均表达的相关检验,功效结论不等于已经对所有 donor-aware 共表达方法建立优势。
OneK1K 结果:计数单位和阈值不能省略
研究纳入 982 位 OneK1K 供者、1,241,711 个 PBMC。14 种注释细胞中保留总细胞数至少 10,000 的 10 种;各类型内删除检测率低于 1% 的基因。覆盖初始/记忆 B 细胞、多个 CD4/CD8 T 细胞亚群、经典/非经典单核细胞及 NK 细胞。
| 结果 | 正确的计数与含义 |
|---|---|
| 2,485 个局部基因簇 | 跨细胞类型合计,含 5,313 次基因归属;不是 5,313 个独立基因 |
| 2,311 个双基因簇 | 占约 93%,大部分发现是邻近基因对,而非大型网络 |
| 4,353 个 PC 表型 | 成功完成 QTL 检验的 cluster-PC,不是基因簇数 |
| 2,040 个显著 PC 表型,46.9% | 每个 PC 内对 cis-SNP 做 BH,至少一个 ;不是全体 PC 层面的 FDR 结论 |
| 394 个共定位信号组 | 126 个 eQTL-only、222 个 shared、46 个 pcQTL-specific |
作者另做 ACAT 汇总各 PC 的 cis-SNP 值、再跨 PC 做 BH 的敏感性分析,但主文没有给出该分析的具体发现数,不能用它替代上表的 2,040。
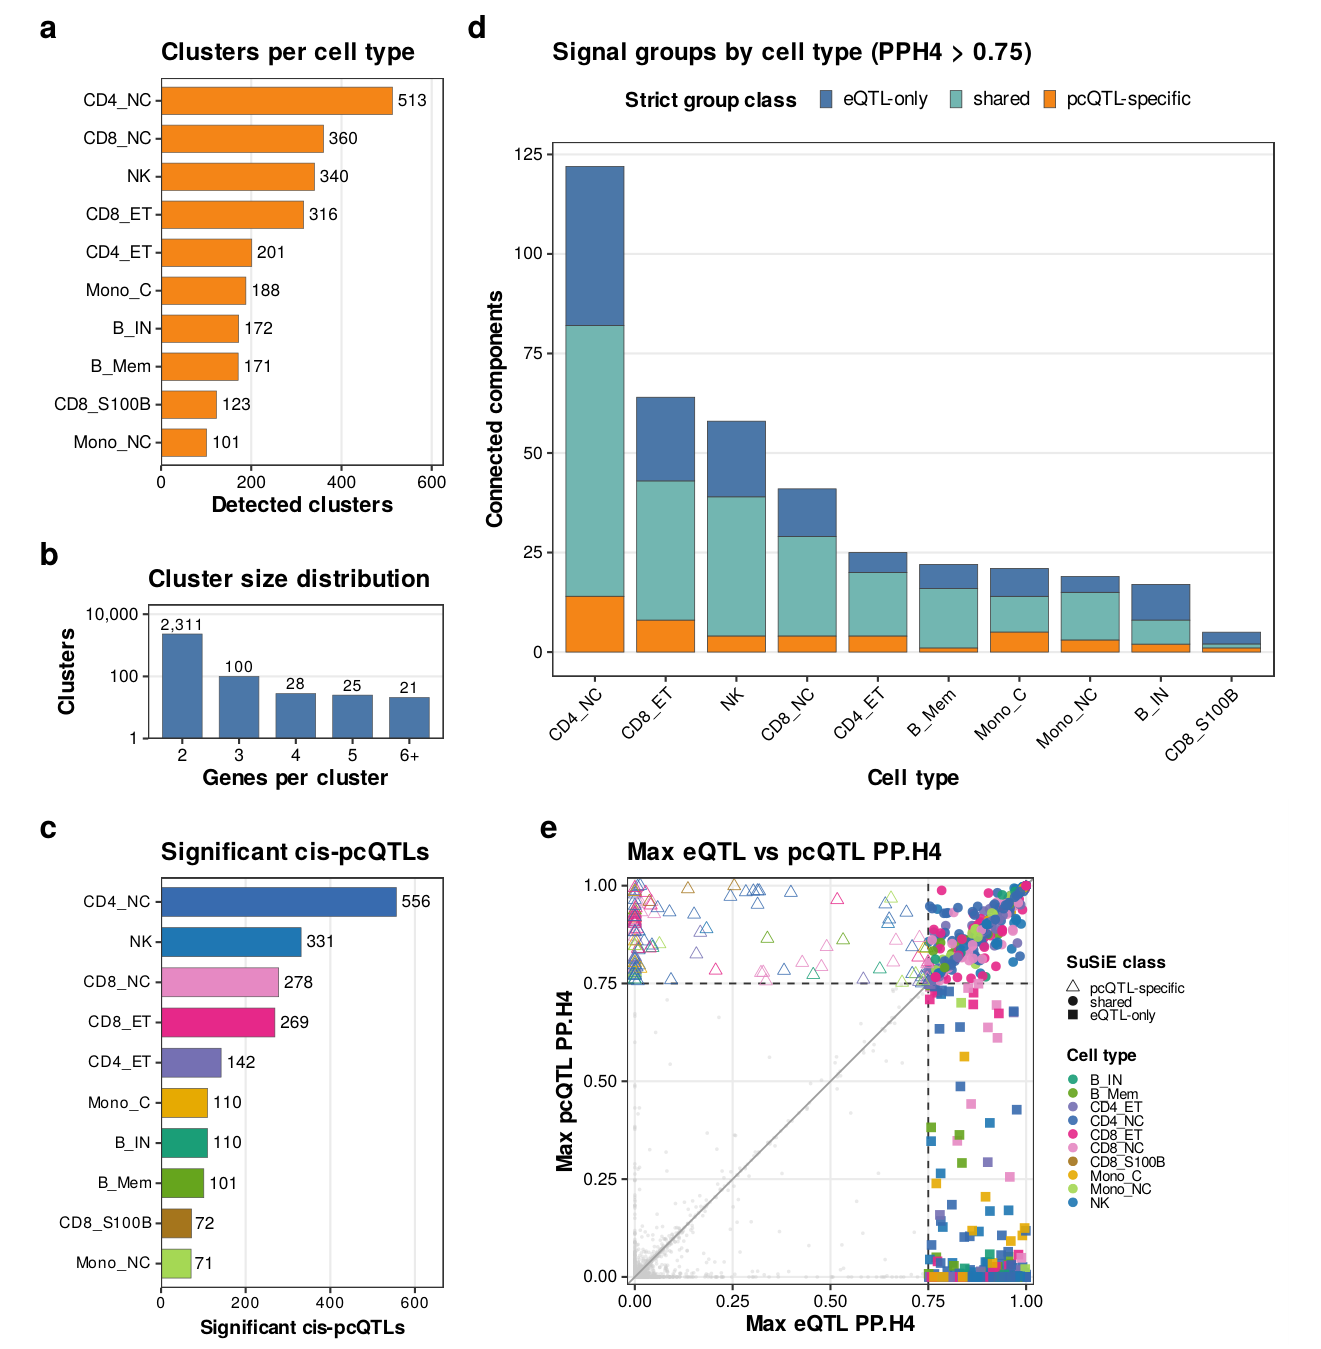
b 显示大多数簇仅有两个基因;c 统计显著 PC 表型,d 统计共定位连通组,e 为 cluster–trait 最大共定位概率。各面板的计数单位与阈值不同。
Zhang et al., bioRxiv v1 (2026-08-23), Figure 3 · CC BY 4.0 · 原图未修改 · 原文图 · 放大Fine-mapping 与共定位:新增的是信号组
每个 PC 及同簇单基因 eQTL 都在相同簇窗口内进行 SuSiE-RSS,无须先达到 QTL 显著阈值。输入为方向对齐的 与 OneK1K 供者基因型 LD,使用 、、默认变异先验、不估计残差方差。保留 95% credible set,且集内最小绝对 LD 相关至少为 0.5;缺少合格 credible set 的表型不进入后续共定位。
作者将 QTL 从 hg19 转到 hg38,与 FinnGen R12 的 1,163 个表型 fine-mapping 结果对齐,在共有变异上运行 coloc.susie。同一细胞类型和局部簇内,QTL–GWAS 或 eQTL–pcQTL 比较只要 就连边;通过一条或多条边连接的信号组成一组,仅保留包含 GWAS 信号的组。
因此,pcQTL-specific 要求该组有 pcQTL,却没有同簇单基因 eQTL 经这些连接进入该组。46 个此类组相对于包含 eQTL 的 组增加 13.2%。它们不是 46 个新基因、独立 SNP 或互不重叠的疾病位点;跨细胞类型与簇的同一 GWAS 命中另按“GWAS 表型+lead variant”去重。此外,连通分组不要求组内每对信号都直接通过共定位阈值。
真实位点:GIMAP 的 PC3 为何比单基因结果更有信息?
CD8 初始及中央记忆 T 细胞中的 GIMAP 簇含 GIMAP8、GIMAP7、GIMAP4、GIMAP6、GIMAP2、GIMAP1、GIMAP5 七个邻近基因。21 个基因对中 16 对通过共表达筛选。PC3 的 lead variant 为 rs12540285,;它与 FinnGen 淋巴细胞计数的共定位为 、。
同簇没有单基因 eQTL 超过主共定位阈值,但这并不意味着每个基因都没有 eQTL:例如 GIMAP2 的局部关联 。它与淋巴细胞计数信号是否共享因果变异是另一项问题。GIMAP8、GIMAP7、GIMAP1 未得到合格 credible set,图中的“no credible set”表示未做共定位,不能写成已经证明不存在共定位。
PC3 载荷明显受 GIMAP1 主导,PIP 加权的单基因名义效应却分布在多个基因,且方向不同。载荷描述表达矩阵的变化轴,PIP 加权效应描述候选变异对各基因的关联,二者都不是“各基因对淋巴细胞计数的因果贡献比例”。主文还报告 GIMAP7 具有最强的 HEIDI 一致性 SMR 关联,这属于基因优先排序线索,不能据此确认表达介导疾病效应或排除水平多效性。
完整七基因簇也出现在 CD8 ET、CD4 NC 和 NK,但只有 CD8 NC 的 cluster-PC 共定位超过 0.75;次高为 CD4 ET 的 0.66。因此共表达模块重复出现,不代表遗传效应和共定位证据必然跨细胞类型重复。该簇的 21 个基因对均未触发作者采用的 cross-mappability 标记,有助排查相似序列错误比对造成的假共表达,但仍不构成功能实验验证。
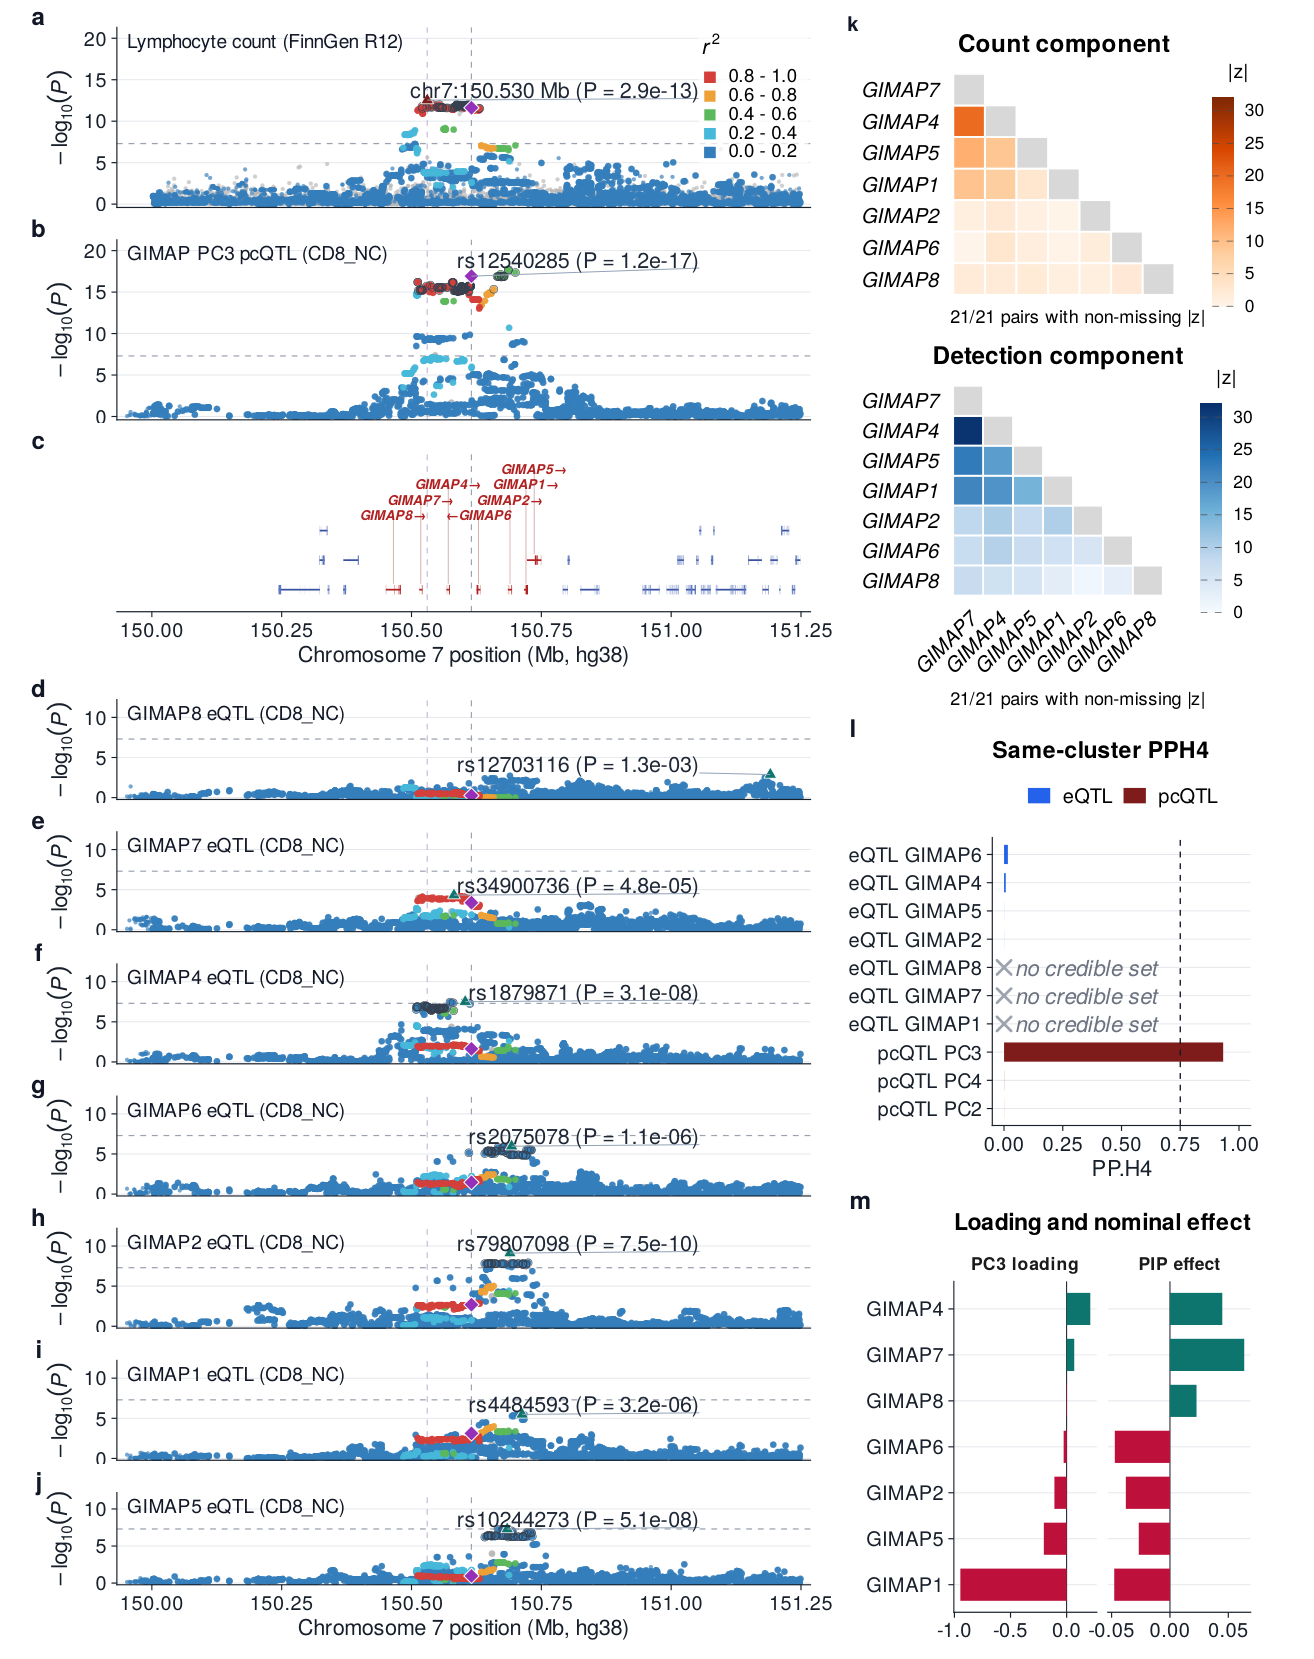
a、b 比较 GWAS 与 PC3,d–j 对照七个单基因;l 区分共定位概率与无可信集而未测试的条目,m 对照载荷和 PIP 加权名义效应。上下区域图纵轴尺度不同,不能仅凭峰高比较;原图注续于 PDF 第 8 页。
Zhang et al., bioRxiv v1 (2026-08-23), Figure 4 · CC BY 4.0 · 原图未修改 · 原文图 · 放大怎样使用这一方法,以及还缺什么证据
适合把它作为逐基因 eQTL 之外的表型构建层,尤其关注一个局部变异对邻近基因有分散、部分相反效应的情形。它不能替代单基因结果:394 组中仍有 126 组属于 eQTL-only。实际重分析应保留两套分析,并检查簇稳定性、PCA 的尺度选择、供者内相关性、完整筛选多重性,以及关联统计量与 donor LD 的兼容性。
目前证据主要来自欧洲祖源 OneK1K 免疫细胞,跨队列、祖源、组织的重复性尚待建立。按细胞数量比较发现数也容易把功效差异误认为生物差异。主文报告 pcQTL 注释的疾病遗传力富集,但 baseline-LD 调整后的独立系数没有达到显著,联合加入 eQTL 后进一步减小,故不能声称已证明独立于单基因 eQTL 的遗传力贡献。全文的额外共定位信号是值得跟进的观察,下一步仍需独立复制、染色质证据与定向扰动实验。