scAtlasPy:磁盘驻留、随机数据流与亿级单细胞分析
Atlas-scale single-cell analysis beyond in-memory paradigm with scAtlasPy
用 DuckDB 中的混合稀疏存储、顺序读取与有限缓冲随机化,把数据规模与全矩阵驻留内存的要求分开。论文报告在 64 GB 内存笔记本上完成约一亿细胞工作流,并验证读取吞吐和数值一致性。关键边界是 UMAP/Louvain 采用子集教师与全量预测,不能把 full-resolution 理解成对全部细胞执行完全相同的全图算法。
本文目录
瓶颈:不是能否打开文件,而是能否完成分析
scAtlasPy 针对的问题是:当单细胞矩阵超过可用内存时,数据能否在磁盘上持续完成质控、变换、特征选择、降维、聚类及结果查询,而不是仅仅以 backed 模式打开文件。作者提出一个磁盘驻留的平台,把持久化存储、数据读取和数值算法分开,并用标准化的稀疏或 dense minibatch 接口连接它们。v1 正文,PDF pp.1–4
这篇的核心不是 GPU kernel,而是如何通过数据布局、顺序 I/O、缓冲区和近似算法降低全矩阵驻留的要求。已有 Python 单细胞接口被保留为 pp、tl、pl、io 等命名空间,但底层对象由内存中的 AnnData 换成磁盘上的 Atlas 数据库。
混合稀疏存储:非零记录与行指针各司其职
每个 atlas 由一个 DuckDB 的 .sasql 文件管理。表达值采用结合 COO 与 CSR 思路的设计:一张表保存 cell ID、gene ID 和非零表达值,另一张表保存每个细胞在稀疏记录中的起止指针。前者便于按细胞或基因聚合、查询,后者使指定细胞块的重建不必扫描整个表达矩阵。
元数据和结果也持久化到关系表:obs 存细胞信息,var 存基因信息,obsm 存细胞嵌入,varm 存载荷,uns 存模型参数和统计量。过滤先生成标记,再为保留的细胞和基因建立连续的新索引及派生稀疏表示。其意义不仅是节省内存,也在于后续分析可复用已完成的变换和结果,而不必反复搬运巨大的 AnnData 对象。Methods,Hybrid Storage Layer;Extended Data Figure 1,PDF pp.6、18
低 RSS 不代表没有代价:原始输入、数据库、派生表示和临时工作空间仍需磁盘容量,导入也有独立的时间成本。论文并没有证明所有数据密度、查询模式和磁盘条件下都同样高效。
随机数据流:把大部分随机访问变成近顺序读取
读取层用多线程 producer–consumer 结构预取即将使用的记录;消费者按需重建稀疏细胞块,只在数值算法要求时转为 dense minibatch。数据库 I/O 与计算可以重叠,当前 batch、特征数和 shuffle buffer 决定主要工作内存,而不是一次分配全部细胞×基因矩阵。
随机化分两阶段。导入时,连续读入多个细胞块,在内存受限的窗口内打乱;一部分写出,另一部分保留并与下个窗口混合。迭代读取时,再用有限 shuffle buffer 混合数据流,提供多遍训练;也支持只遍历一次的 single-pass 模式。这是一种局部窗口加滚动缓冲的随机化,不是事先对全体细胞生成完全均匀的全局随机排列。Methods,Randomness of mini-batch retrieval,PDF pp.8–9
这种取舍适合将大量随机磁盘 seek 转成大块顺序或近顺序读取。对算法设计而言,后续应检查的是具体训练目标是否接受这种数据流混合方式,而不是仅根据接口名含 random 就默认得到独立同分布的 batch。
流式 PCA 与蒸馏式 UMAP、Louvain 不是同一种扩展策略
PCA 通过按批遍历、累积紧凑交叉乘积矩阵来估计子空间,再按批投影全部保留细胞并写回嵌入。它主要改变矩阵计算和存储方式,之后需要数值一致性检查。
UMAP 则首先在代表性细胞子集上拟合常规 UMAP 教师,再训练轻量神经网络学习该嵌入,最后对全量细胞按批预测。Louvain 同样先在代表性子集的低维空间上生成图聚类标签,再训练分类器把教师规则应用到全部细胞。另一个聚类选项是 minibatch K-means,不构建完整细胞–细胞图。Methods,Streaming PCA、UMAP、Clustering,PDF pp.10–12
因此,论文所说的 full-resolution 应理解为全量保留细胞得到表示和标签,而不是对一亿细胞执行与常规 UMAP/Louvain 完全相同的全图优化。教师子集中未覆盖的稀有状态、边界或新群体,是否能被学生保留,是这一策略特有的验证需求;本文没有提供完整的稀有群体漏检率或跨扰动泛化基准。
扩展性基准:10K 到 30M,与失败后的停止规则
系统性基准使用 Tahoe-100M 的 plates 1–5,以固定种子、按 plate 比例建立 10K、30K、100K、300K、1M、3M、10M、30M 八个嵌套子集。输入均保留 62,710 个基因特征,非零元素数从约 1,420 万增加到 428 亿。后续工作流仍会做过滤和 HVG 选择,不能将输入特征数理解成每一步均在全部基因上计算。
测试覆盖导入或访问、过滤、QC、归一化、log1p、HVG、scale、PCA 和聚类,在各平台支持范围内匹配。scAtlasPy 完成所有规模,峰值内存不超过 27.5 GB;30M 时导入约 2 小时、PCA 约 27 分钟、聚类约 7.3 分钟。各步骤的峰值不能相加成整流程峰值。Methods 与 Extended Data Tables 2–3,PDF pp.12–14、25–26
服务器有双 Intel Xeon Gold 6530、约 2 TiB RAM 和 7.68 TB NVMe SSD,但每个数据集运行被限制为 512 GB RSS 和 10 小时。发生内存超限、超时或运行错误后,该平台不再继续更大规模;图中的未运行不能当作已经实测失败。Scanpy backed 模式因无法完成所选完整流程而未进入整流程比较,但另做了操作支持和读取实验。本文并未对所有 BPCells、GPU 或分布式工作流给出同配置端到端比较,因此摘要的“其他平台只能到 3M”必须限定于所测平台、配置和任务。
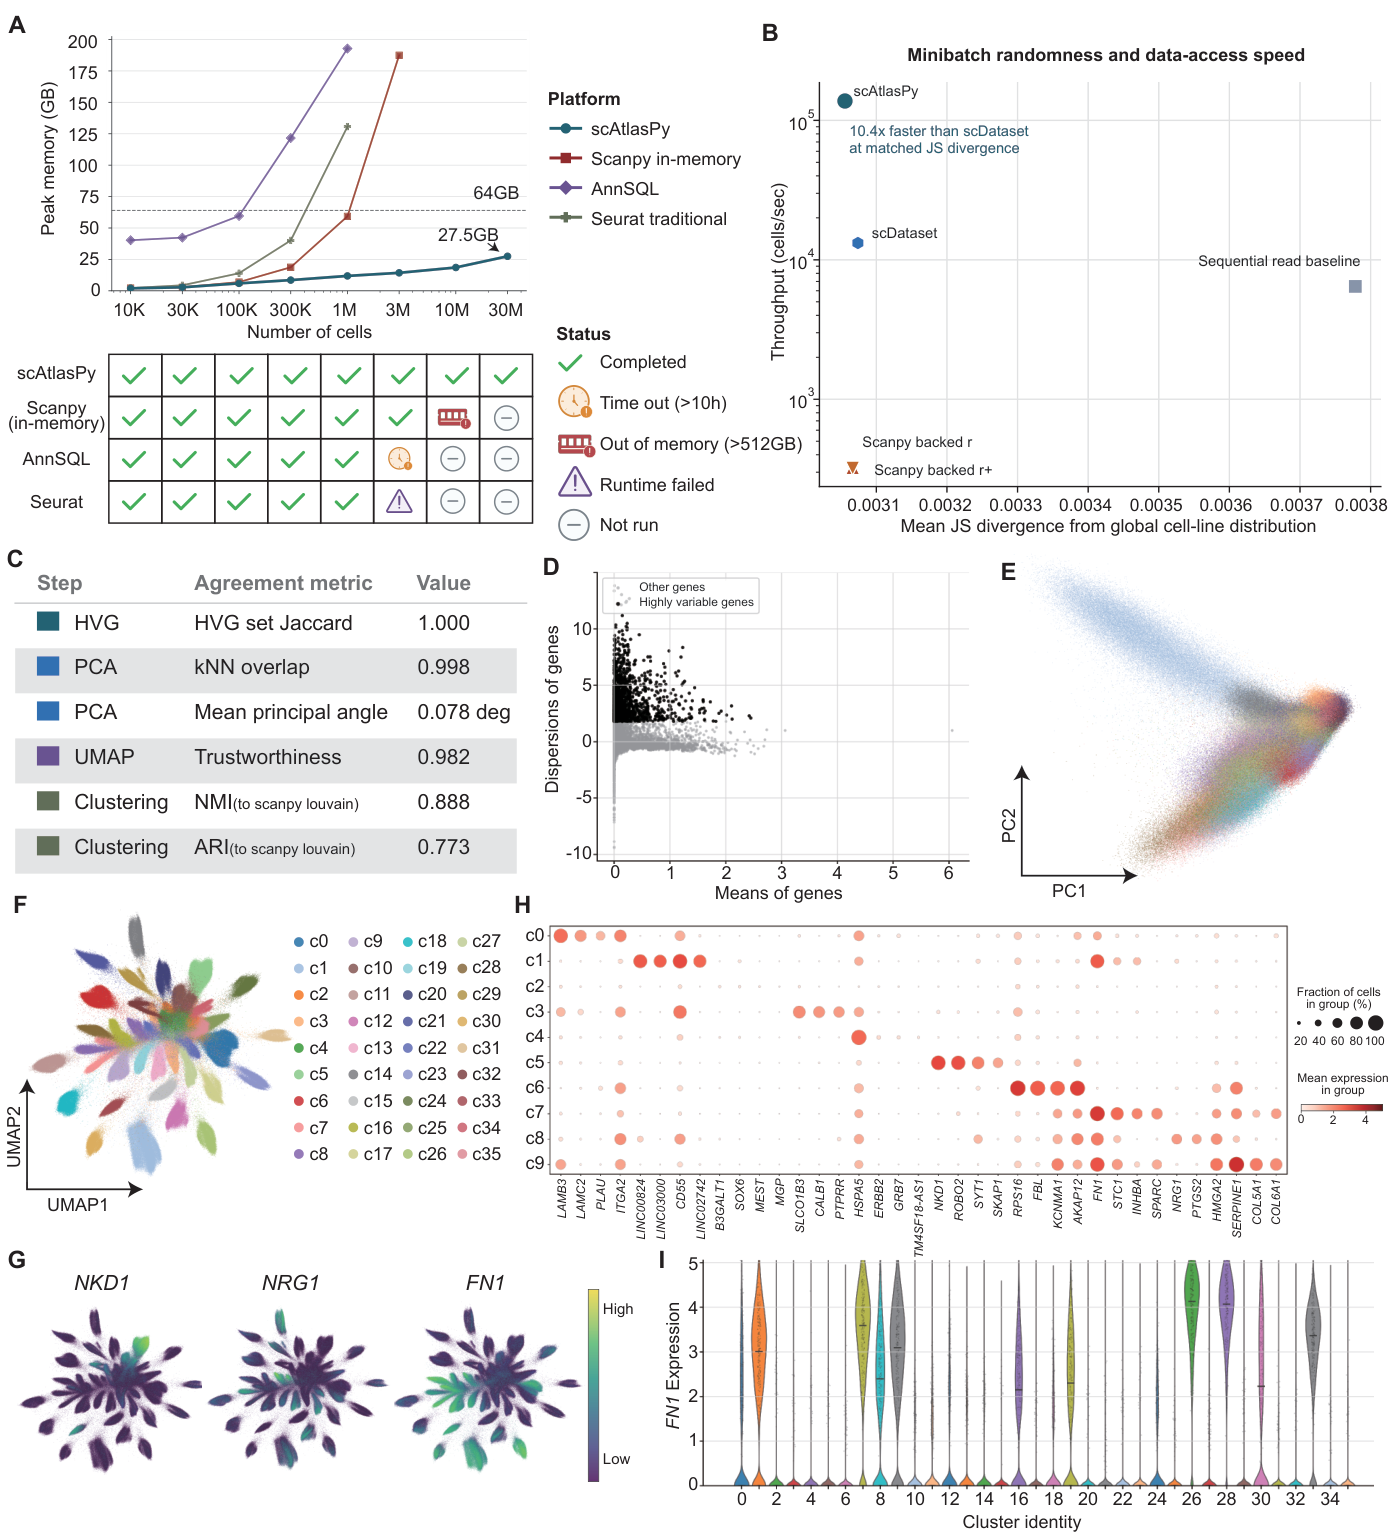
A 的对照在首次超过 512 GB RSS、10 小时或发生错误后停止,更大规模标为未运行;虚线 64 GB 不是服务器的物理内存。B 是独立的 minibatch 读取实验,C 是 HLCA 对照。D–I 为亿级数据的示例输出;全量细胞获得结果不意味着对一亿细胞显式构建了完整邻居图。
Xu et al., bioRxiv (2026), Figure 2. · CC BY 4.0 · 原图未修改 · 原文图 · 放大独立读取基准:10.4 倍加速究竟测了什么
读取实验使用 Tahoe plate 1 的 5,481,420 个细胞,batch size=2,048;先 warmup 20 个 batch,再测量 2,000 个 batch,即约 410 万次细胞读取。报告的总时间包含 warmup,吞吐对应测量阶段。RSS 统计包括主 Python 进程与子进程,与整流程基准的监测设置需分开理解。
| 方法/原图标签 | 吞吐,cells/s | 峰值 RSS,GB | 总时间,含 warmup |
|---|---|---|---|
| scAtlasPy | 137,746 | 6.51 | 31.2 秒 |
| scDataset | 13,211 | 37.40 | 5.6 分钟 |
| Sequential read baseline | 6,446 | 2.21 | 10.7 分钟 |
| Scanpy backed r | 324 | 2.25 | 3.5 小时 |
| Scanpy backed r+ | 321 | 2.25 | 3.6 小时 |
表中数字来自 Extended Data Figure 2E;摘要/正文的吞吐写 137,745,差一个 cells/s,本页不把它解读成有意义的差异。相对所测 scDataset 配置,约 10.4 倍吞吐、82.6% 较低 RSS;这是读取实验,不是整套分析、模型训练或推断的统一加速倍数。scDataset 配置为 block_size=4、fetch_factor=16、12 个 worker,结果应连同这个设置阅读。PDF p13 与 Extended Data Figure 2
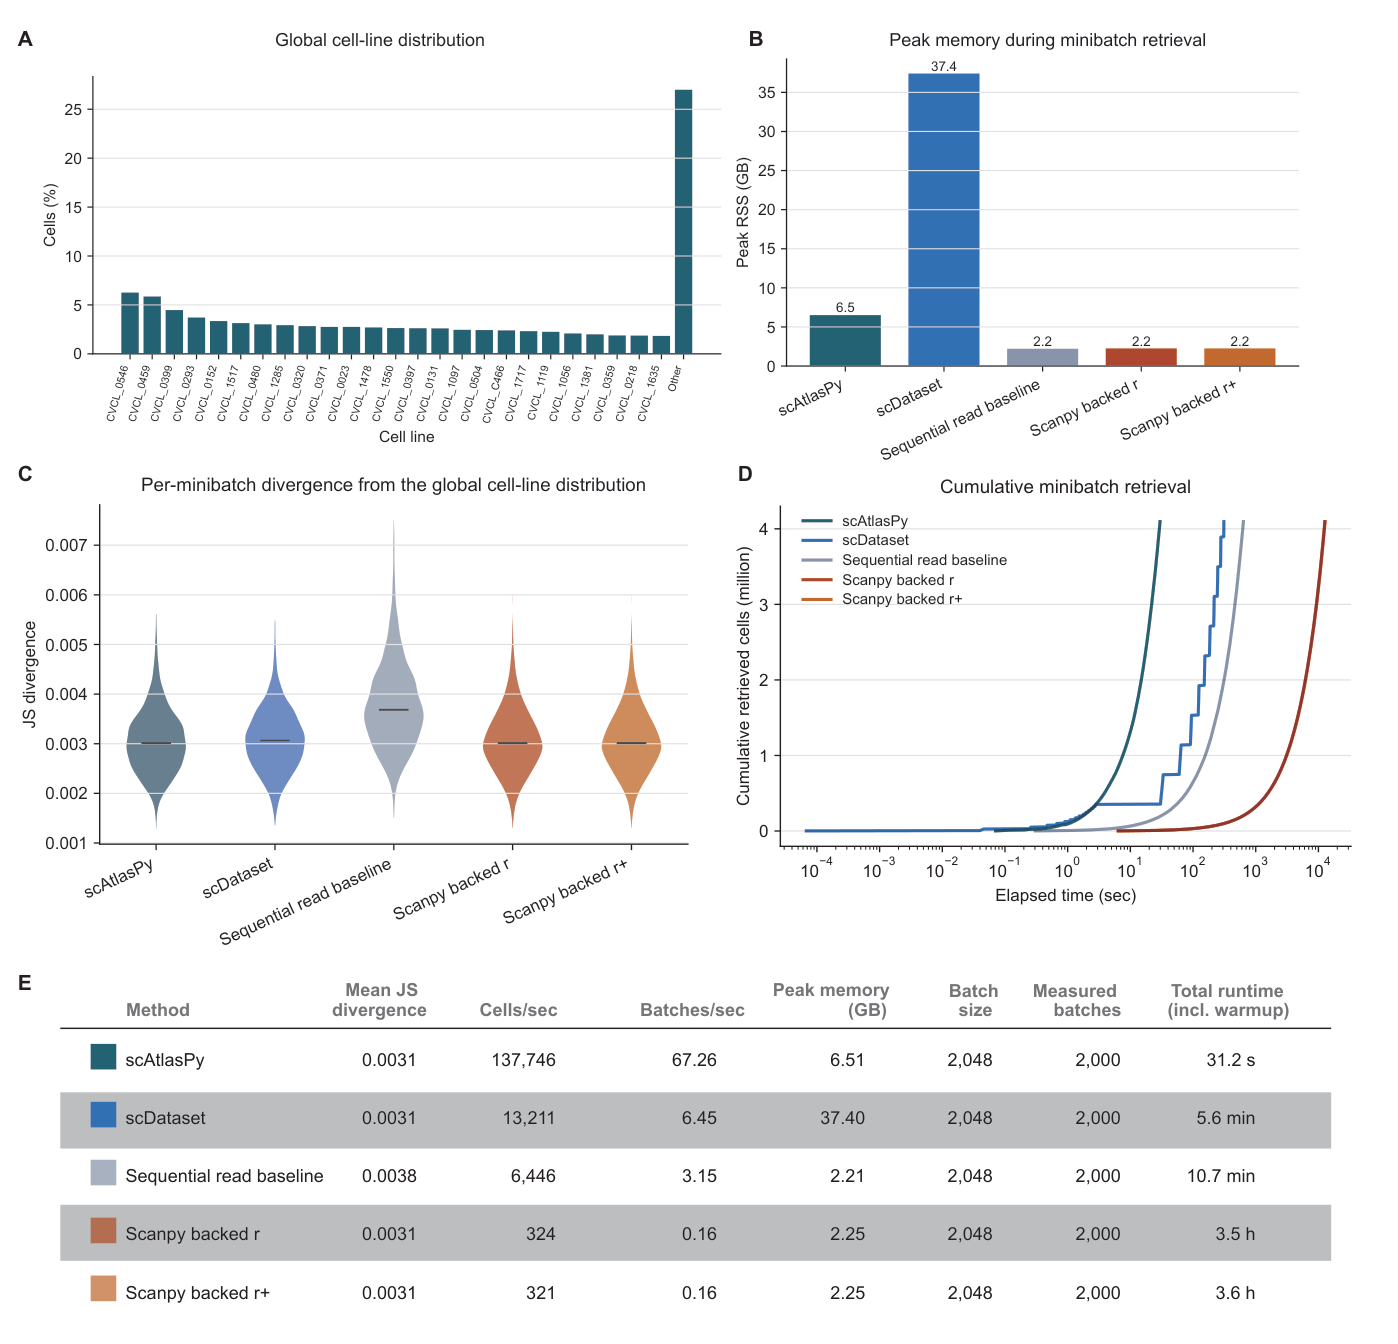
每批 2,048 个细胞,20 个 warmup batch 后测量 2,000 个 batch。E 中吞吐对应测量期,总时间包含 warmup;峰值 RSS 包括主进程与子进程。随机性以 batch 细胞系分布对总体分布的 JS divergence 衡量,不是全局均匀随机采样或逐细胞独立性的证明。
Xu et al., bioRxiv (2026), Extended Data Figure 2. · CC BY 4.0 · 原图未修改 · 原文图 · 放大随机性指标是每个 minibatch 的细胞系标签分布与总体分布之间的 Jensen–Shannon divergence。scAtlasPy 与 scDataset 的均值均约 0.0031,说明这项组成指标相近;它没有检验所有扰动标签、稀有状态、序列相关性或全局均匀采样性质。2,000 个连续 batch 也不等于 2,000 次独立重跑的性能实验。
HLCA:哪些输出接近,哪些只是近似
作者以常规 in-memory Scanpy 为参照,在 HLCA 上比较匹配的预处理和分析设置。HVG 的 2,000 个基因完全重合,PCA kNN overlap=0.998、kNN Jaccard=0.995;载荷子空间平均主角度为 0.078°,最大为 0.412°。这些结果支持所测数据上流式实现很好地保持了特征选择和主要线性子空间。
但后续非线性与聚类结果不完全相同。scAtlasPy/Scanpy 的 UMAP trustworthiness 分别为 0.982/0.985,而两个 UMAP 之间的邻域 Jaccard 仅 0.140。前者衡量嵌入对输入邻域的保持,不能拿它证明两个嵌入的局部结构完全一致。蒸馏 Louvain 与 Scanpy Louvain 的 NMI=0.888、ARI=0.773,簇数分别为 34 和 41。
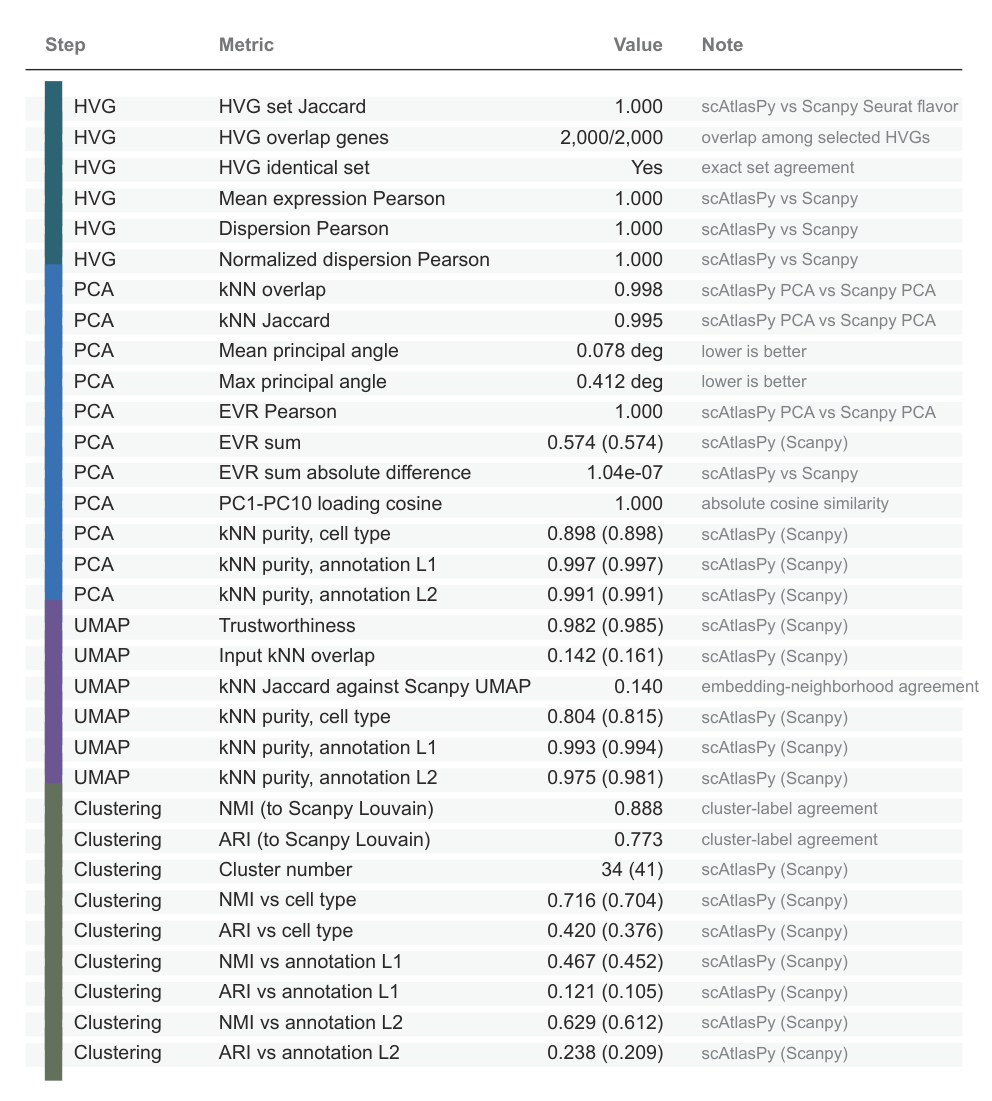
HVG 和 PCA 的吻合较高,但 UMAP 间邻域 Jaccard 只有 0.140;scAtlasPy 与 Scanpy 得到 34 和 41 个聚类。Trustworthiness=0.982 衡量对输入邻域的保持,不表示两个 UMAP 坐标或细胞邻域完全一致。
Xu et al., bioRxiv (2026), Extended Data Figure 3. · CC BY 4.0 · 原图未修改 · 原文图 · 放大与参考细胞类型标签比较时,两者也有各自表现;这些指标不能将 Scanpy 当作已知生物学真值,更不能单凭总体 NMI 判断稀有细胞是否保留。Extended Data Figure 4F 还显示跨来源数据集的明显 batch effect,说明“算得下”没有自动解决 atlas 整合问题。
样本规模需保留原文层次:Extended Data Table 2 列出 HLCA core 584,944 个细胞、166 位供体,另列 HLCA subsample 235,149 个细胞、68 位供体。作者将一致性实验描述为 HLCA core,但没有在 Methods 中将每项指标逐一绑定到这两个条目的具体过滤后细胞数;本页不擅自为所有指标补一个统一精确 N。
一亿细胞笔记本实验:导入和 PCA 仍是主要耗时
完整 Tahoe 输入为 100,648,790 个细胞、62,710 个基因特征。作者在配备 Apple M5 Pro、18 个 CPU 核心、64 GB unified memory 和 4 TB 内置 NVMe SSD 的 MacBook Pro 上执行工作流,报告 7.68 小时完成导入、预处理、PCA、聚类/UMAP 及下游输出,得到 36 个簇。它是论文报告的具体硬件实验,不能直接外推为任意 64 GB 电脑都有相同耗时。Experimental Environments,PDF p14
主文写峰值 42.86 GB,Extended Data Figure 6 标为约 42.9 GiB。这里保留原文单位差异,不将二者视为经过换算的同一个精确测量。图中导入约占 3.4 小时,PCA 约占 1.7 小时,明显长于后续蒸馏式聚类和 UMAP;因此不能只摘出嵌入预测时间来代表整个分析成本。
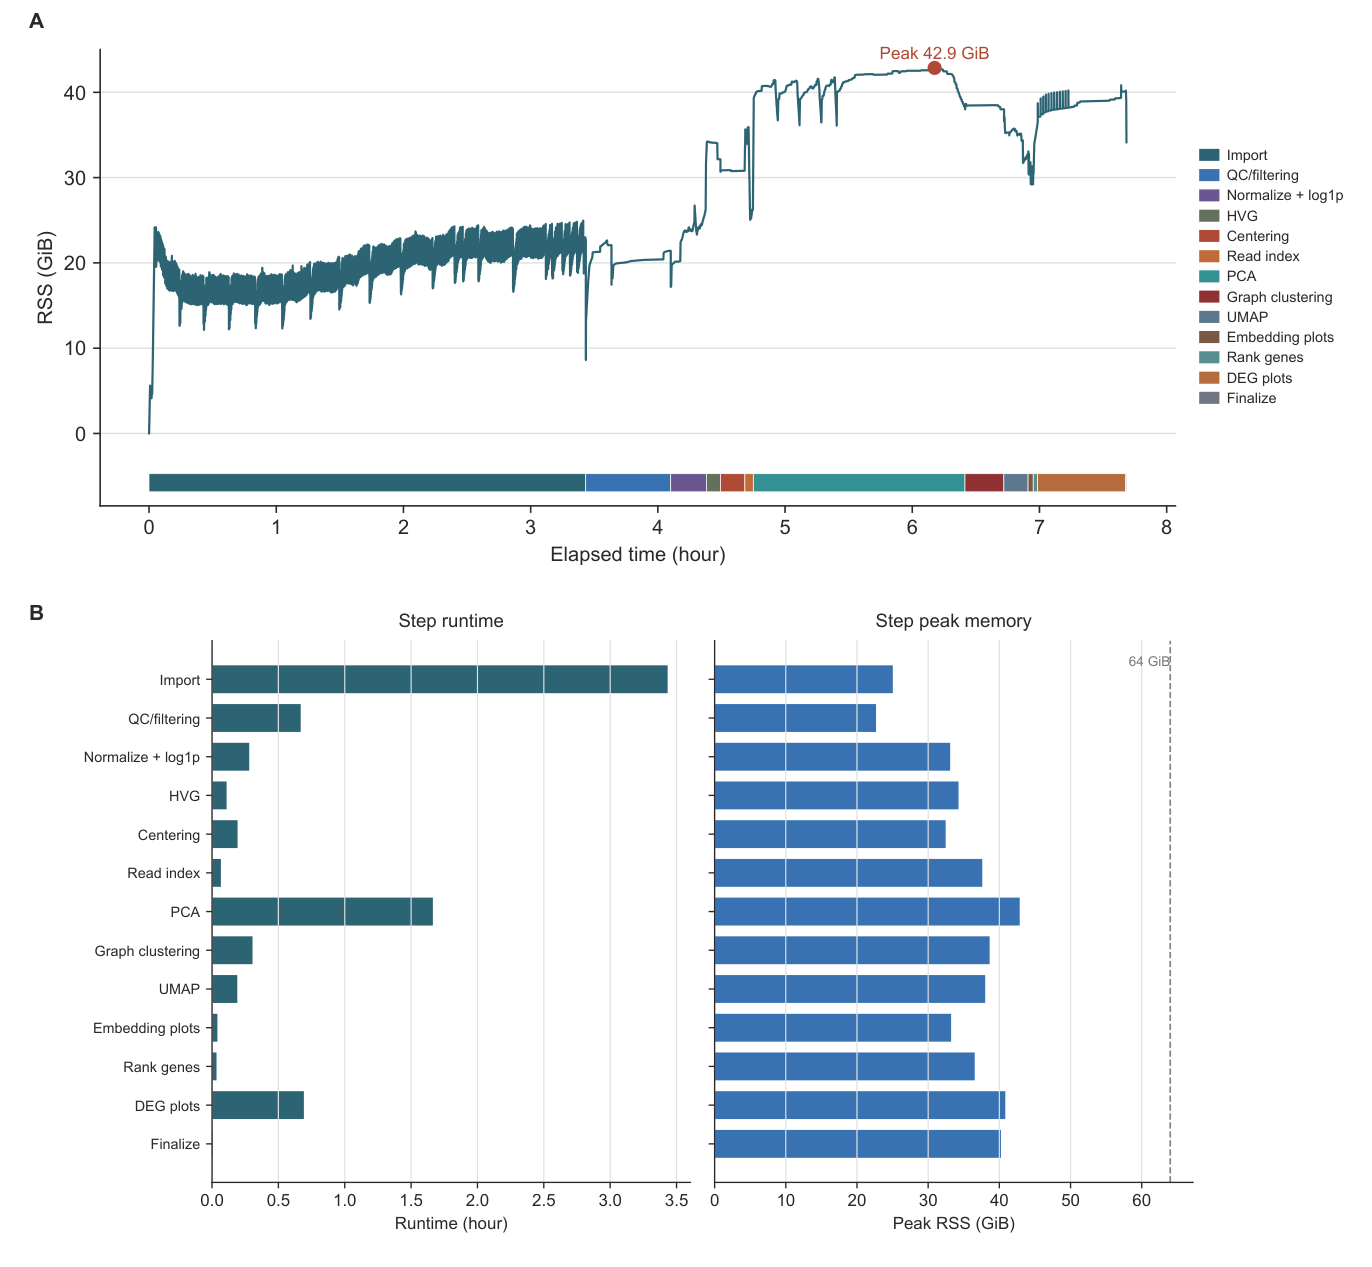
总耗时为 7.68 小时,包含导入、预处理、读索引、PCA、蒸馏式聚类/UMAP 和下游输出;导入与 PCA 是主要耗时部分。原图以 GiB 标记约 42.9 的峰值,正文写 GB,本页保留该单位差异,不擅自作数值换算。
Xu et al., bioRxiv (2026), Extended Data Figure 6. · CC BY 4.0 · 原图未修改 · 原文图 · 放大NKD1、NRG1、FN1 的表达图及簇标记展示了平台可输出可解释的探索性结果,但它们不是新发现细胞类型或扰动机制的独立验证;marker/差异表达功能也不自动构成供体感知的差异检验或细胞特异 QTL 方法。
对算法开发的启发及现有证据边界
最可复用的是三点:将表达和分析状态持续保存在磁盘上;把随机化与顺序 I/O 联合设计;为需要不同计算策略的下游方法提供统一的 minibatch 接口。不过,PCA 的数值近似、子集教师的统计代表性、磁盘查询效率是不同问题,应分别评价,不能用一个吞吐指标替代全部验证。
本页依据用户提供的 35 页 v1 全文,覆盖正文、Methods、两张主图、Extended Data Figures 1–7 和 Tables 1–3。公开 PDF 与上传文件的提取文字逐页相同,所选四张图的渲染像素一致;转载图来自同一 v1 的完整原图页,没有重绘实验结果。
PDF 中提到的独立 Supplementary Notes 1–2、Supplementary Tables 1–6 未包含在这份附件中。作者 Figshare 元数据列出约 8.18 GB 的代码/结果压缩包,本次未下载或运行,也未核查全部实现默认值、磁盘占用、重复运行波动和跨硬件表现。因而此处认可的是论文展示的数据结构与基准证据,不将其写成已经独立复现的速度或精度保证。