SCIGMA:可扩展的空间多组学图表示学习
Scalable, generalizable and uncertainty-aware integration of spatial multiomics across diverse modalities and platforms with SCIGMA
SCIGMA 为每种模态联合构建空间邻接图和特征相似图,以图注意力编码器、跨模态注意力及不确定性感知的对比学习得到联合表示,并通过图采样扩展到百万级空间位置。
本文目录
研究问题
配对空间多组学的困难不只是不同模态量纲不同。每种模态还具有不同的稀疏性、噪声结构和有效特征数;同时,空间邻近并不保证分子状态相似,远距离位置也可能属于同一组织结构。一个可用的整合方法需要同时保留空间局部关系、模态内相似性和模态间共享信息。
SCIGMA 的目标是学习每个空间位置的联合低维表示,用于空间域识别、轨迹分析、去噪和模态重构,并为每个位置输出跨模态整合难度。
模型结构
设第 个模态的特征矩阵为 。SCIGMA 为每个模态构建两类图:
- 空间图 :由组织坐标的近邻关系得到;
- 特征图 :由该模态的表达、可及性、蛋白或图像特征近邻得到。
论文把两类边取并集,形成模态特异的组合图 。图注意力编码器计算
其中邻居贡献由数据驱动的 attention weight 决定,而不是固定平均。这样可以降低普通 GCN 在高连接图中产生的 over-smoothing。
随后,跨模态 attention 根据每个位置上不同模态的表示生成联合表示 。各模态还配有 GAT decoder,从 或联合表示重构原始特征,以避免嵌入只对空间聚类有效、却丢失模态信息。
不确定性感知的对比学习
常规对比学习会强制同一空间位置在不同模态中的表示接近。对真实组织而言,这一约束不总是合理:RNA 与染色质、蛋白或代谢物可能具有不同时间尺度,也可能因技术质量差异而不一致。
SCIGMA 在位置层面学习 uncertainty parameter ,用它调节位置 的跨模态对齐强度。直观上:
- 较低时,模型认为各模态应能较好对齐;
- 较高时,模型允许该位置保留较大的模态差异。
需要谨慎的是, 不是“该空间域错误的概率”,也不是带 coverage 保证的置信区间。它反映模型在当前 loss 和数据表示下的对齐困难,可能同时受到真实生物异质性、低测序深度、组织边界和批次伪影影响。
可扩展性
全图 GAT 的内存通常随节点数和边数快速增加。SCIGMA 通过 graph sampling 在每次训练中只加载局部子图,使百万级 Visium HD 或 Xenium Prime 位置可以在单 GPU 上训练。
评价这一点时应区分:
- 能运行:不发生 CPU 内存或 GPU 显存溢出;
- 训练速度:每 epoch 和达到收敛所需的 wall-clock time;
- 统计近似:子图采样是否改变稀有边界区域、长程组织结构和 uncertainty map。
论文证明了可运行规模,但不同采样率下表示与空间域的稳定性仍值得进一步量化。
图注意力与跨模态整合
Figure 1 的关键不是网络层数,而是三条信息流:
- 模态内信息:每种模态有自己的特征图、GAT encoder 和 decoder;
- 空间信息:坐标近邻加入每个模态的图;
- 跨模态信息:attention 与 contrastive objective 只在编码后对齐表示。
这种结构比先把所有特征直接拼接更灵活,但图并集将“空间近邻”和“分子近邻”都表示为边,若没有显式 edge type,模型主要依靠 attention 自行区分两类关系。
Benchmark 与主要结果
作者在 19 个数据集上评估方法,覆盖 8 种模态、10 类组织和 9 个平台。对可由其他方法完成的配对数据,比较内容包括空间域识别、Moran’s I、模态重构、跨运行稳定性和生物标记恢复。ablation study 分别去除空间图、特征图、对比损失、uncertainty,或把 GAT 替换为 GCN,用于判断各模块的贡献。
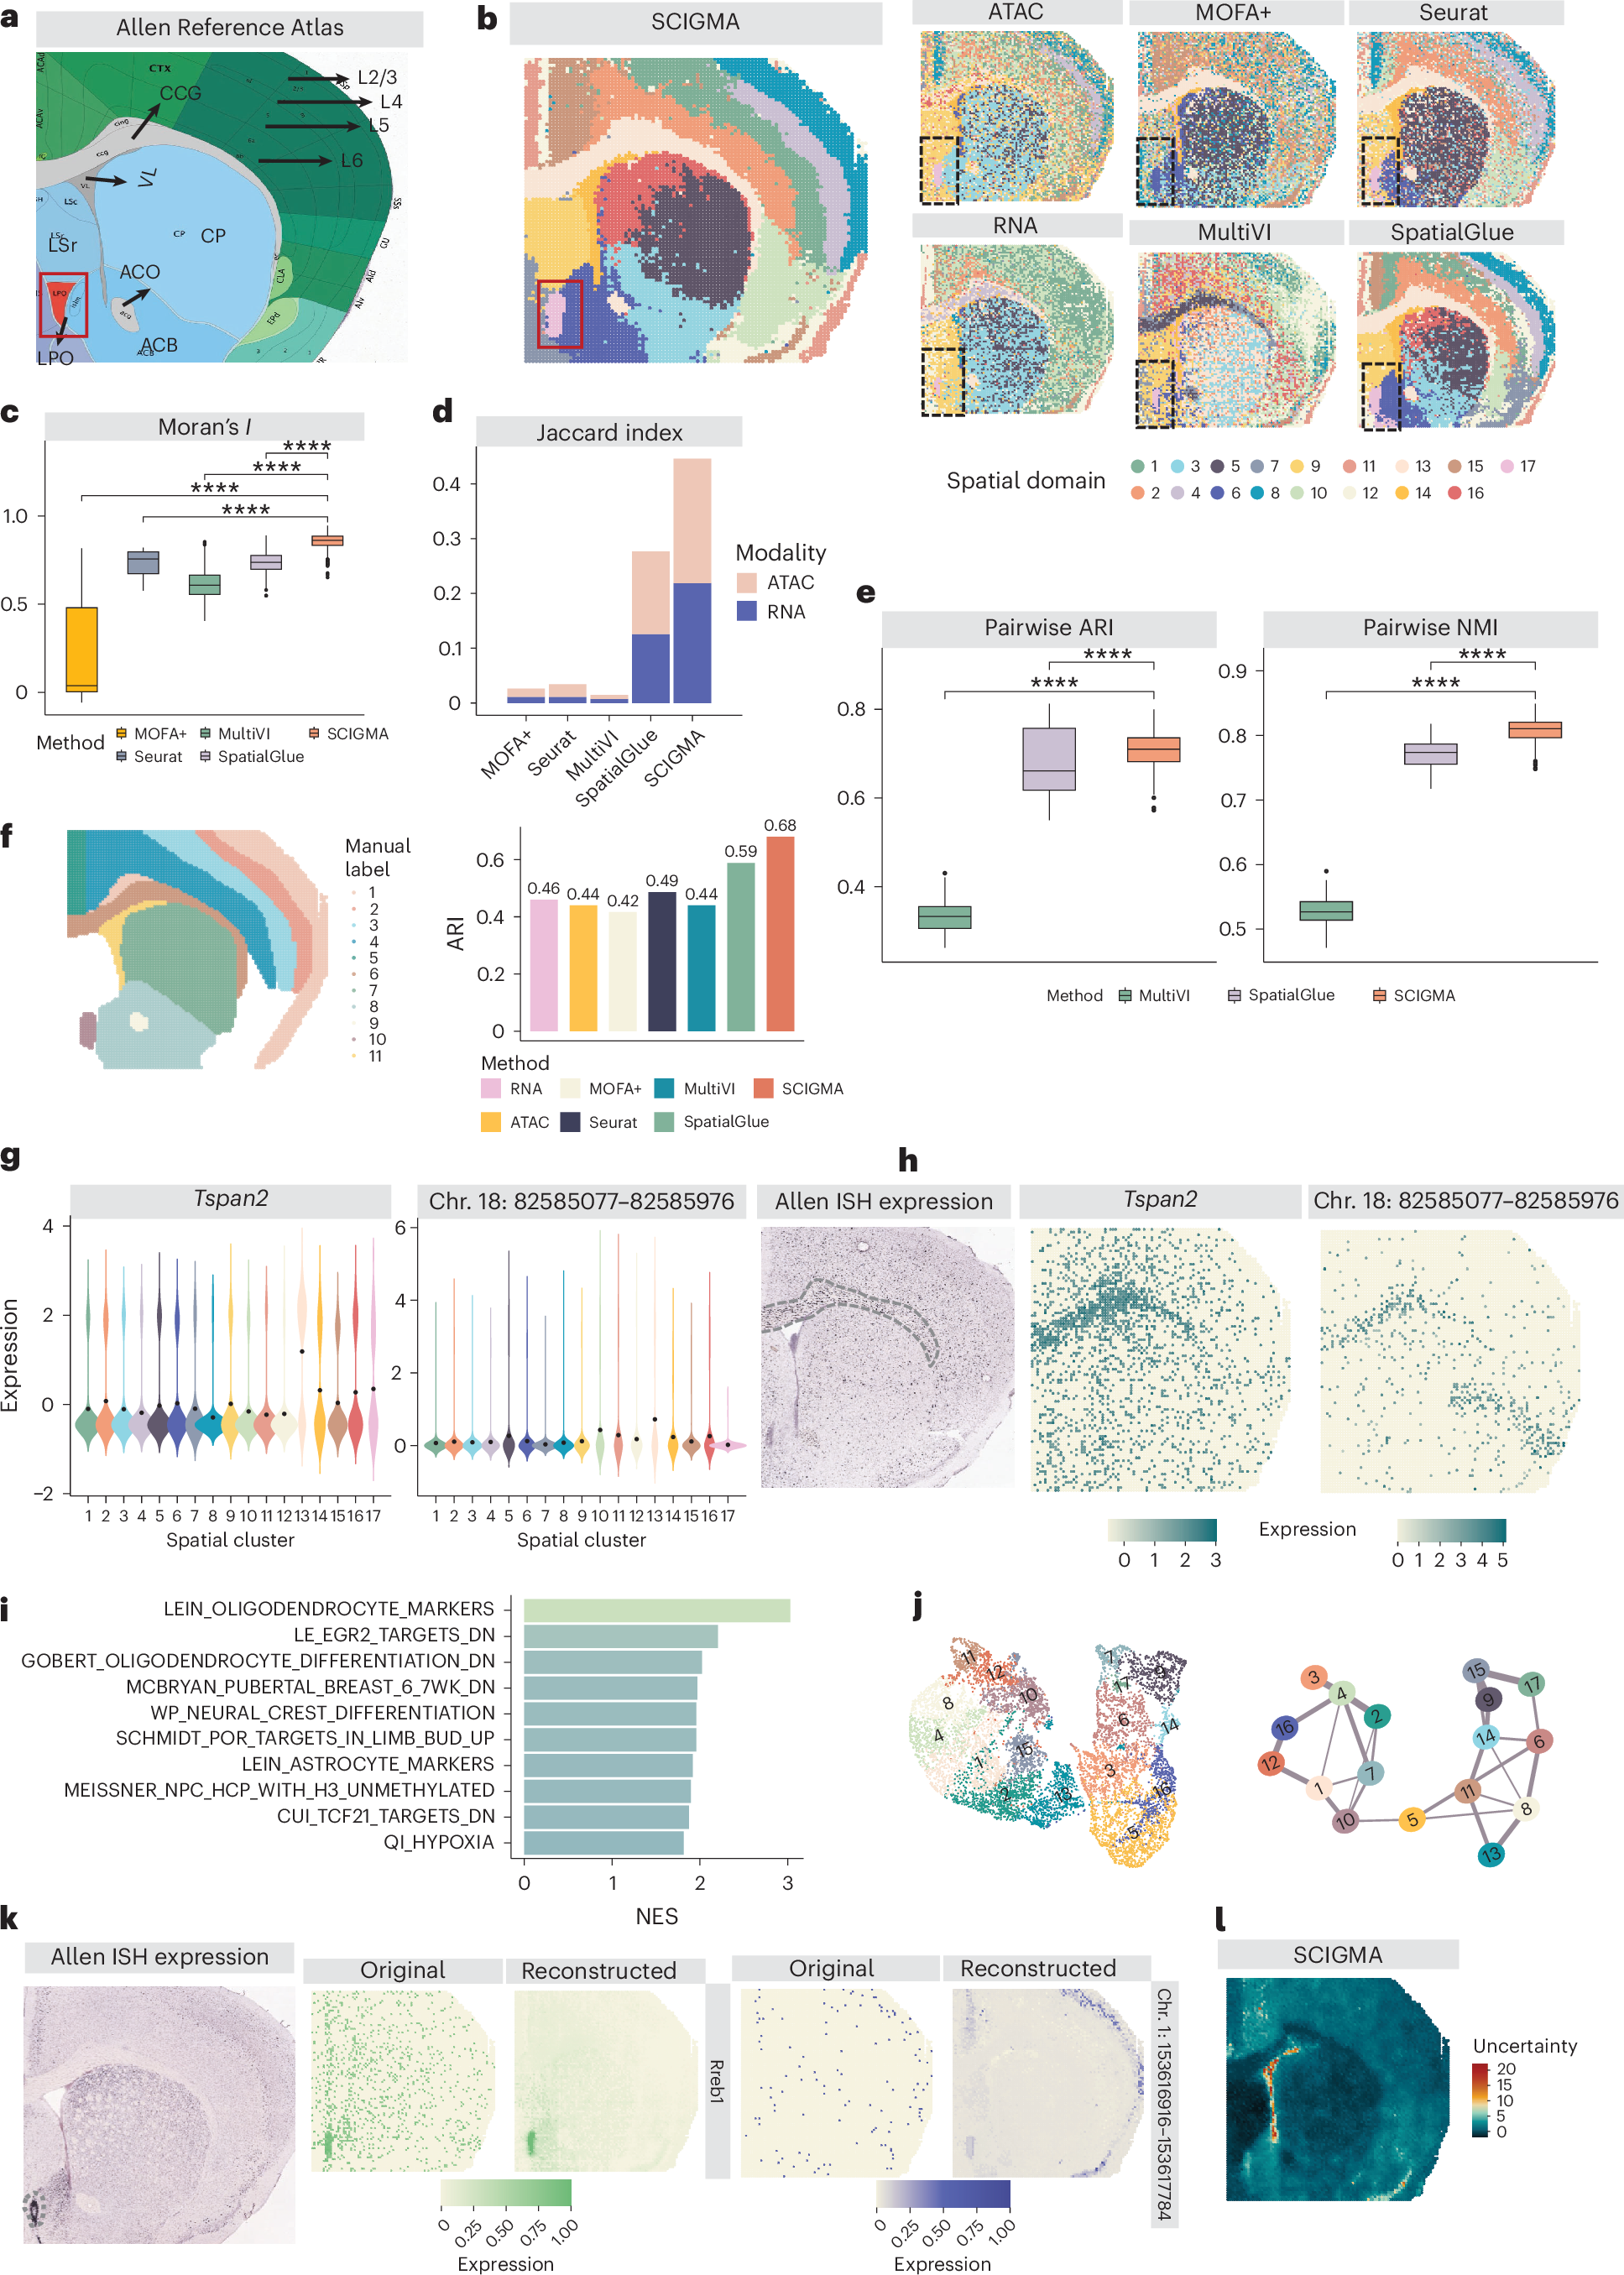
先比较联合表示恢复的脑区与组织解剖是否一致,再看 ATAC 与 RNA 各自的标记是否被保留;跨随机运行的稳定性比单次 UMAP 的视觉效果更重要。
Chang, Fleischmann & Ma, Nature Genetics (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大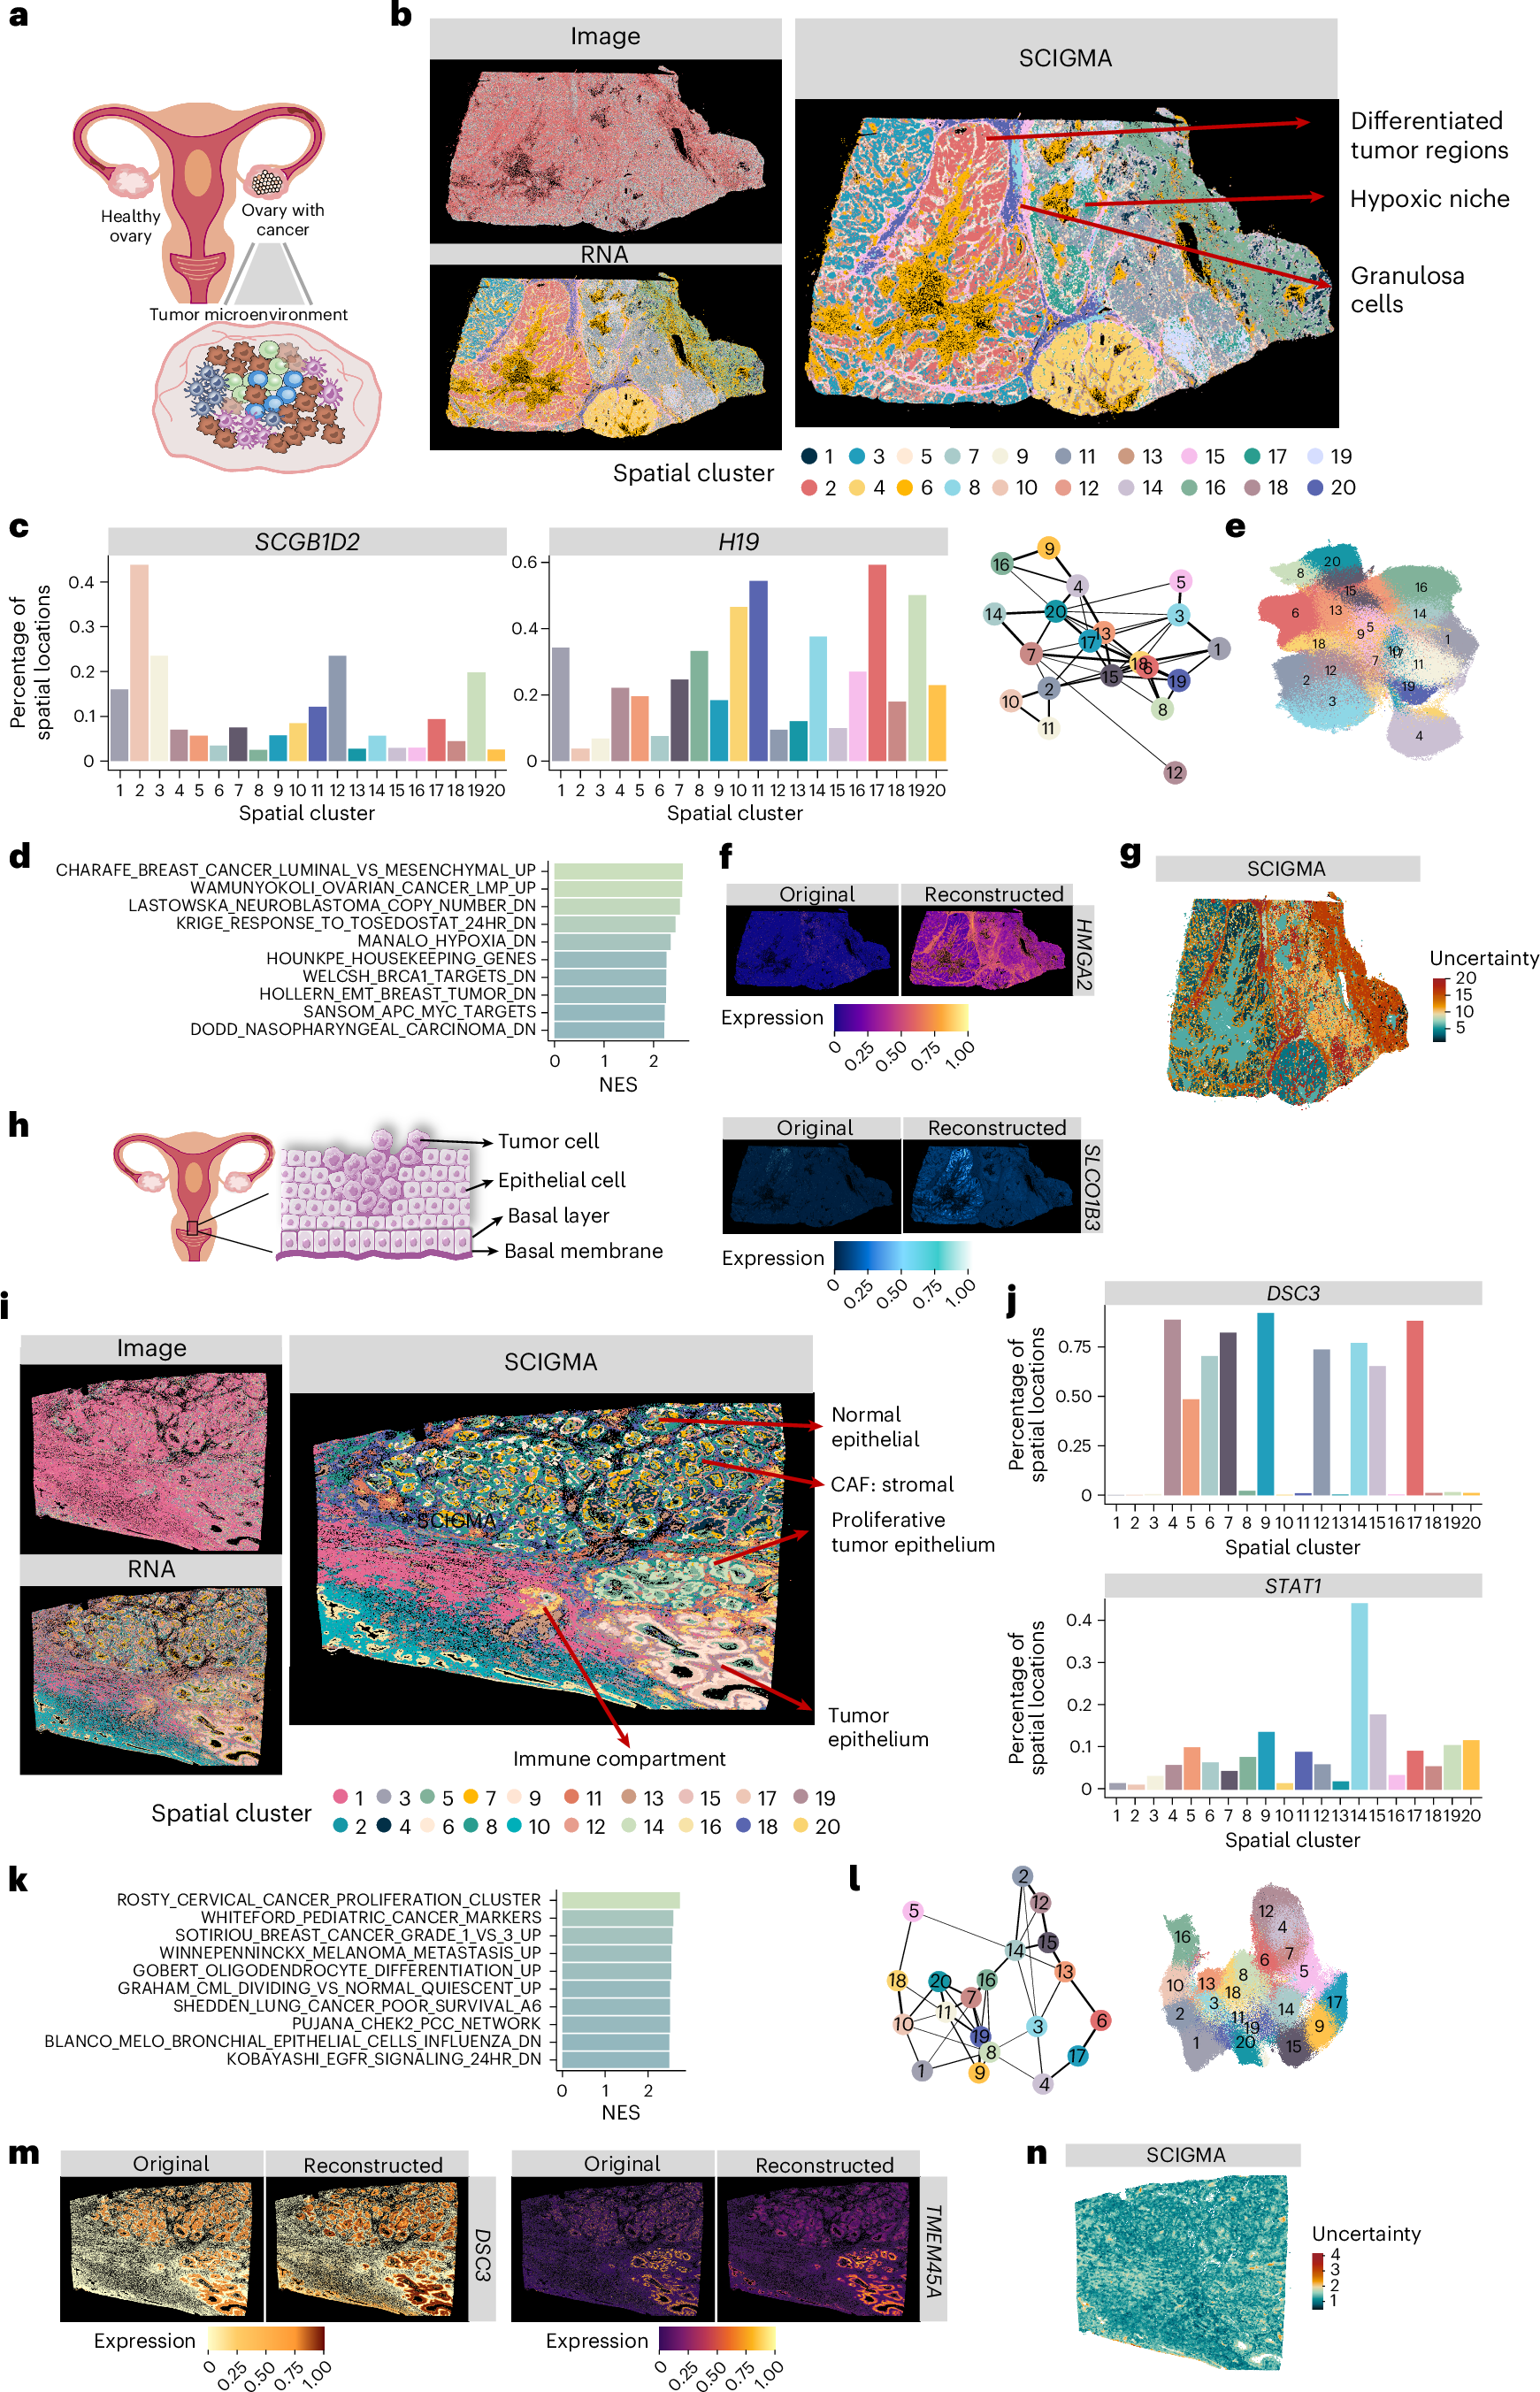
图中比较 RNA 与形态图像整合后的肿瘤亚区、标记基因和模态贡献。阅读时同时检查不确定性较高的区域是否对应重构误差、模态冲突或真实肿瘤异质性。
Chang, Fleischmann & Ma, Nature Genetics (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大在部分大数据上,对照方法在 48 小时、400 GB CPU memory 或 24 GB GPU memory 条件下不能完成,因此这些数据只能展示 SCIGMA 的结果,不能形成完整的性能排名。阅读“scales to one million locations”时,应把它理解为重要的工程可行性证据,而不是所有大规模数据上的相对优势已经被公平估计。
统计解释上的注意点
空间域 benchmark 可能依赖已知标签
ARI、NMI 等指标需要参考分区,但组织学标签本身有分辨率和主观性。模型发现比参考更细的结构时,分数可能下降;过度平滑得到与粗标签一致的区域时,分数可能反而上升。因此需要同时查看 marker、组织图像和跨切片复现。
重构准确不等于生物信号正确
decoder 的 RMSE 反映特征能否从表示恢复,但高丰度、空间平滑的特征会主导平均误差。稀有细胞状态和局部调控信号需要单独评价。
uncertainty 需要外部校准
可进一步用 held-out modality、人工降采样、已知组织边界和重复切片检验:高 uncertainty 是否预测更大的重构误差或更低的跨重复一致性。没有这些校准时,它更适合作为诊断分数而不是正式概率。
局限
- 输入通常是共定位的 paired modalities,不能直接解决完全未配对样本的整合;
- 图构建参数、特征预处理和近邻数会影响组织边界;
- graph sampling 可能削弱长程关系;
- uncertainty 混合生物和技术来源;
- 大数据 benchmark 中部分对照方法未完成,性能比较并不完整;
- 深度模型的随机性要求报告多次运行,而不是只展示最佳空间图。
小结
SCIGMA 最有价值的部分是把模态特异图、联合表示和大图采样组合起来。若将其用于新的空间平台,优先检查的不是聚类图是否漂亮,而是不同预处理和随机种子下的稳定性、uncertainty 与真实误差的关系,以及稀有组织结构是否在采样中被保留。