空间转录组 CNA 评测:任务、参考数据与方法选择
Benchmarking copy number alteration inference methods for spatial transcriptomics
ST-CNABench 在 69 张组织切片中比较 9 种 CNA 推断方法,将谱恢复、肿瘤分类、切片内亚克隆与跨切片演化分开评测,揭示准确性与计算成本随任务和参考数据而变。
本文目录
已核对期刊已接收稿的主要结果、方法、讨论与 Figure 2、6;补充材料尚未逐项核验。
空间转录组的 CNA 推断同时面对稀疏表达、spot 内细胞混合与有限等位基因信息。这项研究比较 9 种方法,在主要评测中纳入 69 张组织切片、6 类癌症、4 种空间转录组平台,其中 57 张切片具有配对 DNA 测量作为参考。69 是切片数,不能视为独立供体数。主要 RNA 平台为传统 ST 2K、Visium、Visium FFPE、Slide-seq v2;配对 Slide-DNA-seq 提供空间基因组参考。另有 CosMx 6K、Xenium 5K、Visium HD FFPE、Stereo-seq 的探索性高分辨率分析。全文
四个任务,四种不同的证据
| 任务 | 参考与评价重点 |
|---|---|
| CNA 谱恢复 | 配对 WES 等 DNA 数据,经 FACETS 推断拷贝数;比较 gain/loss、cnLOH、信号一致性与片段边界 |
| 肿瘤/正常分类 | 病理医生标注;比较 MCC、F1、call rate 等,并检查二倍体基线的影响 |
| 切片内亚克隆识别 | 配准的人结直肠癌 Slide-DNA-seq/Slide-seq v2;同时评价聚类标签与克隆 CNA 谱 |
| 跨切片克隆演化 | 单名前列腺癌患者的 3 张切片;Gleason 分级作为软参考,主要是定性评价 |
在 CNA 谱比较中,作者把输出映射到共同的 100 kb bins,再对非参考 spots 取均值,与样本级 DNA 参考比较。因此,高相关系数证明的是聚合后的谱一致性,不直接证明每个 spot 的 CNA 判断准确。连续表达衍生分数与离散 CNA calls 也分别评价,避免把同一方法不同输出混为一谈。方法
连续谱保真度、事件检出与分类表现
**连续谱保真度和事件可靠性存在取舍。**Numbat 的连续表达输出、Clonalscope 的 DNA 先验模式表现突出;InferCNV、SCEVAN 的连续输出和 CopyKAT 也处于较强的一组,部分组间差异不显著。离散状态通常更能抑制二倍体样本中的假阳性,但可能损失较弱真信号。对 focal CNA,按“小于 3 Mb”或“小于染色体臂 25%”定义的检出灵敏度通常低于 0.4;cnLOH 则受到杂合 SNP 覆盖与 BAF 偏离程度的限制。匹配 DNA 先验明显改善 Clonalscope 的片段恢复和边界定位,CalicoST 是有竞争力的无 DNA 先验方案。Figure 2 把这些维度与时间、内存同时展示。Figure 2 与结果
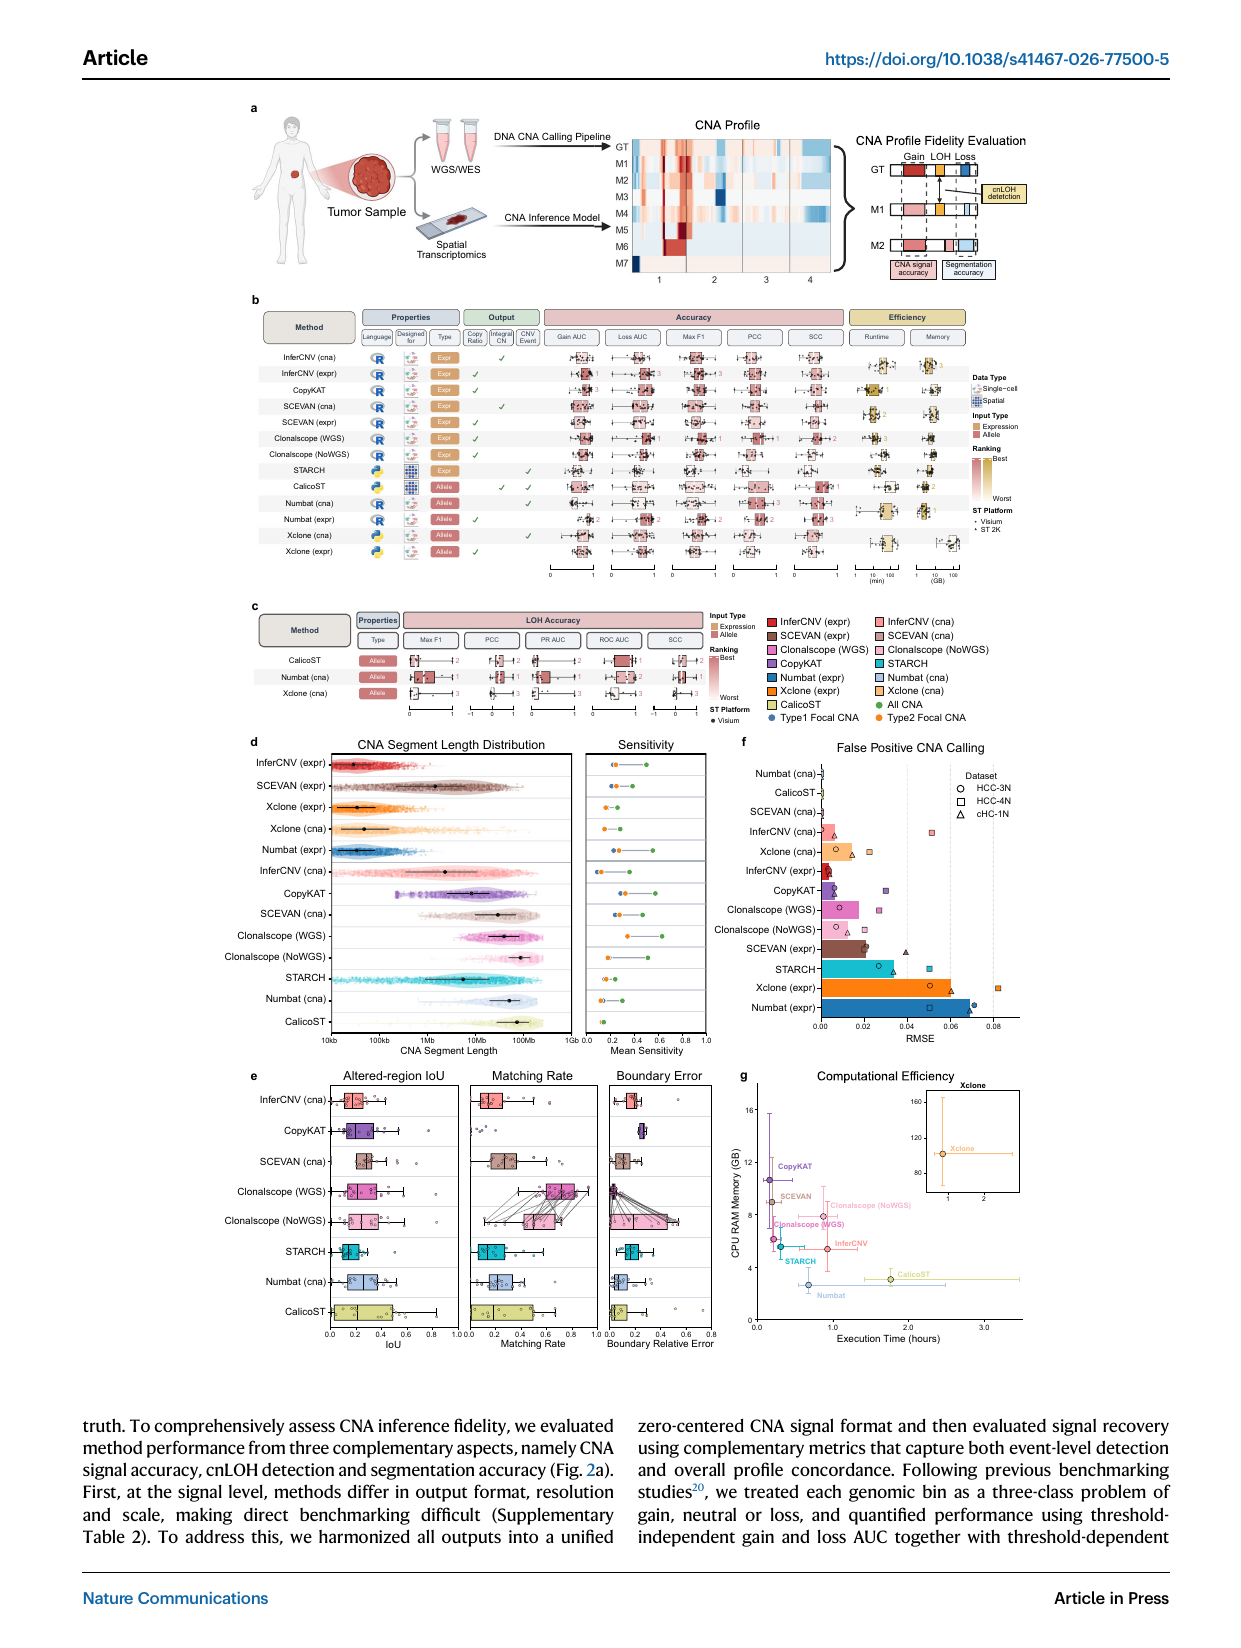
原文 Figure 2 所在完整 PDF 页:并列评估 CNA 信号恢复、cnLOH、focal CNA、片段边界、二倍体假阳性与时间/内存。请结合正文区分连续表达输出和离散 CNA 输出;图为完整原页渲染,未裁剪、重绘或改色。
Han et al., Nature Communications (2026) · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大**分类、聚类和基因组重建不能互相替代。**STARCH 与 CopyKAT 的总体肿瘤分类排名靠前,尽管 STARCH 的 CNA 谱保真度并不突出。高肿瘤比例会使参考基线失准;一个案例加入 148 个可信正常参考 spots 后,Numbat 和 InferCNV 的 MCC 分别达到 0.81 和 0.82。切片内亚克隆评测中,Clonalscope 与 SlideCNA 在标签和克隆谱两个视角较一致;CalicoST 可呈现较好的聚类分离,却未必重建出有信息的克隆 CNA。跨切片 Numbat 表现出较连贯的演化结构,但这里没有真实演化树,不能把病理一致性称为演化推断准确率。Figure 3–6
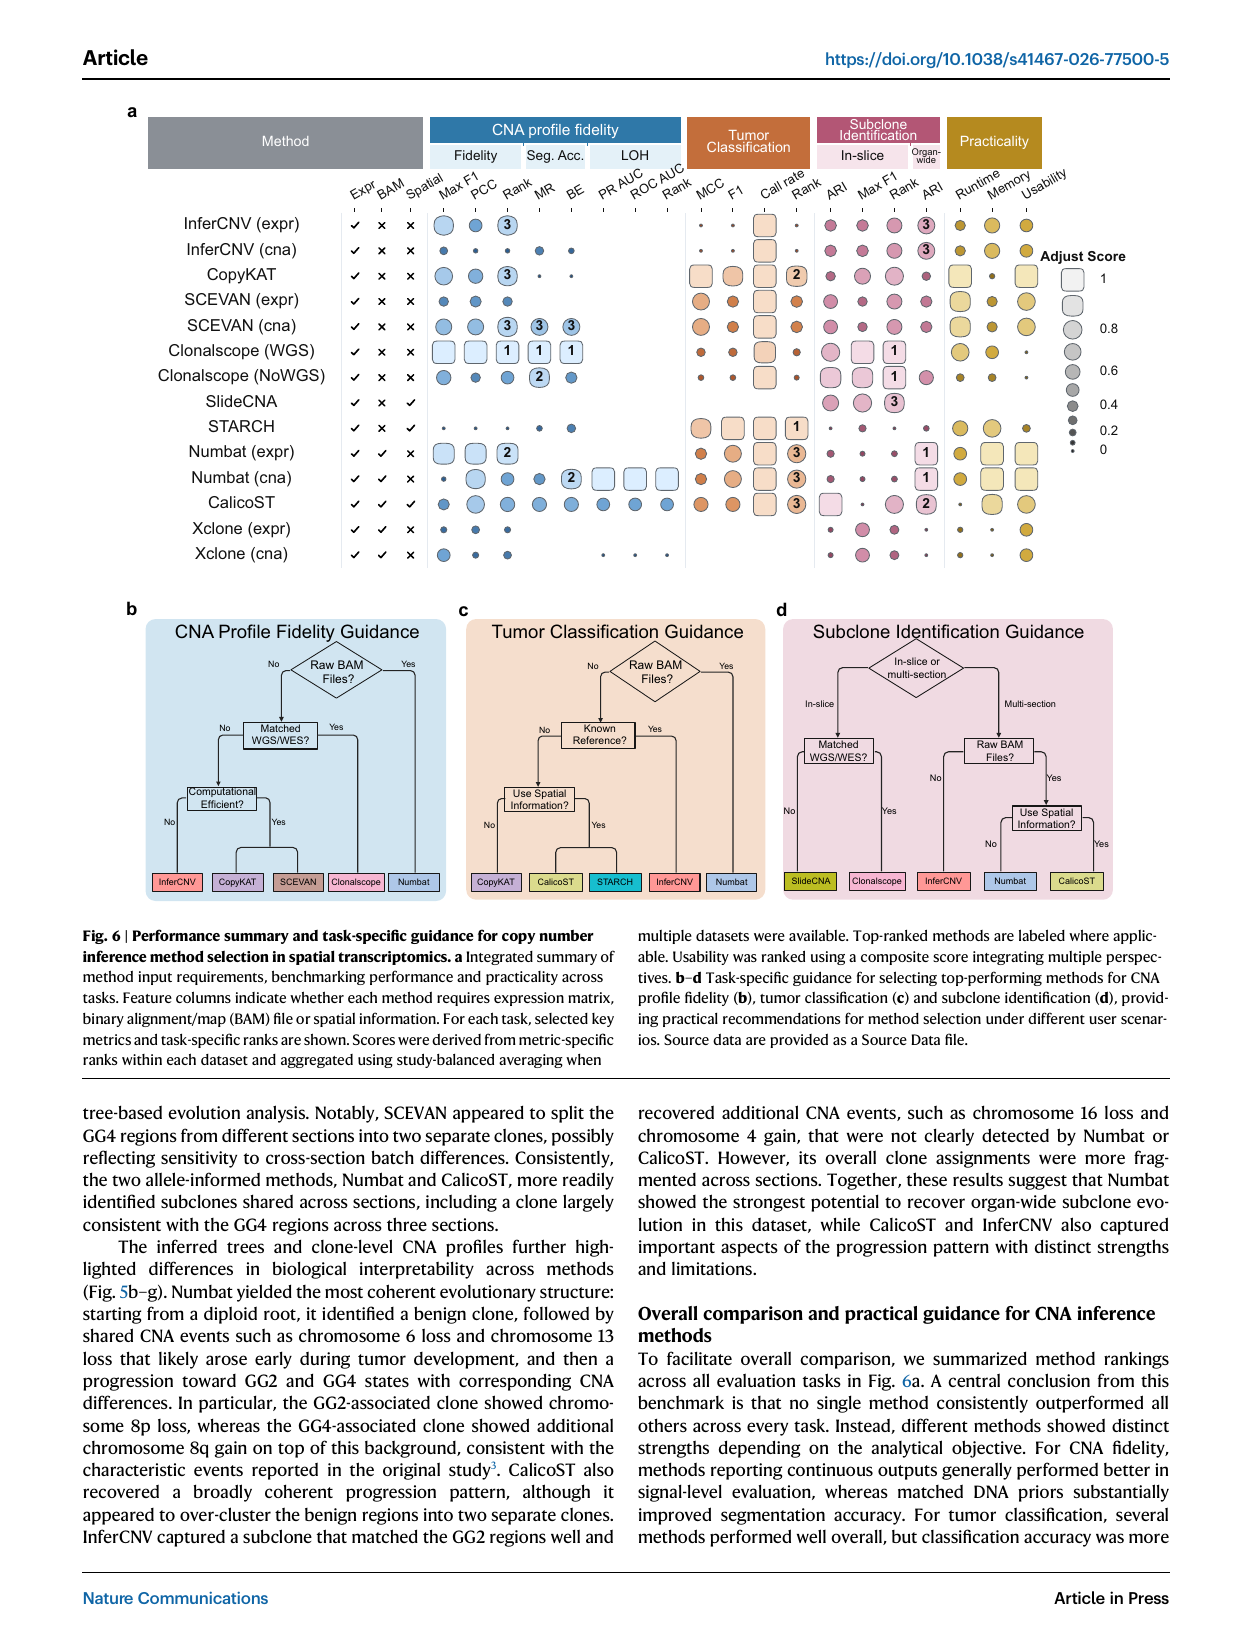
原文 Figure 6 所在完整 PDF 页:按任务汇总方法表现,并按原始 BAM、匹配 WGS/WES 和参考样本可用性给出选型路径。归一化分数来自任务内排名,不是准确率;图为完整原页渲染,未裁剪、重绘或改色。
Han et al., Nature Communications (2026) · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大参考标签与计算资源的限制
这篇最有用的设计是把预测对象拆开,再分别定义参考和损失函数。对自己的方法评测,可借鉴其按研究等权汇总排名的方式,减少切片较多的研究主导结果;同时报告原始指标,避免归一化排名掩盖实际差距。还需注意,作者的 maximum F1 在参考标签上搜索最优阈值,适合描述可分性,不能解释成未知数据上预设阈值的部署性能。部分亚克隆方法被提供真实克隆数,检验的是给定数量下的恢复能力。高分辨率分析缺乏配对 DNA,其参考来自同患者 scRNA-seq 推断的 CNA,证据层级弱于直接 DNA 参考。
计算方面,服务器配置为双 Intel Xeon Platinum 8373C、共 72 核、2.0 TiB RAM;各方法在支持时使用 20 核,无额外样本级并行,也没有使用 GPU。CopyKAT 和 SCEVAN 较快,但稠密矩阵转换增加内存开销;XClone 的峰值内存尤其高。空间聚合能改善稀疏信号,却牺牲分辨率:这为稀疏矩阵处理、混合成分建模和计算优化留下了明确问题。计算设置
作者代码 ST-CNABench 提供统一的 prep → run → eval 流程、方法独立运行环境及评价适配器。实际复现时应先确定目标任务、可用 DNA/BAM 与正常参考,再选择方法;Figure 6 可以作为阅读入口。