家内祖源效应:随机遗传分离、家庭混杂与解释边界
Within-family effect of ancestry on complex traits in a Mexican population
在墨西哥城队列中,比较 52,583 名无亲缘者与 17,627 个家庭、39,714 名亲属的祖源–性状关联。研究利用家内祖源的随机遗传分离,区分个体祖源效应与额外家庭祖源效应;身高和 T2D 提供显著结果,但家内估计精度较低,也不能直接解释为不经过社会环境的纯生物机制。
本文目录
为什么需要家庭,而不只是更多主成分
在人群层面,遗传祖源可能同时关联居住环境、教育机会、社会待遇和生活方式。因此“祖源与表型有关”并不能直接说明遗传差异导致了观察到的全部表型差异。本文利用同一家庭内不同子代继承祖源片段的随机分离,尝试把个体继承的祖源差异与家庭层面的祖源–环境关联区分开来。正文与 Methods
这里的祖源是基于遗传标记、相对于参考人群推断的连续比例,并非把人划分成生物学上离散的种族类型。研究对象又是墨西哥城特定混合祖源队列,因此结论不能直接外推为所有群体之间的平均差异,更不能用来判断某个个体的能力或健康。
队列与真正提供家内信息的变异
Mexico City Prospective Study 的分析使用 52,583 名至四等亲层面无亲缘关系的参与者,以及 17,627 个家庭中的 39,714 名亲属。亲属中有 30,407 对同胞;这是配对关系数,不是 30,407 个相互独立的观测。只有 2,847 个家庭的双亲都完成基因分型,其余家庭需要用子代信息估计家庭祖源均值。
总体推断祖源平均约为 Indigenous American(IAM)67%、欧洲 29%、非洲 4%,东亚不足 1%。IAM 的家庭间祖源标准差约为 0.167,而随机分离带来的家内标准差约为 0.020。家内分析虽然更有助于减少混杂,却只能利用很小的祖源差异,因此精度明显下降。
父母祖源相关也不弱:IAM、欧洲、非洲祖源的配偶相关分别约为 0.53、0.52、0.41。这种祖源择偶会改变遗传与家庭环境的相关结构,不能直接沿用随机婚配下最简单的家系解释。正文,Ancestry variation 与家庭结构
模型:个体祖源与额外家庭祖源同时入模
由于四类祖源比例相加为 1,模型以欧洲祖源为参照,放入其余三类比例。定量性状经过年龄、年龄平方等调整及性别内标准化,并加入居住区等协变量。省略固定协变量后,可以把模型写成
其中 是家庭 的第 个成员的祖源比例, 是家庭祖源均值, 为遗传随机效应, 为共享家庭环境。亲属之间的遗传协方差由 IBD 相关结构描述,而不是假设同一家人表型独立。
本文的 是调整个体祖源后额外增加的家庭祖源系数。 如果把个体比例改写为家庭均值加偏差,,则祖源项变成
因此,不能把论文表中的 between-family 系数 直接当作这个中心化表达式中家庭均值的总系数。这个细节会影响对图中家内、家间与人群系数关系的理解。
Supplementary Note 1 用单一祖源、家庭子代数相同的简化模型进一步说明:若真实生成机制为 ,定义 ,用 个子代的均值估计家庭祖源,则在该推导条件下
家庭祖源均值的测量误差会衰减额外家庭系数;人群系数也不是任意情况下都严格等于所估计的两个家庭系数之和。实际分析具有不等家庭大小、多祖源与随机效应,不能把这一简化公式当作所有数据设置的恒等式。Supplementary Note 1,模型与系数期望推导
T2D 的 OR 不是来自同一套随机效应模型
作者对 T2D 做了不止一种模型。把 0/1 表型放入线性混合模型的分析可包含遗传与共享环境两个随机项,并用于方差分析及其他效应尺度的比较;但是正文报告 log OR 的 logistic 混合模型使用的是 家庭随机截距,而没有同时放入 IBD 遗传随机效应。Methods 对软件实现与拟合限制作了说明。
因此,“本文控制了亲缘关系与共享环境”不能不加区分地套用到每一项 T2D 数值上。解读 log OR、方差组分和 liability-scale 结果时,要先确认它们出自哪一个模型。Methods,Within-family association analysis
身高与 T2D:有家内证据,但必须保留尺度和置信区间
研究的多重检验阈值为 :作者以 9 个祖源相关检验、9.43 个有效独立性状构造校正,而不是简单按 15 项性状逐个使用 0.05。
相对于欧洲祖源,IAM 的人群身高系数为 −1.98 SD,家内系数为 −1.51 SD,95% CI −2.03 至 −1.00,。这些系数按祖源比例增加 1,即 100 个百分点报告;数据中的典型家内祖源差异只有约 2 个百分点,不能把 −1.51 SD 描述成普通同胞之间的平均身高差。
T2D 的人群 log OR 为 1.73,家内 log OR 为 5.13,95% CI 2.48–7.78,。Figure 2 为便于阅读转成祖源增加 10 个百分点的 OR。家内点估计更大,但也具有更宽的不确定性;家内与额外家庭 T2D 系数的估计相关接近 −0.99,不能把两者视为独立证据。显著发现后的效应膨胀也值得警惕。
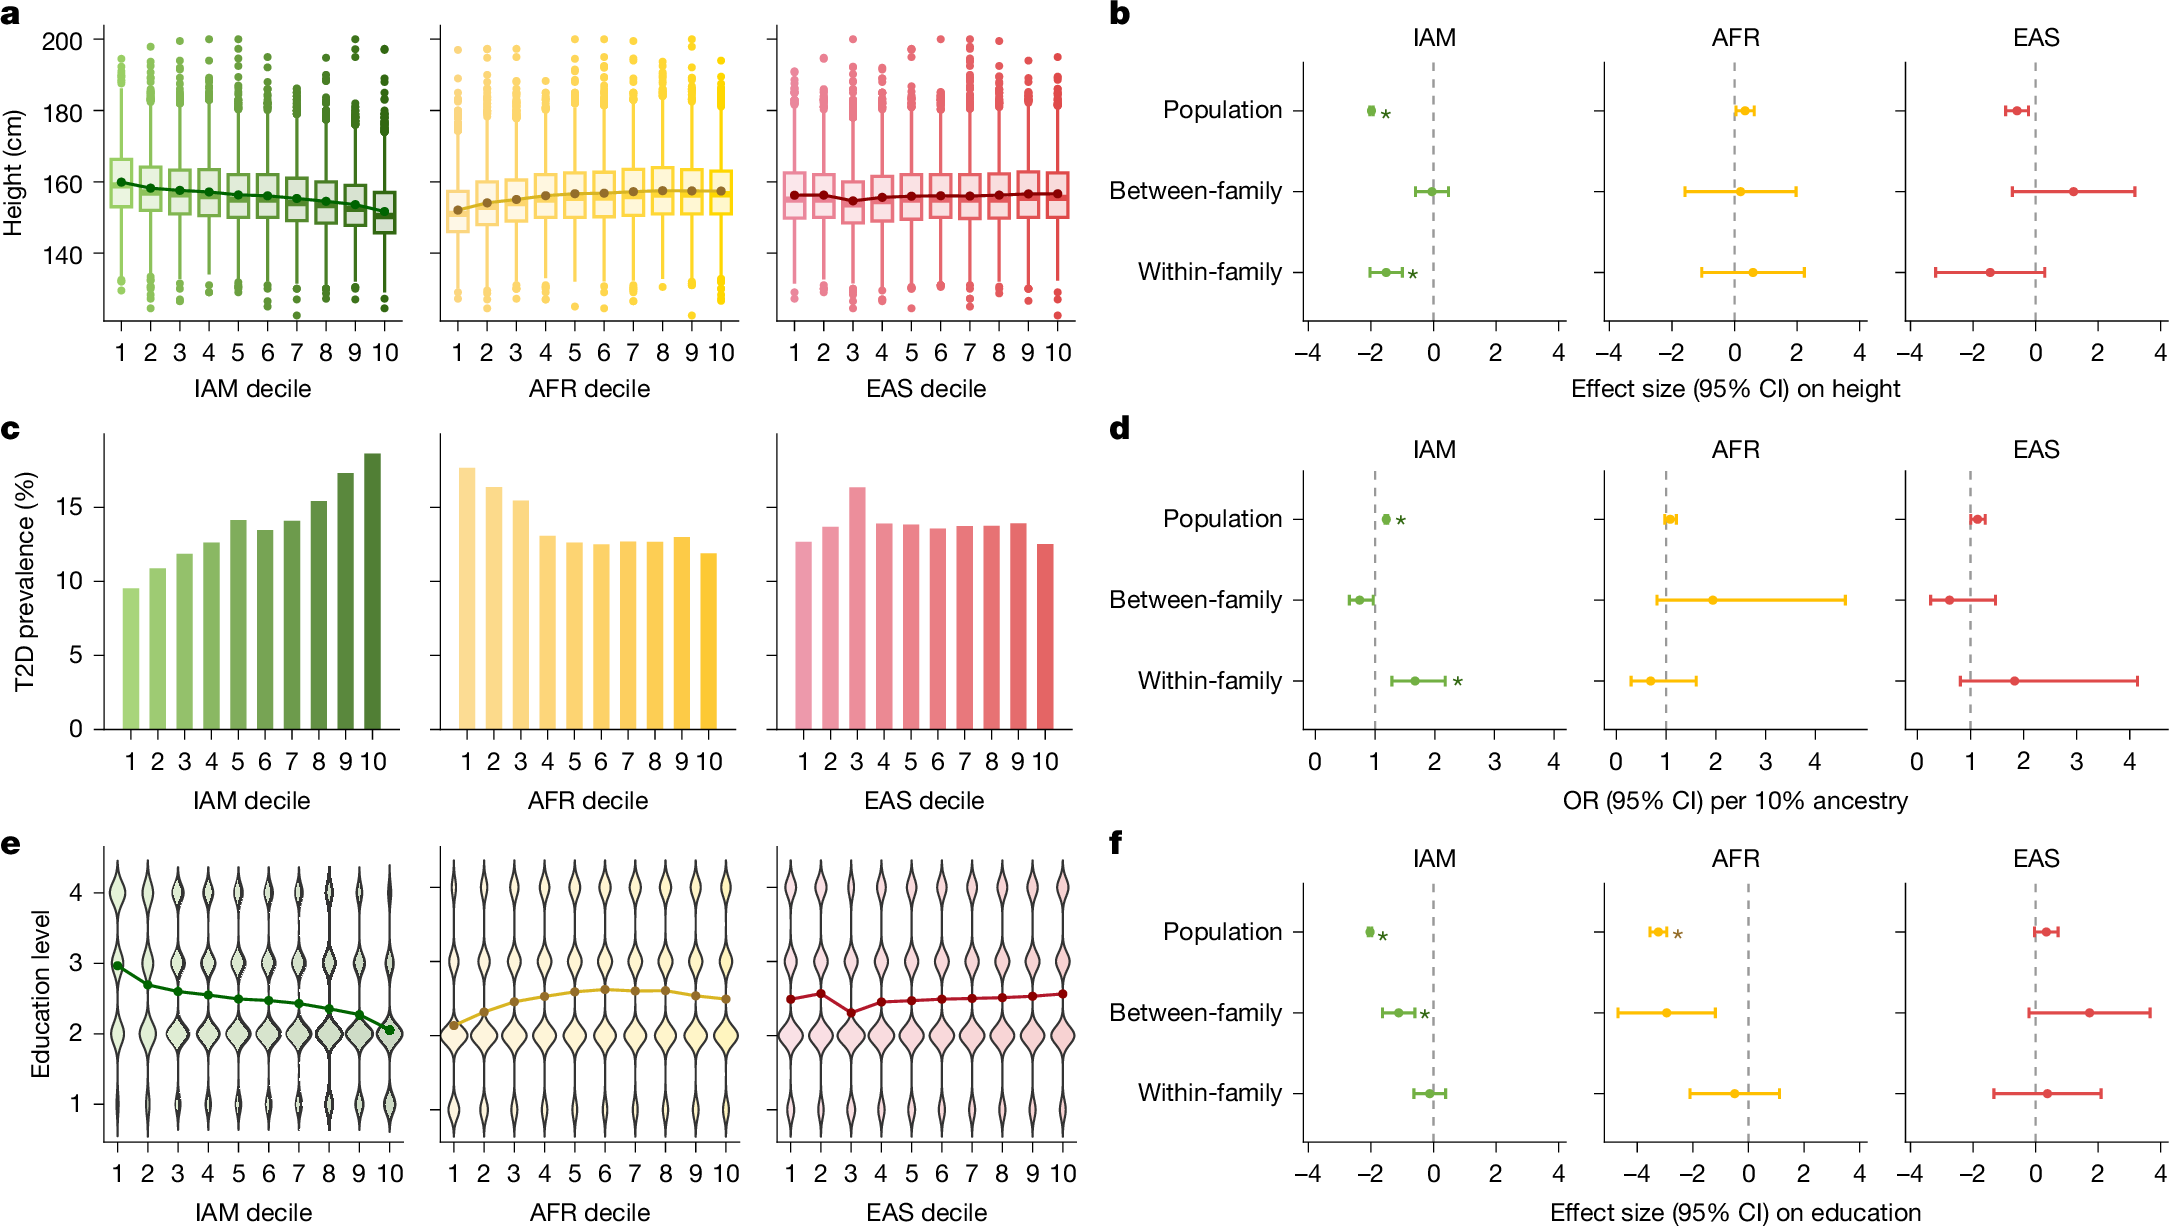
图中 T2D 的 OR 按祖源增加 10 个百分点展示;正文 log OR 5.13 则按比例增加 1 展示,不能直接将二者数值比较。定量性状与 T2D logistic 模型的随机效应设置不同。
Wang et al., Nature (2026), Figure 2. · CC BY 4.0 · 原图未修改 · 原文图 · 放大教育年限的 IAM 人群系数较大,但家内效应接近零且未显著,额外家庭系数为 −1.11、。这支持人群关联中存在家庭层面的环境或其他混杂成分,却不等于证明“教育没有遗传贡献”。对于其他未达到家内显著性的性状,较低功效同样限制了排除效应的能力。
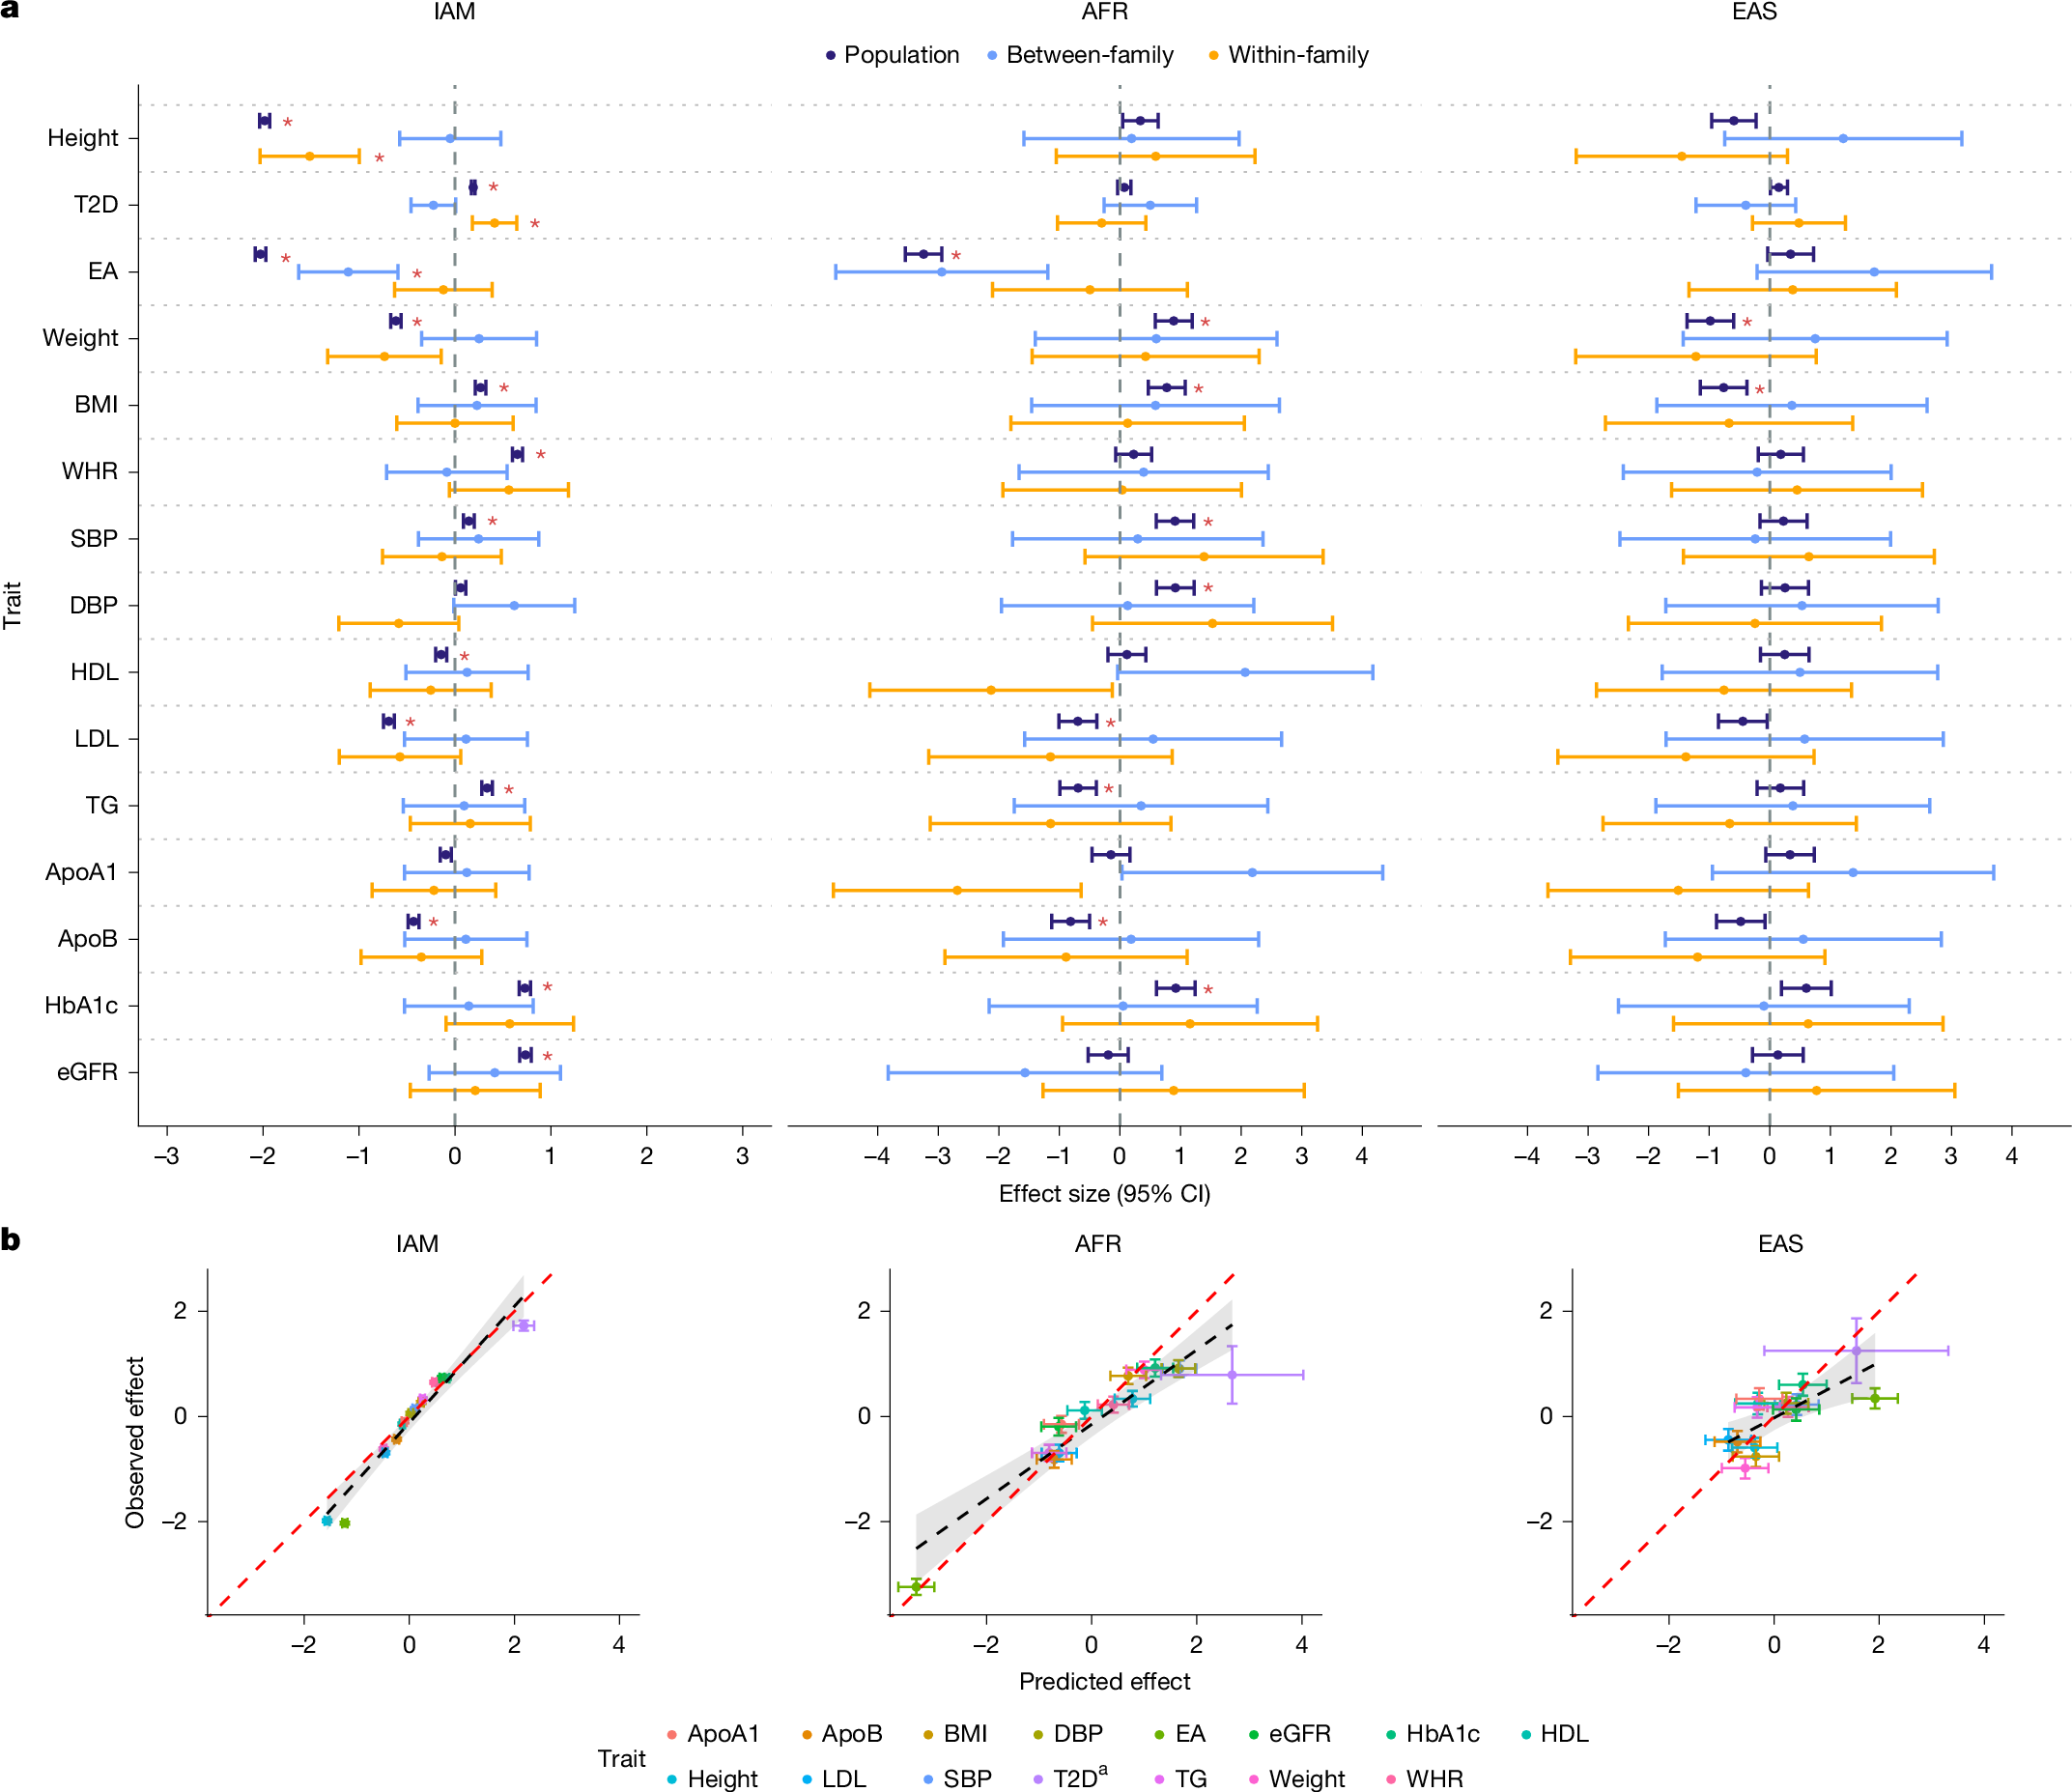
应同时比较效应与区间,而非只看是否显著。家内分离变异远少于家间差异,许多家内估计的不确定性明显较大;未显著不能直接证明该性状不存在遗传贡献。
Wang et al., Nature (2026), Figure 3. · CC BY 4.0 · 原图未修改 · 原文图 · 放大等位基因计数:支持部分遗传信号,不是已完成的中介分解
作者进一步计算 count of trait-increasing alleles(cTIA),即增加性状的等位基因计数。这里是不按 GWAS 效应大小加权的计数,不是常规加权 PRS。身高使用 12,111 个 COJO 信号,T2D 使用 1,289 个关联位点。
IAM 与身高 cTIA 的偏相关约为 −0.46,与 T2D cTIA 为 0.35。加入计数后,家内 IAM 身高系数从 −1.51 降至 −0.43,T2D log OR 从 5.13 降至 3.37。这说明已知性状相关位点能够解释一部分统计关联,与遗传贡献相容。
但这种协变量调整不是一项识别充分的因果中介分析。已发现的 GWAS 位点存在 LD 标记、发现人群和效应可迁移性等限制,且大部分信号来自欧洲祖源研究。只保留编码位点后,身高与 T2D 的位点数分别降为 314、36,尤其 T2D 的信息更有限。正文,Trait-increasing allele count 与 Figure 4
选择信号与社会环境中介各自能说明什么
作者比较 1,012 名 IAM 祖源超过 99.5% 的 MCPS 参与者与 348,658 名欧洲祖源 UKB 参与者的性状增加等位基因频率,并用匹配 MAF、LD 等特征的变异构造比较。身高相关检验为 ;T2D 为 ,Results 对 T2D 的选择解释明确保留了不确定性。不能将二者概括为同等强度、已确定发生于某个时间地点的自然选择证据。
更重要的是,家内随机遗传分离消除了许多家庭层面的祖源–环境相关,却不自动排除 继承的遗传特征通过社会待遇等环境途径影响表型。例如祖源相关外观可能引起不同社会反应;这种途径仍可在家内存在。作者也明确指出,家内效应不必等于不经过环境的纯生物机制。调整教育年限后结果相近,只能排除这一特定代理变量能解释的部分,不能据此排除所有社会途径。Discussion
对统计遗传学分析的启发
本文最有价值的部分,是把人群关联、家内分离与额外家庭效应放在可比较但不同的模型中,并公开讨论精度与解释限制。复用设计时应先明确家庭均值的构造、祖源参照类别、亲缘协方差和性状链接函数,再讨论系数差异,而不是只把家内显著结果叫作“真正遗传效应”。
结果也以当前队列中提供家内祖源变异的家庭为主要信息来源。这些家庭不必代表所有混合祖源人群,更不能把估计出的连续祖源系数机械外推为未混合人群之间的差异。
阅读范围与来源
本篇按 2026-09-09 在线发表信息收录。已阅读正文和核心 Methods,补读 Supplementary Note 1 的参数化及测量误差推导,核对 Figure 2–3;未逐项重算独立补充表、功效模拟和所有敏感性分析。复现入口见作者代码仓库。