AlphaGenome Atlas:AVI 评分与非编码稀有变异集合检验
AlphaGenome Atlas: in silico mutagenesis of the entire human genome improves prioritization and interpretation of non-coding variants
预计算约 90 亿个 SNV 与超过 1 亿个已观察到的 indel 的分子效应,再以群体频率构造代理标签,整合为 AVI。重点是功能注释如何改变稀有变异集合检验:UKB 蛋白分析中,加入 Atlas 注释后条件独立的非编码集合发现由 595 增至 728;这一收益并非 AVI 单独带来,且分析使用较早内部版本。
本文目录
研究问题:从分子轨道预测走向可检验的遗传关联
AlphaGenome 给出的是变异对多种分子测量的预测影响,而实际分析往往需要两个更直接的对象:一个用于排序候选变异的综合分数,以及一组适合共同检验的稀有变异。Atlas 同时处理这两个问题:先把全基因组预测预计算,再构建 AlphaGenome Variant Impact(AVI),并将 AVI 或单独的模态分数用于候选排序、罕见病解释和集合关联检验。原报告,正文 pp.1–18
这里要始终区分三层证据:模型认为某个变异可能改变分子功能;人群数据支持某个集合与表型关联;实验支持某个具体分子机制。三者可以相互补充,但不能互相替代。
预计算的对象与计算复用
资源覆盖 GRCh38 非 N 位置的约 90 亿个 SNV,以及来自 gnomAD、UKB、All of Us 等资源的 超过 1 亿个已观察到的 indel。后者不是所有可能的插入缺失。预测仍基于 AlphaGenome 的约 1 Mb 序列输入、11 类输出模态;每个变异平均对应约 27,000 个细粒度分数,包括 active-allele 类评分。
实现上将基因组分成不重叠的 128 bp 小块,一个小块最多有 384 个 SNV。参考序列前向计算与部分注释掩码在块内复用,而不是对每个 ALT 重算相同的 REF。相对于严格把变异置于窗口中心,这造成最多约 ±64 bp 的位置偏移;作者做了与常规居中评分的比较。indel 则额外使用移位增强与中间表示拼接,减少池化坐标改变造成的伪差异。Methods,pp.19–23
实际使用时必须保留 GRCh38 参考等位基因定义并规范化 indel。这里的 REF 并不等于主等位基因,不能为了让 ALT 成为 minor allele 而随意交换;非参考等位基因之间的替换也不在这套预计算的直接覆盖范围内。
AVI 如何训练:频率代理标签,而非临床诊断标签
AVI 的输入有 18 项:10 项汇总后的分子模态特征、AlphaMissense、3 项蛋白终止相关 VEP 指示变量、两种保守性特征,以及两项 indel 类型指示变量。多数模态先在相关组织、轨道或基因上取最大绝对效应;剪接类评分进一步合并。这样可以压缩高维预测,但也会丢掉组织、方向和具体靶基因信息。
训练标签来自 gnomAD v4.1 的 FAF95_GRPMAX,即祖源组间最大过滤频率的 95% 下界,而不是简单的总体样本 MAF。作者把 作为代理中性类,把 作为代理高影响类。稀有并不必然有害,因此这是利用群体选择信号进行的弱监督,不是直接学习临床致病概率。
为降低突变类别差异的影响,SNV 在 96 类链折叠三核苷酸替换类型内平衡两类样本;长度不超过 10 bp 的 indel 按长度平衡。使用 10 份重采样数据,训练染色体与验证染色体分离;测试还排除与训练或验证位置重叠的坐标,不能只排除同一个 REF/ALT。Methods,AVI 模型与数据划分,pp.23–26
模型不只是线性加权。用 表示主要注释、 表示 indel 类型,其 logit 可概括为
超网络根据当前输入产生部分权重和偏置,允许模态之间非线性交互;同时保留线性项与 indel 偏移。作者比较不同初始化、训练样本与结构,选择六个模型的 logit 均值 作为集成输出。模型选择使用 SGE / TraitGym 等验证任务,不能把这些验证任务再视为完全独立测试。
原始分数、PHRED 排名与 SHAP 不是同一种量
原始 AVI 是集成模型的 logit;展示用 PHRED 将全基因组排序变换到更直观的尺度,例如 10 对应前 10%、20 对应前 1%。这不是患病概率、外显率或统计 fine-mapping 的后验纳入概率。
作者使用以零输入为基线的 expected-gradients SHAP,解释哪些输入把原始模型输出从基线推高。按 Methods 的定义,归因相加对应 ,不是 PHRED 分数的可加分解。SHAP 中剪接贡献大,意味着模型的剪接特征对排序重要;它不证明剪接是该个体表型的唯一原因。要解释效应方向、组织和靶基因,必须返回对应的原始预测轨道。Methods,AVI interpretation
基准也不是所有类别都领先。例如正文报告 ClinVar 内含子 AUPRC 0.76,而 5′ UTR 为 0.26、略低于 GPN-Star (V) 的 0.27;TraitGym Mendelian 为 0.76,GPN-Star (M) 为 0.77。不同基准的阳性比例、候选空间和频率标签不同,不能把 AUPRC 差值当作跨任务通用提升。
DNM1:排序价值来自组织相关证据,而不只是一个高分
GREGoR 回顾分析中,在每个已解决病例的完整候选背景内,前 50 个候选召回率为 AVI 29.5%、CADD 12.5%。先加频率过滤后,相应数值变为 74.3% 与 61%;这两组数字的候选分母不同。
在对 814 个 trio probands 的分析中,作者重点研究 chr9:128225994:G>A:它在 MANE Select 注释中并不显眼,却位于 DNM1 脑相关外显子 10a 的上游内含子。AVI PHRED 24.7,剪接约占所述归因的 69%。预测的新受体位点使外显子产生 13 个氨基酸的框内延伸;该外显子在血液中缺乏表达,解释了为什么既往血液 RNA 测量可以没有明确异常。
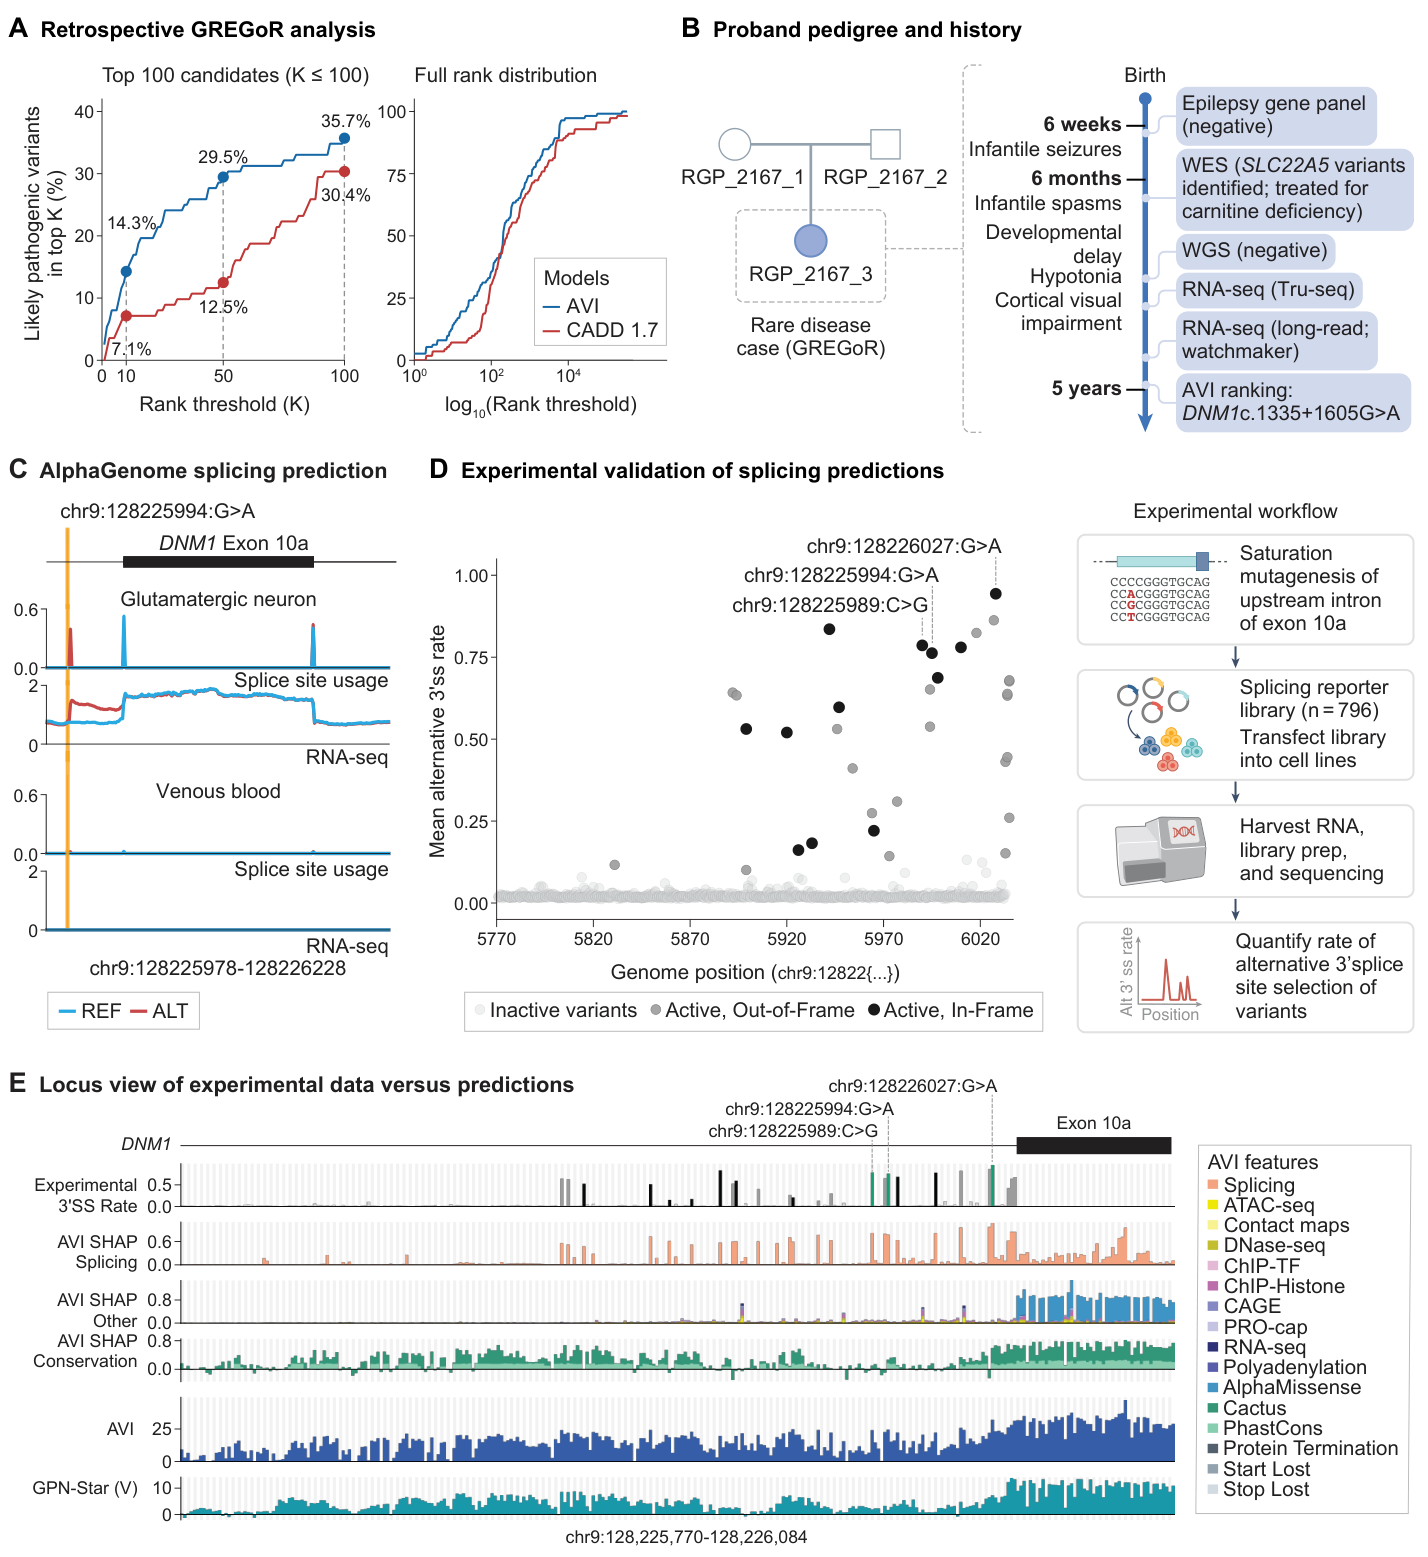
A 的召回率以每个已解决病例内的候选排序为单位;C 对比脑相关与静脉血预测;D–E 将上游内含子饱和突变实验与模态归因对照。组织中不表达该外显子,是血液 RNA 阴性结果不能排除异常的重要原因。
Cheng et al., AlphaGenome Atlas technical report (2026), Figure 3, PDF p.9. · 原报告未明确标示开放许可;保留作者版权与原始图内容 · 原图未修改 · 原文图 · 放大作者对上游 265 bp 做饱和突变,并在五种细胞系进行 minigene 检验,发现 12 个产生框内延伸的内含子变异。AVI 剪接归因与合并 AlphaGenome 剪接分数在这一实验的 AUPRC 为 0.943;SpliceAI 与 Pangolin 分别为 0.940、0.939。这里值得强调的是 SpliceAI 预计算库未覆盖该外显子,而不是 SpliceAI 模型本身在该实验完全失效。作者综合临床、预测和实验依据提出 Likely Pathogenic 分类,不能把这归因于 AVI 单独完成了诊断。正文 pp.7–9 与 Figure 3
UKB 蛋白分析:22% 来自注释扩展,不是 AVI 单项收益
实际分析包含最多 54,189 人、2,028 项满足覆盖要求的 Olink 蛋白。对蛋白编码基因及两侧 cis 区域内 MAF <0.1% 的变异,作者构建基于位置、既有功能注释、AVI 或单独 AlphaGenome 模态的集合。Atlas 分数按组织聚合后,用 UKB 染色体 2 上观察变异的分布确定前 1% 阈值,再与位置掩码相交。不是把同一个基因附近所有罕见变异直接求和。
检验包括 burden、SKAT、ACAT-V 和 ACAT-O:分别对应较一致方向的聚合效应、允许效应异质性的方差分量信号、单变异 P 值聚合及联合检验。原图把它们按作者讨论的遗传结构排序,但不存在脱离真实效应方向、稀疏程度和权重的普遍功效顺序。
显著性阈值为 ,来自 20 个随机正态表型的 WGS 模拟分析中的最小 P 值规则,而不是一个单纯的“0.05 除以集合数”公式。作者先调整已知 pQTL 与编码信号,再进行集合层面的逐步条件分析,最后额外加入单个低频/罕见变异信号进行敏感性分析。Methods,pp.40–43
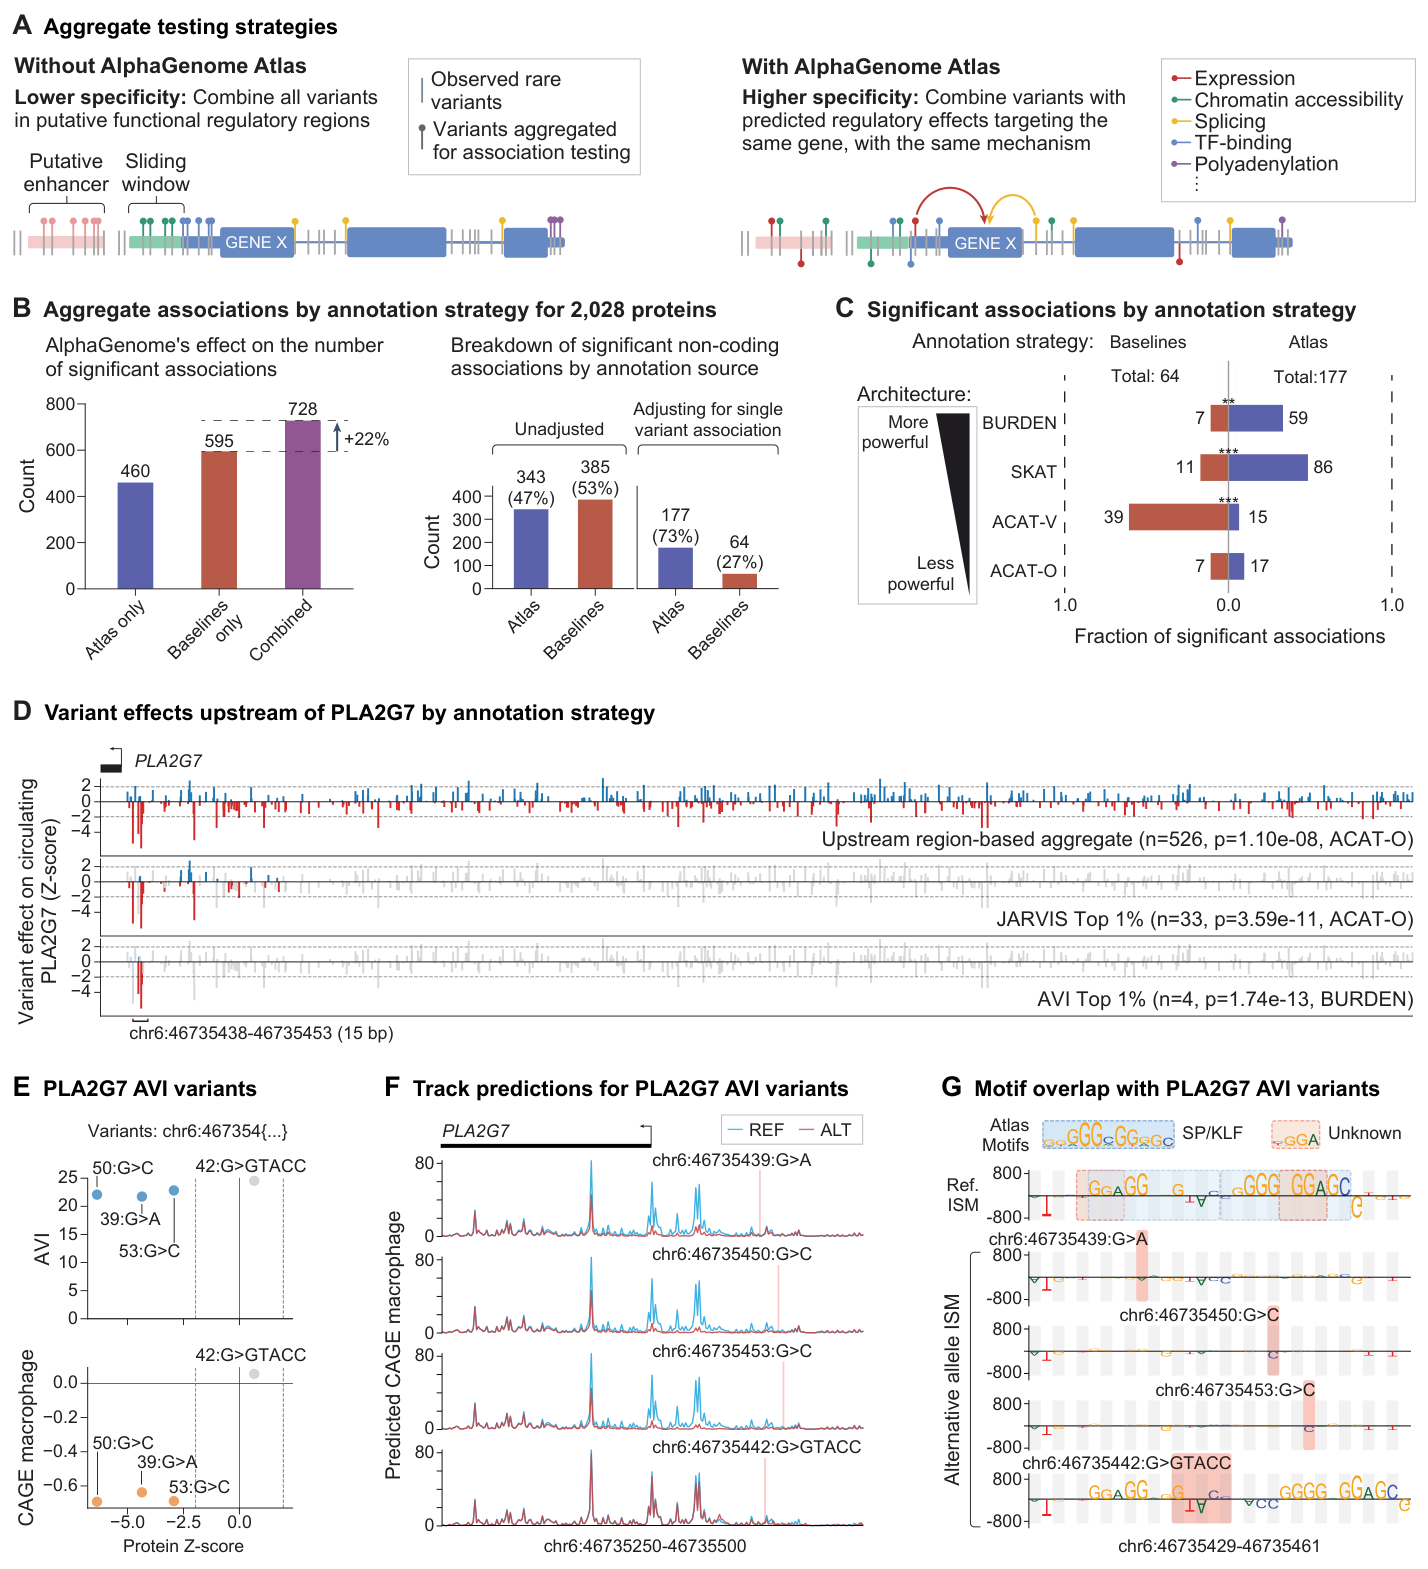
B 左侧是 baseline 595、合并注释 728;右侧进一步调整单变异后,Atlas 177、baseline 64。D–G 的 PLA2G7 示例说明集合的变异数与机制一致性如何影响检验,但 motif 与预测轨道并不等于该位点已获实验验证。
Cheng et al., AlphaGenome Atlas technical report (2026), Figure 4, PDF p.11. · 原报告未明确标示开放许可;保留作者版权与原始图内容 · 原图未修改 · 原文图 · 放大合并 baseline 与 Atlas 注释后,条件独立的非编码集合发现从 595 增至 728,约增加 22%。进一步调整单变异后保留 241 项,其中 177 项由 Atlas 注释定义,64 项来自 baseline。这里的 73% 是 177/241,不能写成 73% 的全基因组关联或所有蛋白获得改善。Atlas 发现中约 73% 来自模态特异集合,其余才是 AVI-only;因此 22% 不能全部记在 AVI 综合评分名下。
PLA2G7 提供一个具体例子:上游区域包含 526 个变异时,最低 ACAT-O P 值为 ,未过本研究阈值;JARVIS 前 1% 保留 33 个变异,P 值为 ;AVI 前 1% 留下集中于 15 bp 的 4 个变异,burden 效应为 −1.73 个蛋白标准差,。其中三个 SNV 与较低蛋白水平和较低巨噬细胞 CAGE 预测相符,但另一个插入变异未达到名义显著。SP/KLF motif 或 G-rich 结构解释仍是候选机制,本文未对这个位点完成对应功能验证。
版本、条件分析与复制的边界
UKB 展示的结果并非全部由最终公开 Atlas 重新生成。 补充说明指出,由于 UKB RAP 在 2026 年 4 月的访问问题,论文沿用较早内部版本。作者用 202 个集合做部分一致性检查,变异数量相关为 0.769、关联结果相关为 0.904;这支持相近但不等于完整的最终版本复现。
另一个需要保留的文字差异是:正文与 Figure 4 说明常见 pQTL 条件化时使用 MAF >1%,Methods 的初始 COJO 描述使用 >0.1%。实际复现应对照作者脚本和输出清单,不能在 notes 中自行选一个阈值把两处“统一”。
身高、BMI、HbA1c 的扩展分析使用 AlphaGenome 派生评分而不是 AVI。对 All of Us 的外部检验,31 个候选关联中 25 个具备足够变异可检验,仅 4 个达到名义 ,没有一个通过 Bonferroni。因此这部分只能说提供了有限的外部支持,不能宣传为广泛独立复制。Methods pp.42–43;Supplementary Note p.49
对功能注释辅助 fine-mapping 的启发
以下是研究延伸,不是本文已经完成的分析:可以把 AVI、分模态分数及其组织特异版本作为候选注释,学习先验权重,再在独立位点检验是否改善 credible set 的覆盖率、大小与 PIP 校准。需要避免用同一批高 PIP 变异同时训练注释权重和评估,且要与 MAF、LD、距离、既有保守性注释共同比较。
相比直接把 AVI 映射为 PIP,更值得复用的是论文中的 集合设计 → 统计检验 → 单变异条件化 → 外部/功能验证 的证据链。高综合分数提供的是优先检查的理由,不是免除遗传统计校准的理由。
阅读范围与来源
本 notes 属于 2026-09-09 期,论文实际公开于 2026-09-08。已阅读公开 PDF 正文与核心 Methods,核对 Figure 3–4、集合分析和版本说明;未逐项重新分析全部补充表,也未重跑受控人群数据。文中数值均按本次公开报告版本记录。