CellDot:分子归属、容量约束与空间去污染
Accurate and scalable decontamination of imaging-based spatial transcriptomics via optimal transport
把空间RNA污染建模为分子在宿主、邻近细胞和背景之间的归属问题,以参考表达、空间距离和两类容量约束求解稀疏熵正则最优传输。重点区分正文硬约束形式与实际软容量求解、连续计划与离散解码,以及参考一致性与独立验证。
本文目录
研究问题是分子的归属,而不是矩阵变得更干净
CellDot 针对成像型空间转录组:RNA 分子的基因身份和坐标已经观测到,但细胞分割、信号外溢和三维细胞重叠可能把它们计入错误细胞。它不重新检测 RNA,也不重新分割细胞,而是在上游分割和细胞类型注释之后,为纳入分析的分子选择 保留于宿主、转移到邻近细胞、作为背景移除。
关键区别在于污染不必全部删除。把一个误计入 B 细胞的 T 细胞转录本重新归到邻近 T 细胞,同时降低错误的 B 细胞表达并补回 T 细胞的表达;计数矩阵删除法通常只能完成前半步。但这种归属仍由模型判断,轨迹可追踪不等于每条轨迹的生物学来源已经被验证。 本文为 2026 年 9 月 15 日公开的 v1 预印本,尚未同行评审。原文
哪些分子真正进入模型
令 为 ST 与单细胞参考的共享基因集合, 为通过质控且已分配给有类型标签宿主的分子, 和 分别为其基因和原宿主。细胞 有面积 、标签 和共享基因上的原始 library size 。输入还包括分子坐标、分割边界和带标签的单细胞参考。
原本未分配给细胞的 extracellular transcripts 用于估计背景,本版方法并不把它们重新分配给细胞。 因而“对每个分子输出记录”与“对全部检测分子进行归属优化”是两回事。无标签细胞、非共享基因、低质量分子也不能默认为被完整校正。原文最大数据的 1.24 billion 检测分子中,880.8 million 进入求解器。
细胞类型注释在校正前完成:scANVI 在参考和空间数据上训练,所有需要标签的方法接收同一组标签。参考最好与患者匹配,但不是必需:肺癌使用公共 LuCA atlas;宫颈癌参考另加入 LuCA 的 neutrophil profile,以弥补解离数据的缺失。来源:Methods 的 Notation、Cell-type annotation 和 Data availability,PDF pp.18、21、25。
参考表达、平台校准与背景的两种尺度
参考中的每个细胞先归一化为共享基因上的组成,再按类型求均值,得到 ,每行和为 1。它表示“来自类型 的一个转录本属于基因 ”的概率,不是“基因 的分子来自类型 ”的后验概率;也不同于直接汇总所有参考计数的测序深度加权 pseudobulk。
作者以空间 pseudobulk 的观测量与参考期望之比估计基因特异的 。公开 prep.py 的实现可表示为
是已分配分子的基因总数;观测或期望不足 50 时,默认 。这些因子只用于模型先验和容量,不直接将输出计数乘以一个校正系数。它能吸收总体检测效率差异,却没有学习类型×基因的独立平台效应;真实患者状态差异与平台差异也未必能够仅凭这一比值区分。先验预处理代码
背景需要两个量。令 为未分配背景中基因 的分子数, 为组织内细胞外面积:
前者是背景的基因组成,决定某类分子送往背景的相对成本;后者单位为 molecules/µm²,决定能移除多少。紧密分割边界之外也可能有真实胞质分子,因此在适用的分割输出上,先排除距边界 3 µm 内的未分配分子。若组织几乎没有细胞外区域,或者分割系统性错误,背景组成与密度都可能有偏。来源:原文 Eqs.1–4、background_params 与 dilated_background。
稀疏候选图与分子分配成本
每个分子最多考虑质心距离 15 µm 内的 14 个最近细胞,加一个背景选项。对候选细胞 ,代价为
模型先以质心距离限定候选,再以等面积圆盘近似细胞,计算非负的分子到圆盘表面的距离 。这两个距离的用途不同,也不意味着默认精确使用细胞真实多边形计算运输成本。 原宿主通常在候选集合内,但不是无需条件的全局候选。
负对数表达项偏向参考中表达该基因的类型,距离项偏向近处细胞。对两个参考表达相似的同类型邻居,表达项区分能力很弱,几何结构和容量承担更多决策。远于候选半径的真实来源不在搜索空间内;更强优化也无法恢复被候选构建排除的解。
两类容量为什么不能合并
表达容量限制一个接收细胞最终保留或接收多少某基因的质量;背景容量限制一个原宿主可向背景输出多少。作者定义
默认 、; 从原始空间计数的类型内方差/均值估计,并截断到 。离散程度较高的基因获得更宽容量,避免把所有同类型细胞拉回参考均值。另一方面,参考表达近零时,容量也近零,真实但参考缺失的疾病诱导表达因此是重要压力测试场景。
这是 dispersion-aware 的设计上界,不是经覆盖率校准的 95% 预测区间。使用 Fano factor 或代码中的“NB band”命名,也不意味着作者对每个细胞拟合了一个完整负二项计数似然。原始污染本身还可能影响 和 ;从数据估计参数不等于参数没有不确定性。
令 为分子 分配给细胞 的连续质量, 为背景质量。原文 Eq.5 写为
并有三组约束:
第二项汇总所有以 为候选的分子,包括来自其他宿主的输入;第三项只汇总原宿主为 的分子。两者都不是必须填满的目标。去掉这些耦合约束,问题趋向逐分子独立分类;容量使多个分子必须竞争有限的接收和删除额度。
从凸优化公式到实际算法:软容量与离散解码
Eq.5 把两类容量均写为硬不等式,但紧随其后的方法文字明确说表达容量实际按软约束处理,背景容量按硬约束处理。 公开 engine.py 和 config.py 也支持这一区别。因此不能把最终软件输出直接描述为“精确满足 Eq.5 全部硬约束的唯一解”。
实现使用稀疏 Sinkhorn-type 迭代。记运输核 ,默认 ,通过行缩放 、接收端缩放 和背景缩放 得到连续计划。简化记号下,代码的核心更新为
第一式中的变量是行缩放 。默认循环 200 次。原生表达列使用 0.3 的幂进行软容量缩放,背景列默认幂为 1;scatter_add 汇总稀疏的细胞–基因键,避免建立“全部分子×全部细胞”的稠密矩阵。以上描述的是核读时的默认实现,不是新推导出的精确收敛保证。求解代码、默认参数
连续计划仍不是最终分子归属。若每个细胞–基因允许删除的质量不足 1,单独做 argmax 会把分散的小背景质量全部舍弃。默认流程进一步用 半径 100 µm 的滑动背景窗口汇总额度,按参考表达区分可表达类型与其他类型的共享池,再结合背景偏好对候选分子排序并离散化。当前默认 BG_DEMAND='mass',局部需求按背景责任权重求和,而不只是分子个数。
应分别评价连续计划残差、硬解码后的删除量和跨 tile 一致性。严格凸性在代价固定、可行域非空时能支持理想连续问题的唯一性;它不意味着最终离散分配必然满足逐细胞的所有硬上界,更不意味着存在唯一可识别的生物学归属。运输质量不是已校准的来源后验概率。
扩展性来自局部化,但全流程不是恒定内存
组织按 500 µm tile、15 µm halo处理;halo 分子参与优化,只记录 tile core 分子的最终结果,避免重复输出。同一基因仅在有限候选间竞争,是主要的复杂度削减。若候选数 、迭代次数 和局部密度保持可控,核心缩放计算近似随 增长;候选搜索、键排序、滑窗解码和 I/O 仍有额外成本。
halo 减少局部边界截断,不自动证明独立 tile 的解与一个整切片联合优化完全一致。虽然单 tile 求解张量的大小有界,原始数据读取、索引、输出及背景处理仍可能随切片增长,故不能把“tile 内存有界”写成全程序 内存。
| 数据 | 原始面板与报告的分析规模 | 参考与证据类型 |
|---|---|---|
| 乳腺癌 Xenium | 发布数据167,780细胞、313基因;Figure 2基准161,909细胞 | 配对单细胞FFPE参考;标签和marker质量指标 |
| 结直肠癌 Xenium | 340,837细胞、422基因面板;407共享基因、40.8百万分子 | 同一标本Flex参考及相邻Visium HD/Visium切片 |
| 肺腺癌 Xenium 5K | 278,328细胞、5,001基因面板;4,598共享基因、121.0百万分子 | 公共LuCA参考;几何与通讯分析 |
| 宫颈癌 Atera | 717,576细胞、18,028基因面板;17,285共享基因、880.8百万分子 | 配对scFFPE参考及补充neutrophil类型;全转录组校正 |
原始面板、共享基因、发布细胞数和基准细胞数不能混报。四张肿瘤切片覆盖不同组织与平台规模,但不是同一种肿瘤中的大量独立 donor 复制。
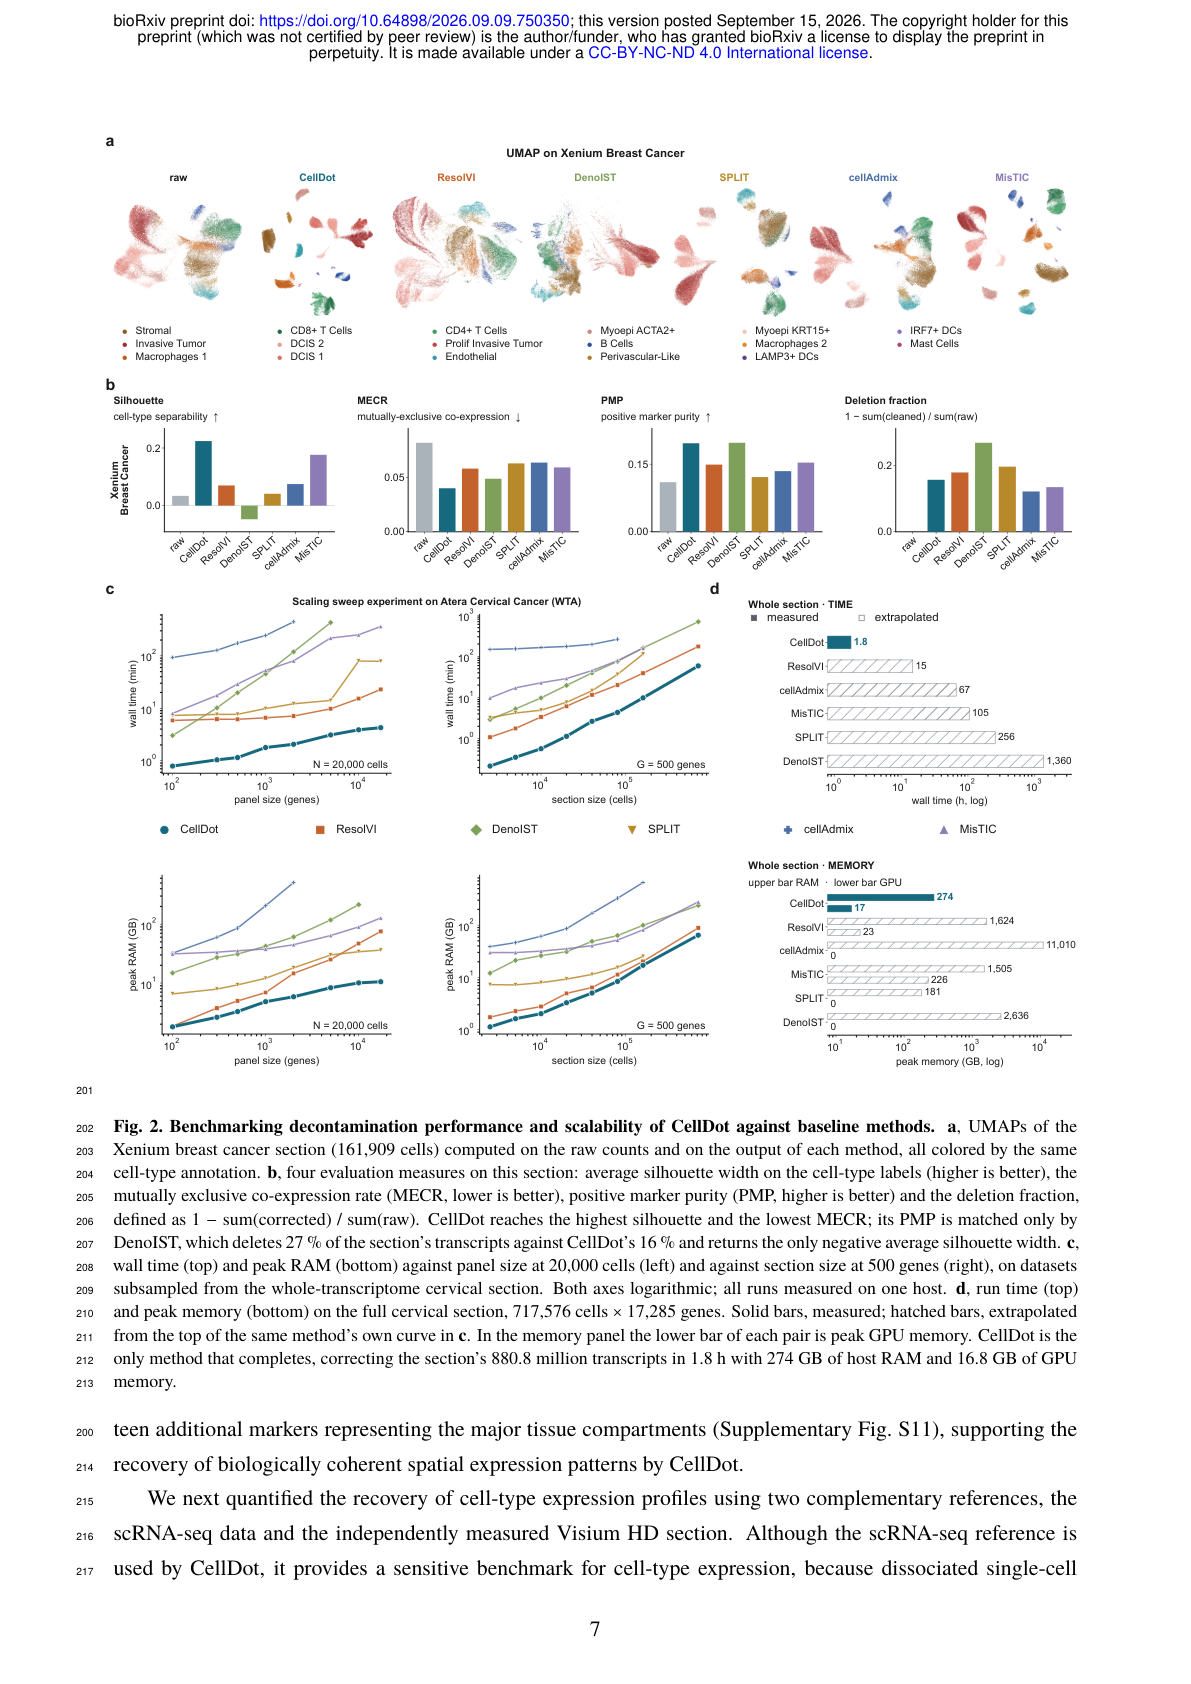
原文完整第7页。实心条是实测,斜线条是按子集拟合的全切片外推;不能把后者当作实际跑完的耗时。乳腺癌基准图使用161,909细胞,区别于原始数据发布规模。
Chen et al., bioRxiv v1, Figure 2所在完整第7页;无裁剪、改色、重绘或面板重组。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大最大切片的实测为 1.8 h、274 GB host RAM、16.8 GB GPU memory。Methods 描述同一服务器具有两颗22核CPU、754 GB内存和 Tesla V100 16 GB GPU。内存单位口径需区分,不能据显示数值直接判断显存不足;主机内存需求也说明这不是普通笔记本规模的分析。
Figure 2d 中其他方法的大部分全切片耗时/内存为斜线外推条。 作者由嵌套细胞和基因子集分别拟合扩展曲线,预计超过12 h的运行不实际执行。因此“CellDot 是所比较方法中唯一完成全切片的实现”可以报告,不能改写成“其他五个方法都实际运行到崩溃”,也不能用1,360/1.8当作实测加速比。子集上作者报告较最快竞品约3–6倍的速度优势,仍限定于其硬件、参数与输入。
校正评价:参考一致性不能冒充独立真值
CellDot 与 resolVI、MisTIC、DenoIST、SPLIT、cellAdmix 比较。所有需要标签的基线接受同一标签,无法处理的低计数细胞保留原始计数;有方法不依赖参考,信息输入并不完全相同。MisTIC 的 removal mode 使用 best,并非关闭删除的 conservative 默认模式;resolVI 使用25次 posterior samples 的逐元素中位数,这种输出与逐分子整数归属也不完全相同。
乳腺癌中 ASW 从 0.034到0.224,CellDot 的 MECR 较低;DenoIST 的高 marker purity 同时伴随约27%分子删除,而 CellDot 约16%。肺癌中 resolVI 的 MECR/PMP 优于 CellDot,但删除约54%分子、每细胞检测基因中位数从198降至30;CellDot 删除约6%,保留182个。删除率是诊断量,不是越低越好的评分;高marker purity也不独立证明去污染正确。
ASW 在固定的 raw-derived 评价空间及共享标签上计算,减少方法分别重嵌入的自由度。MECR/PMP 的marker从参考提取,避免直接从待评价空间层选择marker。但同一参考参与注释、成本和评价,向参考类型收缩本身即可改善指标。这里验证了参考一致性和部分结构保留,尚不是逐分子真实归属正确率。来源:Methods 的 Benchmarking analysis、Evaluation metrics,PDF pp.21–23。
结直肠癌:Visium HD 提供更独立的测量支持
校正后的 ACTA2 由弥散肿瘤区域回到平滑肌和血管结构,与相邻 Visium HD/Visium 切片更一致。这比与同一scRNA参考更相似的 UMAP 提供了更独立的证据,但各平台没有测量相同的一组细胞或同一个RNA分子。
评价先将细胞/bin归一化,按细胞类型求均值,再使每个基因在不同类型间的表达份额和为1;随后对每一类型跨基因计算 Pearson correlation。符合细胞/bin/参考数量要求的23类参与评分,置信区间按基因 bootstrap,而非独立患者 bootstrap。
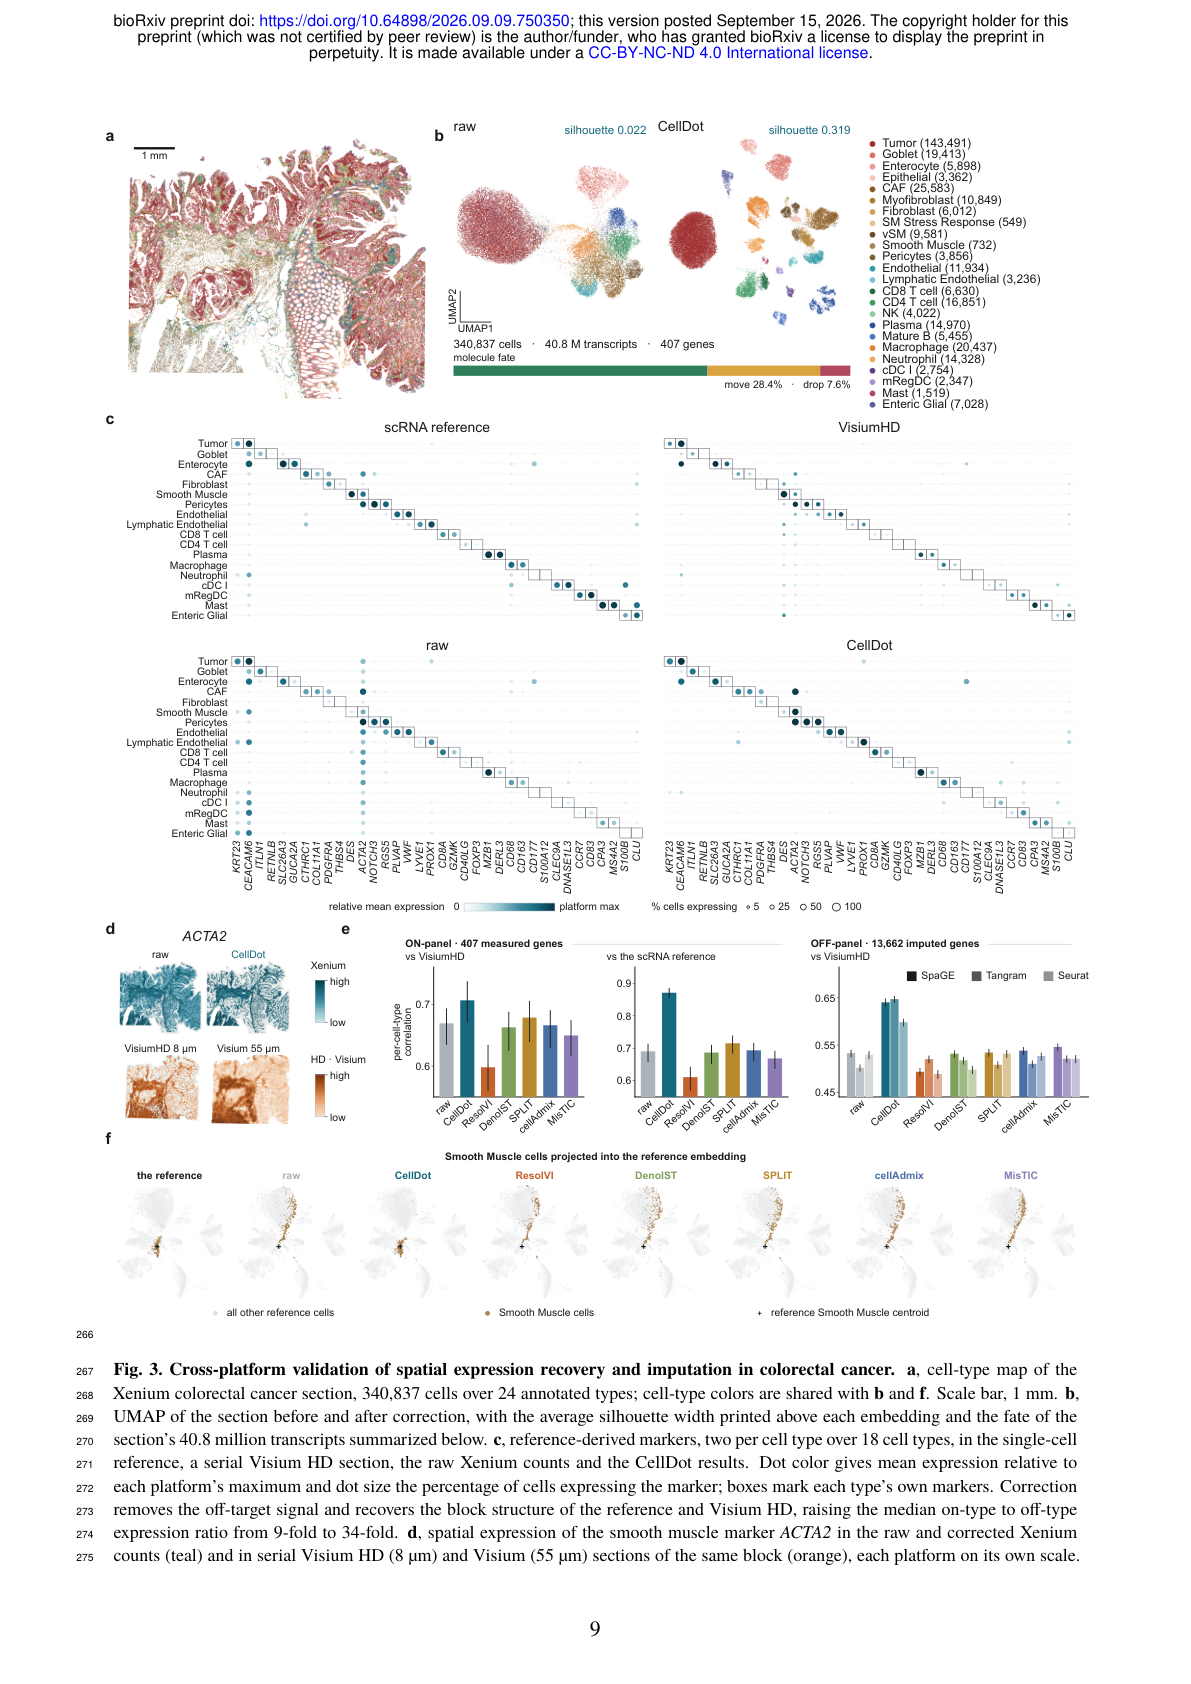
原文完整第9页,续图注见PDF第10页。细胞类型汇总表达的一致性不是逐分子归属正确率;同一scRNA参考参与校正和部分评价,Visium HD提供更独立的测量支持。
Chen et al., bioRxiv v1, Figure 3所在完整第9页;原页内容保留。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大与scRNA参考的平均相关由 0.691到0.871;与独立Visium HD由 0.669到0.706,23类中11类有改善。独立验证的增益较小,但更能限制“只是被拉回参考”的解释。这是类型汇总表达份额的一致性,不能解释为绝对表达恢复率、单细胞表达误差或归属准确率。
进一步用 SpaGE、Tangram、Seurat 推断 13,662个off-panel基因,再按同样的类型表达指标对照Visium HD,相关由约0.50–0.53升至0.60–0.65。插补结果由下游参考迁移方法产生,不是CellDot在原始空间数据中观测或创造了这些分子。
状态、通讯与邻域程序的证据边界
结直肠癌巨噬细胞 raw 数据中的 GREM1/PIGR 亚群邻近表达这些基因的其他细胞类型,校正后消失,保留 C1Q/CD163、MMP12/interferon 和 SPP1–APOE 等程序。这支持污染可制造伪状态,但“参考中巨噬细胞不表达”本身不能在所有疾病情境下排除新状态或真实吞噬相关RNA。
肺癌中保留分子更常与细胞核重叠;91%重分配分子位于朝向目标细胞的一侧。核定位提供未直接用于成本的补充结构证据,不过候选和代价本来包含空间邻近,方向性验证并非完全独立于模型几何假设。它没有识别每个分子的真实来源。
CellPhoneDB、CellChat 和 LIANA 的 precision/recall,是相对于相同参考上推断出的通讯边集合,且区分 ligand–receptor pair 与加入sender/receiver的edge。CXCL12/CXCR4和CXCL13/CXCR5的例子说明错配会改变发信细胞,但多个表达型通讯工具一致不等于验证配体分泌、受体激活或因果细胞通讯。
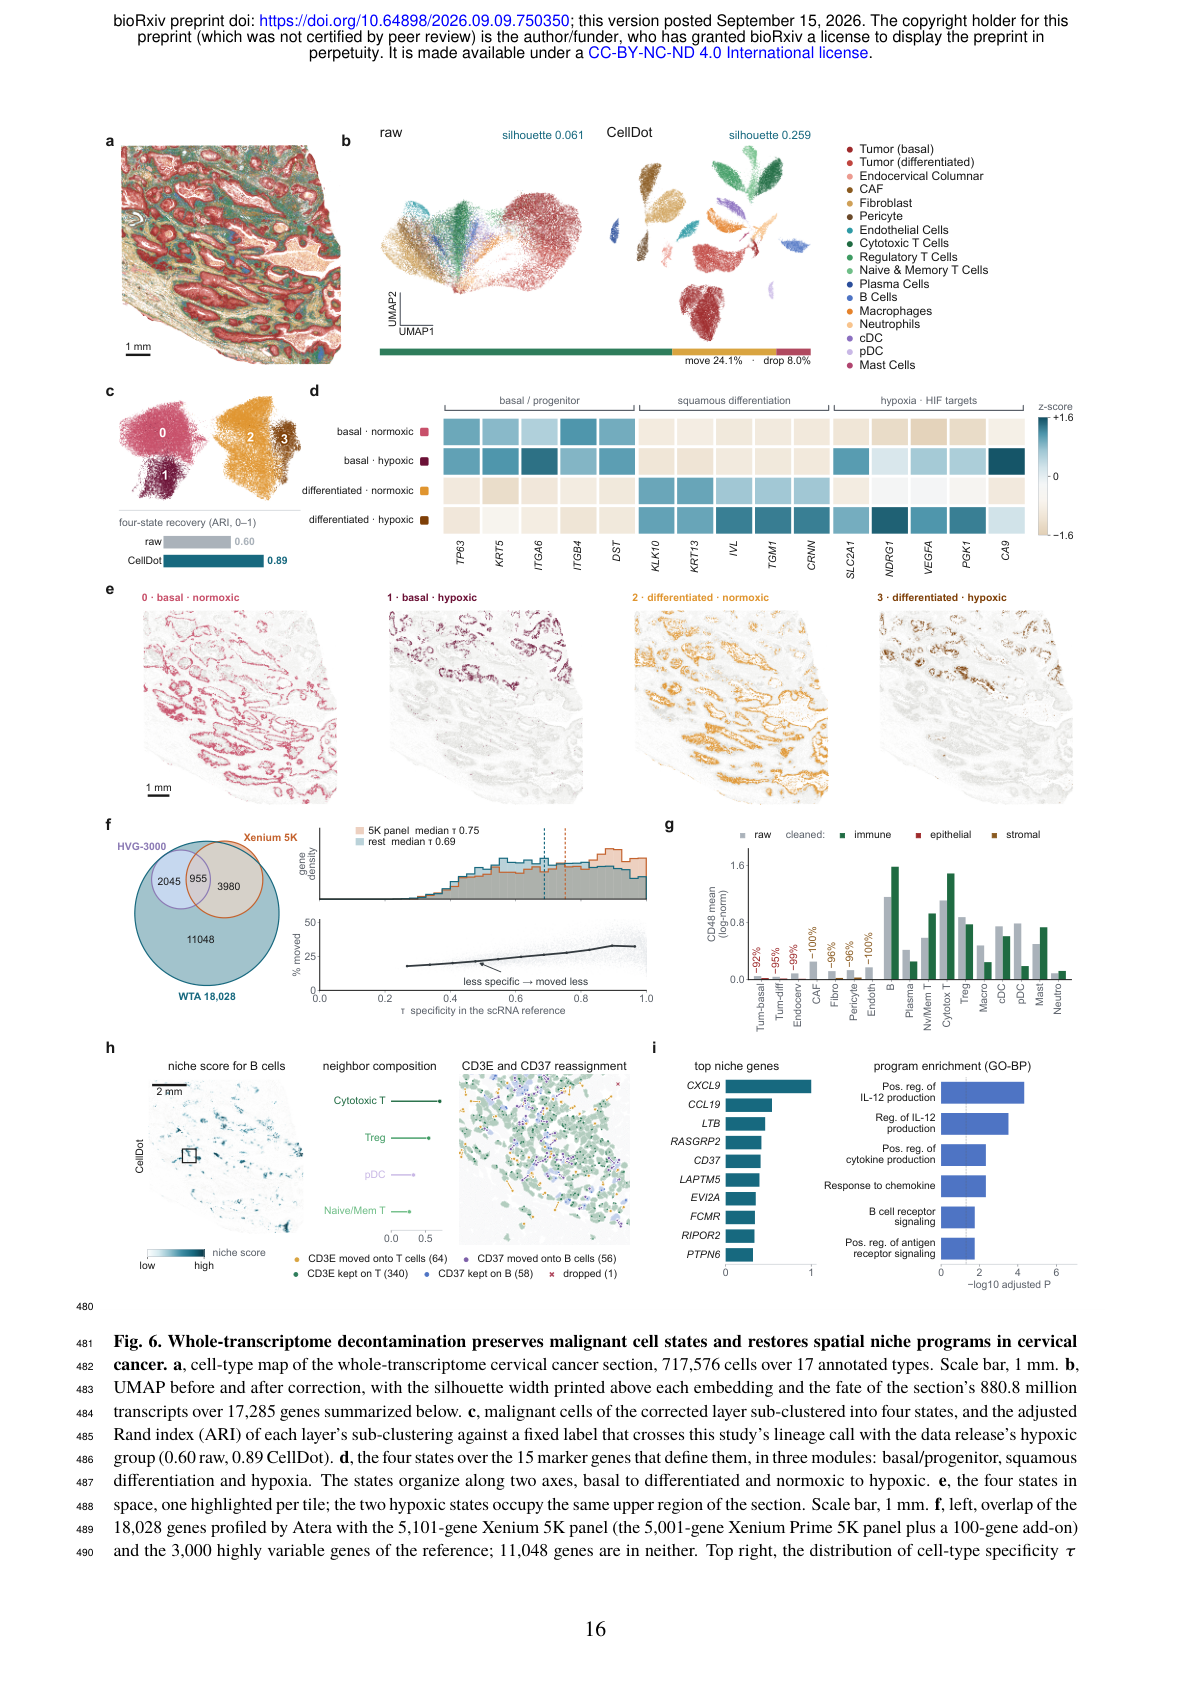
原文完整第16页,续图注见PDF第17页。四状态ARI和B细胞邻域程序支持特定场景中的保真;不能据此认定未知状态或所有邻域相关表达均已得到正确校正。
Chen et al., bioRxiv v1, Figure 6所在完整第16页;原页内容保留。 · CC BY-NC-ND 4.0 · 原图未修改 · 原文图 · 放大宫颈癌恶性细胞按基底/分化、常氧/缺氧形成四状态,ARI从 0.60到0.89。评价标签结合数据发布的缺氧注释和本研究谱系判定,支持这个案例中的状态保留,并非外部盲法真值。B细胞的T细胞邻域在校正前后空间位置仍在,但NicheScope程序由T细胞基因转向B细胞与白细胞程序,说明分子错配可污染邻域效应分析。
同样需要避免反向过度解释:真正的微环境诱导表达也可与邻居组成相关。参考过强时,去掉邻居marker并使通路更符合传统类型,不足以证明保留了全部真实niche response。来源:原文Figures 4–6、Methods的通讯与Spatial niche analysis。
对空间遗传效应与算法研究的启示
校正是会影响下游推断的估计步骤。 同一分子从一类细胞转到另一类,会在两个表达表型间制造依赖;同一donor的细胞类型、污染程度、分割质量若与基因型或疾病状态相关,校正前后QTL差异不一定意味着真实调控更强。输出可追踪为审计提供条件,但不会自动传递归属不确定性。
可检验的方案是以donor为独立单元,比较raw、校正后pseudobulk和对高不确定归属作敏感性处理的结果,评估零假设错误率、效应偏差与区间覆盖,而不只是eGene数或聚类分离度。连续运输计划只能先作为敏感性权重,未经校准不应直接当作真实后验做多重插补。
模拟应同时保留真实状态与人为错配。 在已知来源分子的生成数据中独立改变分割误差、背景密度、参考缺失类型、同类型连续状态、真实跨类型共表达与donor遗传效应。尤其加入“参考为零、疾病状态实际诱导表达”的基因,检验算法是否把真实信号强制移走;在无污染情景中检查是否仍大幅改变表型。
计算优化则应同时检查固定候选图上的连续残差、离散解码后的质量守恒、不同tile原点和大小的一致性,以及端到端I/O与峰值RAM。稀疏局部运输和容量设计值得借鉴,但不是把任何空间校正或QTL计算搬上GPU都会获得同样收益。以上是研究建议,不是作者已完成的遗传关联验证。
总体评价、材料范围与复现入口
CellDot 的实质贡献,是把参考和空间信息放进受容量约束的分子分配框架,并在接近九亿个输入分子的规模上实现可追踪校正。相邻Visium HD、亚细胞几何和状态/通讯应用比单一UMAP更有说服力。最需要进一步核验的是参考缺失状态时的保真、硬约束公式与实际软容量/离散流程的关系,以及完整校正流程的统计校准。
本次核读用户上传的29页v1正文、Methods和主图,并检查公开 prep.py、config.py、engine.py、run.py。独立Supplementary Notes/Tables未成功取得;已尝试补充文件入口但返回错误,故没有声称审阅全部消融实验、补图或证明。未重跑大规模真实数据,也未把可访问代码等同于结果复现。