CIGMA:量化跨细胞类型共享与特异的 eQTL 架构
Cell-type-specific eQTLs underlie the genetic architecture of complex traits
CIGMA 用方差组分模型估计一个基因的 cis 或 trans 调控效应中,跨细胞类型共享部分与细胞类型特异部分各占多少,从而避免只依据显著 eQTL 数量推断调控特异性。
本文目录
研究问题
常见的单细胞 eQTL 研究以显著 SNP–gene 配对为单位比较不同细胞类型。这个做法有一个结构性问题:共享效应通常更容易被检出,而弱的、细胞类型特异的效应需要更大样本量。因此,“显著 eQTL 中有多少是细胞类型特异的”会同时受到真实遗传架构和统计功效影响。
CIGMA 不逐个判定 SNP 是否显著,而是估计一个基因附近一组变异共同解释的表达变异,并把它拆成共享与细胞类型特异两部分。
模型
对个体 、细胞类型 的某个基因,作者使用细胞类型 pseudobulk 表达 :
其中:
- 是个体 在变异 上的基因型;
- 是跨细胞类型共享的遗传效应;
- 是变异 在细胞类型 中额外的效应;
- 表示个体层面的非遗传变异及未建模遗传成分;
- 表示有限细胞数、实验噪声和细胞状态差异带来的 pseudobulk 测量变异。
随机效应方差写为
表示共享遗传方差, 表示细胞类型 的特异遗传方差。作者用
概括一个基因的 eQTL 细胞类型特异性。 接近 0 表示调控效应主要共享; 较高表示不同细胞类型中的遗传效应差异较大。
为什么要校正细胞内变异
不同个体、不同细胞类型的细胞数并不相同。pseudobulk 均值的测量方差因此也不相同。CIGMA 利用细胞层数据估计每个个体–细胞类型组合内的变异 ,在方差组分估计中将其扣除。Figure 2c 显示,忽略这一项时,共享和特异遗传方差会明显向下偏。
这一步不是把每个细胞当作独立遗传样本。遗传信息的独立重复仍然来自 donor;更多细胞主要改善每个 donor 的表达均值精度。
参数估计与检验
作者使用 method-of-moments / Haseman–Elston 型回归估计方差组分,并通过 jackknife 估计标准误和进行检验。该路线比逐基因拟合复杂 REML 模型更适合成千上万个基因,但方差组分在单基因水平仍可能很噪,尤其当 donor 数量有限、真实遗传方差很小时。
主模型假定:给定共享效应后,各细胞类型的特异效应相互独立。论文也拟合了允许任意细胞类型遗传协方差的扩展模型;当前样本量下,完整协方差矩阵的单基因估计较不稳定,因此主要结论仍来自较简约的模型。
模拟与校准
Figure 2a 的两类置换检验回答不同问题:
- genotype permutation:打断基因型与表达的全部关系,共享和特异遗传方差都应接近 0;
- cell permutation:在个体内打乱细胞类型标签,保留总体遗传效应,但应消除真正的细胞类型差异。
Figure 2b 表明样本量增加主要缩小方差组分估计的不确定性。Figure 2c 更关键:如果忽略 ,或者用不匹配该数据结构的方法,估计会出现系统偏差。这里的 benchmark 重点不是预测准确率,而是共享与特异遗传方差能否在已知真值下被正确恢复。
实证结果
OneK1K 主分析使用 928 名个体、7 类常见 PBMC 和 10,288 个基因。cis 区域定义为基因体上下游 500 kb 内、MAF 大于 5% 的常见变异。作者检出 193 个经 Bonferroni 校正后显著的 cell-type-specific eGenes,但论文的核心结论来自全转录组方差分布,而不是只来自这 193 个基因。
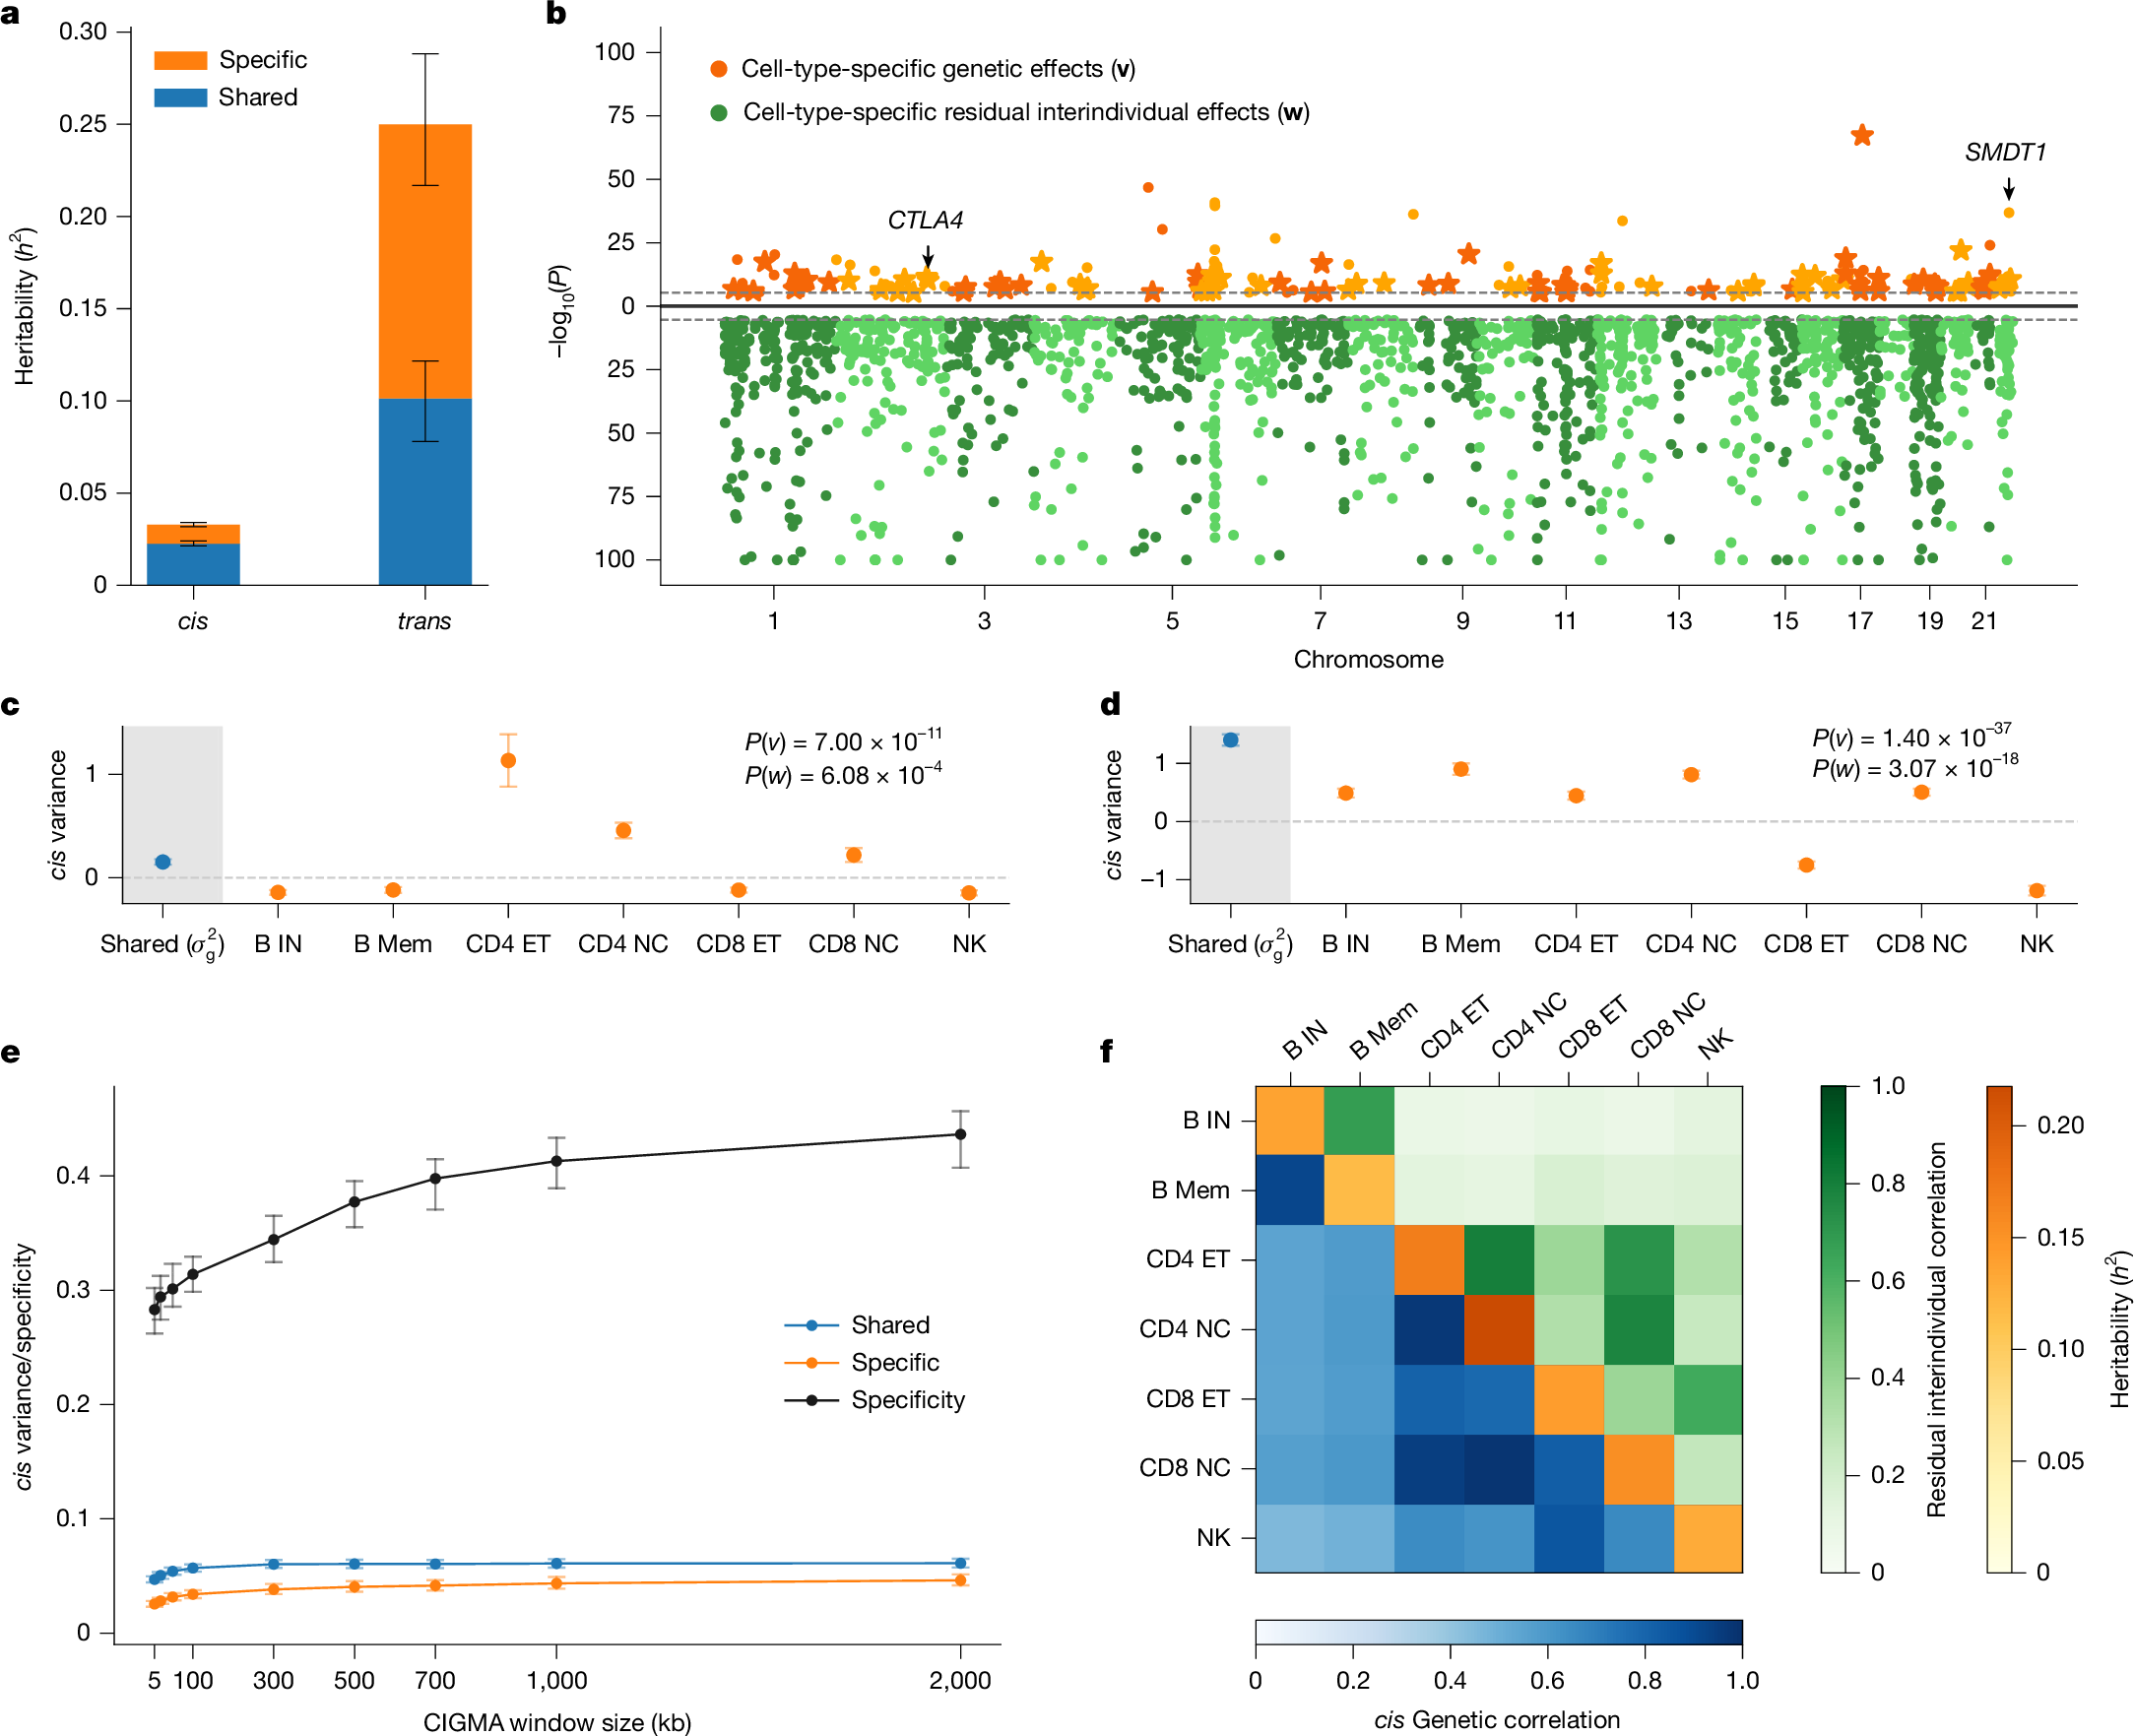
先看 a:cis 调控以共享成分为主,而 trans 调控的细胞类型特异成分更高;b 给出 10,288 个基因的检验结果;c、d 展示 CTLA4 和 SMDT1 的具体方差分解;e、f 分别说明调控距离与跨细胞类型相关性。
Chen et al., Nature (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大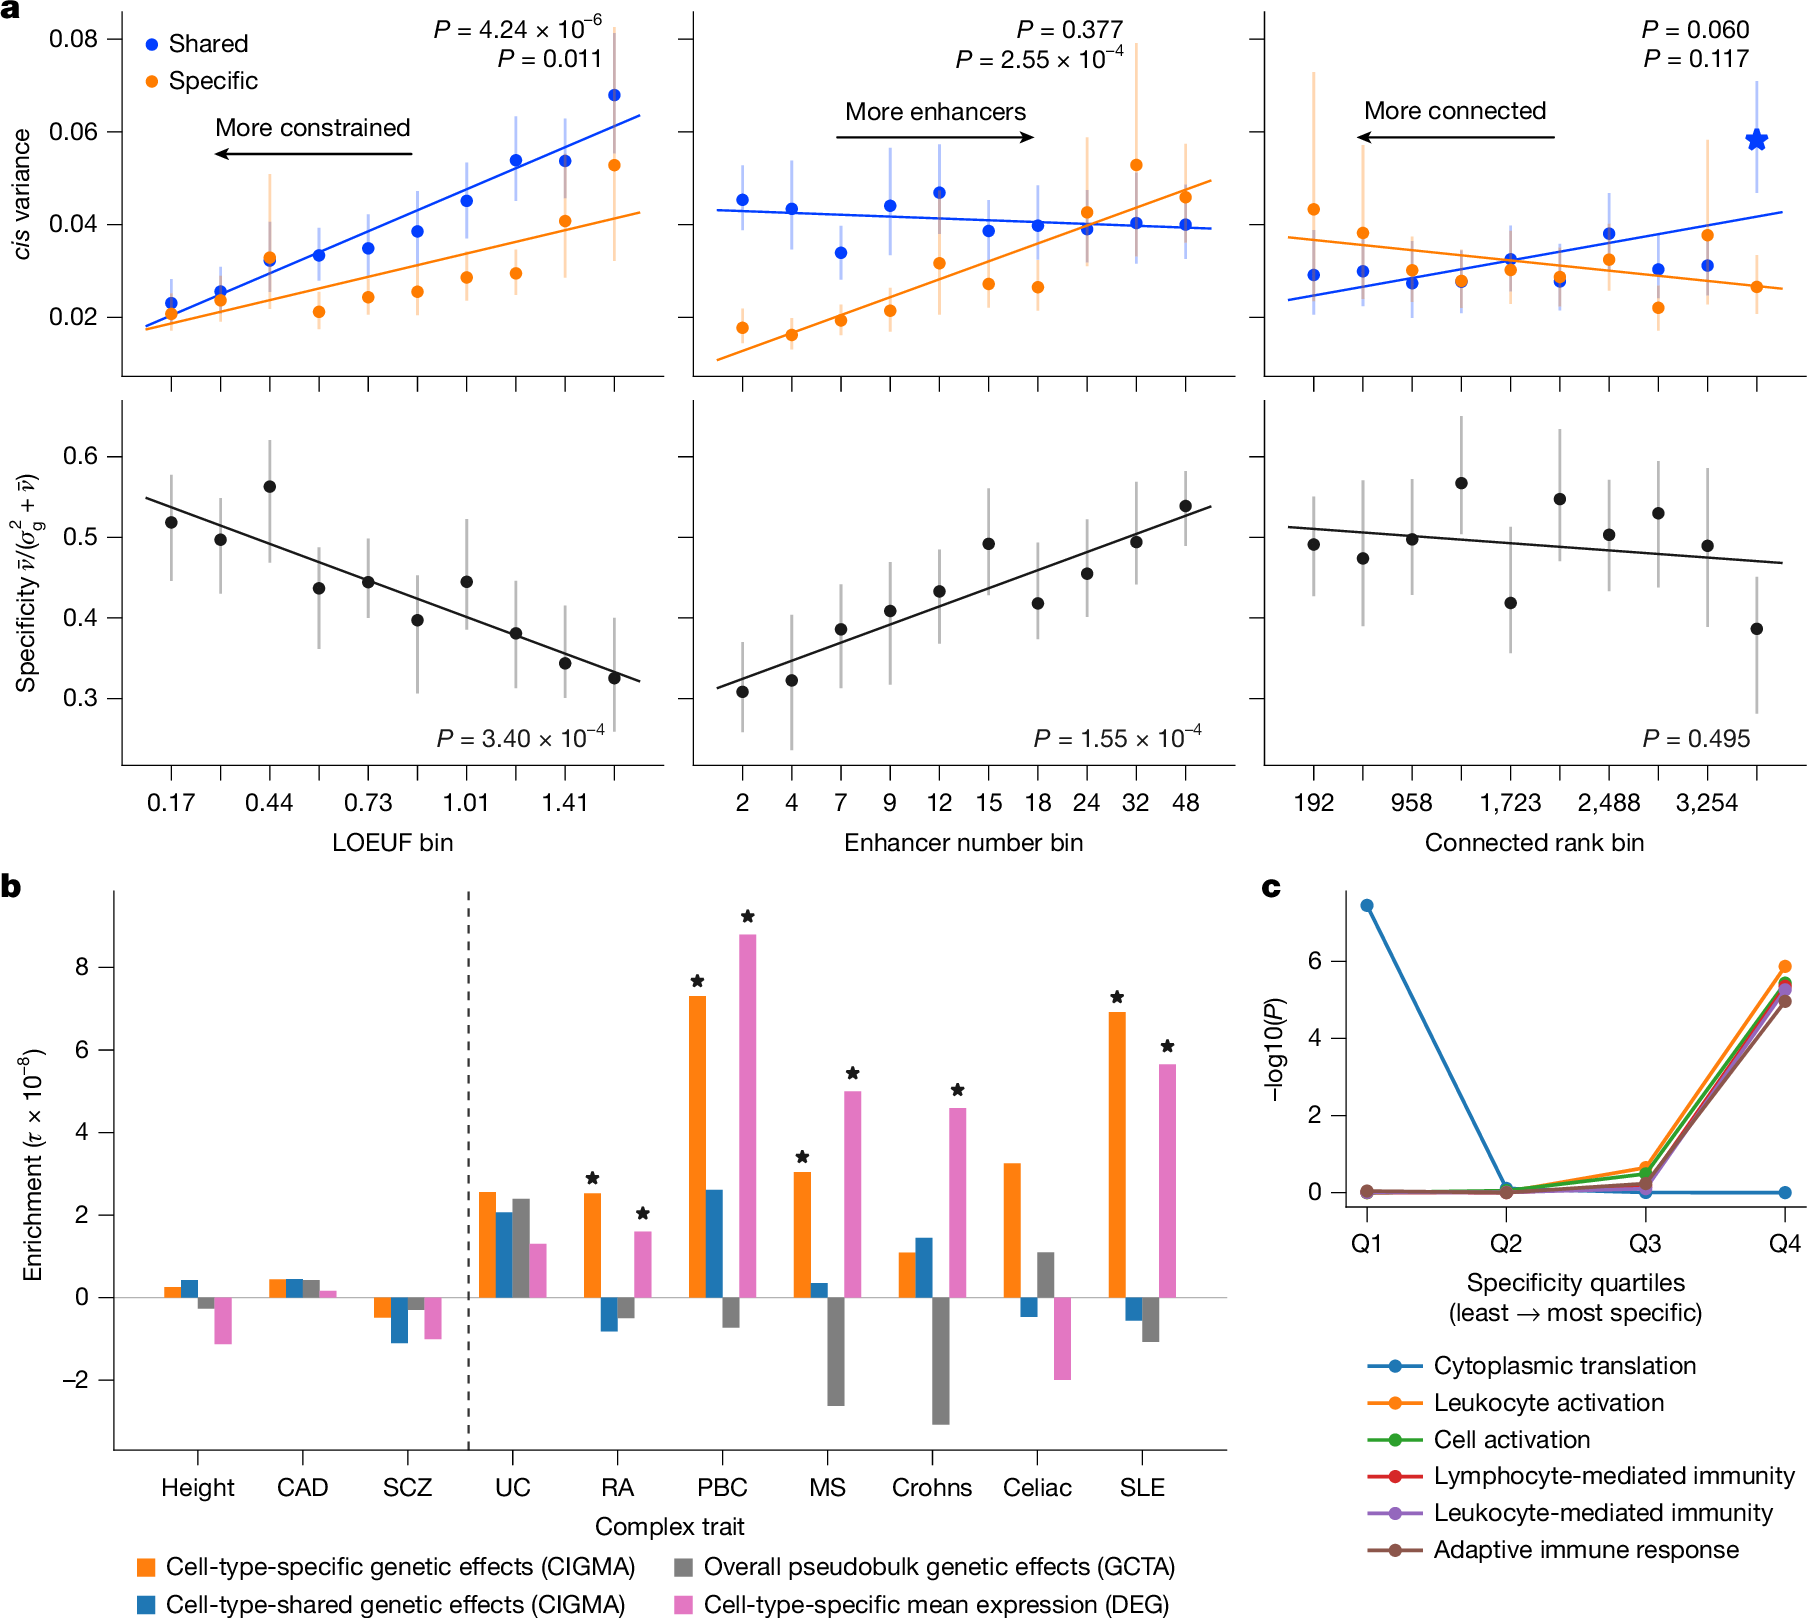
a 比较 eQTL 特异性与 LOEUF、增强子数量和共表达网络连接度;b 显示高细胞类型特异性的基因在血液相关性状中的遗传力富集;c 汇总随特异性变化的功能通路。
Chen et al., Nature (2026) · 原图未修改 · 原图未修改 · 原文图 · 放大平均来看,cis eQTL 方差约 30% 为细胞类型特异;把 cis 和跨染色体 trans 变异联合建模后,trans eQTL 方差约 60% 为细胞类型特异。特异性还随 cis 窗口变宽而上升,提示较远端的调控更依赖细胞环境。
细胞类型特异性较高的基因更受 loss-of-function 约束、连接更多增强子,并在共表达网络中具有更高连接度。作者进一步用 LDSC 检验基因集合周围注释的遗传力富集:高特异性基因在 7 个血液相关性状中的 4 个显示富集,而共享 eGene 集合没有相同模式。
与常规 sc-eQTL mapping 的区别
CIGMA 回答的是基因层面的遗传方差架构。它不能告诉我们某个位点中是哪一个变异具有因果作用,也不能直接给出某个 SNP 的细胞类型特异效应。
因此它与单变异 association、SuSiE fine-mapping 和 colocalization 是互补关系:
- CIGMA 可用于识别遗传调控高度依赖细胞类型的基因;
- 对这些基因,再在具体细胞类型或状态中进行 SNP-level eQTL mapping;
- 使用 LD-aware fine-mapping 区分同一位点中的多个信号;
- 最后检验 GWAS 与分子 QTL 是否共享因果变异。
不能把 CIGMA 的高特异性分数直接当作某个变异的 fine-mapping prior,因为它是基因和变异集合层面的量。
局限
- 细胞类型由离散标签定义,连续激活状态和细胞类型内部异质性会被 pseudobulk 平均掉;
- 方差组分依赖表达尺度,log-normalized expression 与原始计数模型的解释并不完全相同;
- trans 方差包含大量变异,单基因估计比 cis 更噪;
- 方法不能直接进行 SNP-level colocalization;
- 对低表达基因、较少见细胞类型或 donor 数较少的数据,特异方差可能出现较大标准误或边界估计。
小结
CIGMA 的主要贡献不是多检出一批 eQTL,而是说明:只统计已显著的 eQTL 会低估细胞类型特异调控。对复杂性状而言,尚未被常规 eQTL 研究稳定发现的弱、特异调控效应可能比共享的大效应更相关。