GPN-Star:进化时间尺度、突变率校准与功能约束
Predicting genome-wide functional constraints with GPN-Star
把多物种全基因组比对与物种树显式纳入 Transformer,在脊椎动物、哺乳动物和灵长类三个时间尺度学习功能约束。关键不只是高分基准:不同任务使用校准 LLR、绝对 LLR 或校准熵;S-LDSC 与 DeepRVAT 提供了遗传统计应用证据,但尚未完成注释辅助 SuSiE 的直接验证。
本文目录
问题:序列模型中的“少见”到底来自什么
自然界观察到的核苷酸分布同时受突变、选择与系统发育历史影响。一个语言模型认为 ALT 不常见,并不自动意味着该变异破坏功能。GPN-Star 的目标是从多物种全基因组比对中学习 特定进化时间尺度上的功能约束,并减弱突变率差异对分数的影响,而不是直接输出一般意义上的临床致病概率。正文
与 AlphaGenome Atlas 的区别是:后者主要把序列改变映射到分子测量与综合排序;GPN-Star 主要利用跨物种的可接受序列变化。两类模型的监督信息、输出含义和盲区不同,不能仅凭某一条 AUPRC 排序就断言其中一类可替代另一类。
架构:序列内注意力与系统发育交叉注意力分开
每个输入是一个多物种比对窗口及对应物种树。训练样本包含一个固定的主要目标物种,加上按 clade 分层抽样的 19 个目标物种;来源序列则使用比对中的全部物种。模型预测被遮盖的目标核苷酸,既看同一序列上下文,也看其他物种的同源位置。
相近来源物种先按进化距离划为 clade,再通过注意力池化压缩成 clade 级表示。每个 encoder block 依次包含序列内 self-attention、系统发育 cross-attention 和前馈网络。交叉注意力可概括为
其中 是目标物种到来源 clade 的进化距离, 是可学习的非线性距离编码。它不是把物种树简单拼接成输入标签,而是直接改变各来源序列的注意力权重。
还有两个防止“抄答案”的设计:同一 clade 的目标与来源序列在对应位置同步 mask;目标物种不能在 cross-attention 中读取自己所属 clade 的表示。这样可降低模型只复制极近缘物种核苷酸的倾向。序列内注意力的 query/key 共享主要目标物种的位置图,减少多目标输入的注意力图内存开销;比对坐标以主要目标基因组为准。补充材料,Model Architecture 与 Training Setup,PDF pp.5–9
三个时间尺度不是同一个模型的三个输出头
主要结果使用三套单独训练的约 200M 参数模型:V 为 100 个脊椎动物、128 bp 上下文;M 为 447 个哺乳动物、256 bp;P 为 243 个灵长类、256 bp。三者的 clade 数分别是 45、145、21。补充表报告在 8 张 A100 上分别训练约 4.5、6.6、4.2 天;这些是作者配置下的训练时间,不应直接拿来推算其他硬件或任务的成本。
训练集为人类染色体 1–20、X、Y,染色体 21 用于训练损失验证、22 留出。每个样本对 15% 的非 gap 目标位置选择遮盖,其中 90% 真正替换为 mask。损失并非在全基因组各位置等权:重复序列降权,PhyloP 与局部平滑后的 PhastCons 参与损失加权;推定中性位点还进行随机核苷酸扰动。因此“未用致病标签监督”不等于“没有利用既有保守性注释”。补充材料,Training Setup 与 Supplementary Table 1
较短上下文也是有原因的:跨物种比对片段可能存在重排与断裂,相邻的人类坐标不保证在其他物种中仍连续。作者发现增大上下文的收益有限,不能把 128/256 bp 简单解释为所有调控作用都发生在这个范围内。
分数定义与突变率校准
在目标位点 mask 中心核苷酸后,模型给出 A/C/G/T 的概率。变异特异分数为
很负的值表示 ALT 相对 REF 更不被该进化上下文接受。另一个量是核苷酸分布熵
它衡量位置上的不确定性,不区分这个位置的三个 ALT。
校准先寻找高可信中性位置:人类模型使用可由小鼠重复序列 liftOver 并与人类重复序列重叠的 ancestral repeats,再要求 PhyloP 在 −0.1 到 0.1、PhastCons 为 0。按中心 五核苷酸上下文 分组估计中性平均分数,并执行
LLR 用减法、熵用除法;不能把两者都写成除以突变率。作者以 Roulette 等突变率估计检查校准后相关性降低,并观察到多数基准改善。但“近乎消除所检验相关”不等于从观测序列中完整识别了所有选择与人口史成分;校准仍依赖中性区域与局部上下文假设。补充材料,Inference 与 Mutation Rate Calibration,PDF pp.10–11
三个应用的打分规则不同:致病变异与稀有变异分析主要用 cLLR;GWAS 精细定位标签排序用其绝对值;S-LDSC 结果主要用校准熵。作者最初也尝试绝对 LLR,但发现熵对遗传力更有信息。这意味着不能把整篇论文的成功概括成“一条变异特异 cLLR 适用于所有任务”。
精细定位基准检验的是排序,不是新的 fine-mapping 模型
Figure 2 的 GWAS 基准把既有分析中的高 PIP 变异作为推定阳性、低 PIP 变异作为推定阴性:阈值为 PIP >0.9 与 PIP <0.01,编码和非编码数据分别覆盖 65 和 83 项 UKB 性状。非编码基准为每个阳性匹配九个对照,匹配染色体、后果类型、TSS 距离、LD score 与 MAF;编码集主要匹配 MAF。
GPN-Star (M) 在这两类任务中表现最好;V 则在 ClinVar 编码、COSMIC 等若干任务更突出。高 PIP 标签本身仍来自统计模型,并非实验确证的因果金标准;低 PIP 也不等于确定无效。该评价说明注释能否把已有强证据候选排在前面,没有直接检验把它放进 SuSiE 后 credible set 覆盖率是否正确。
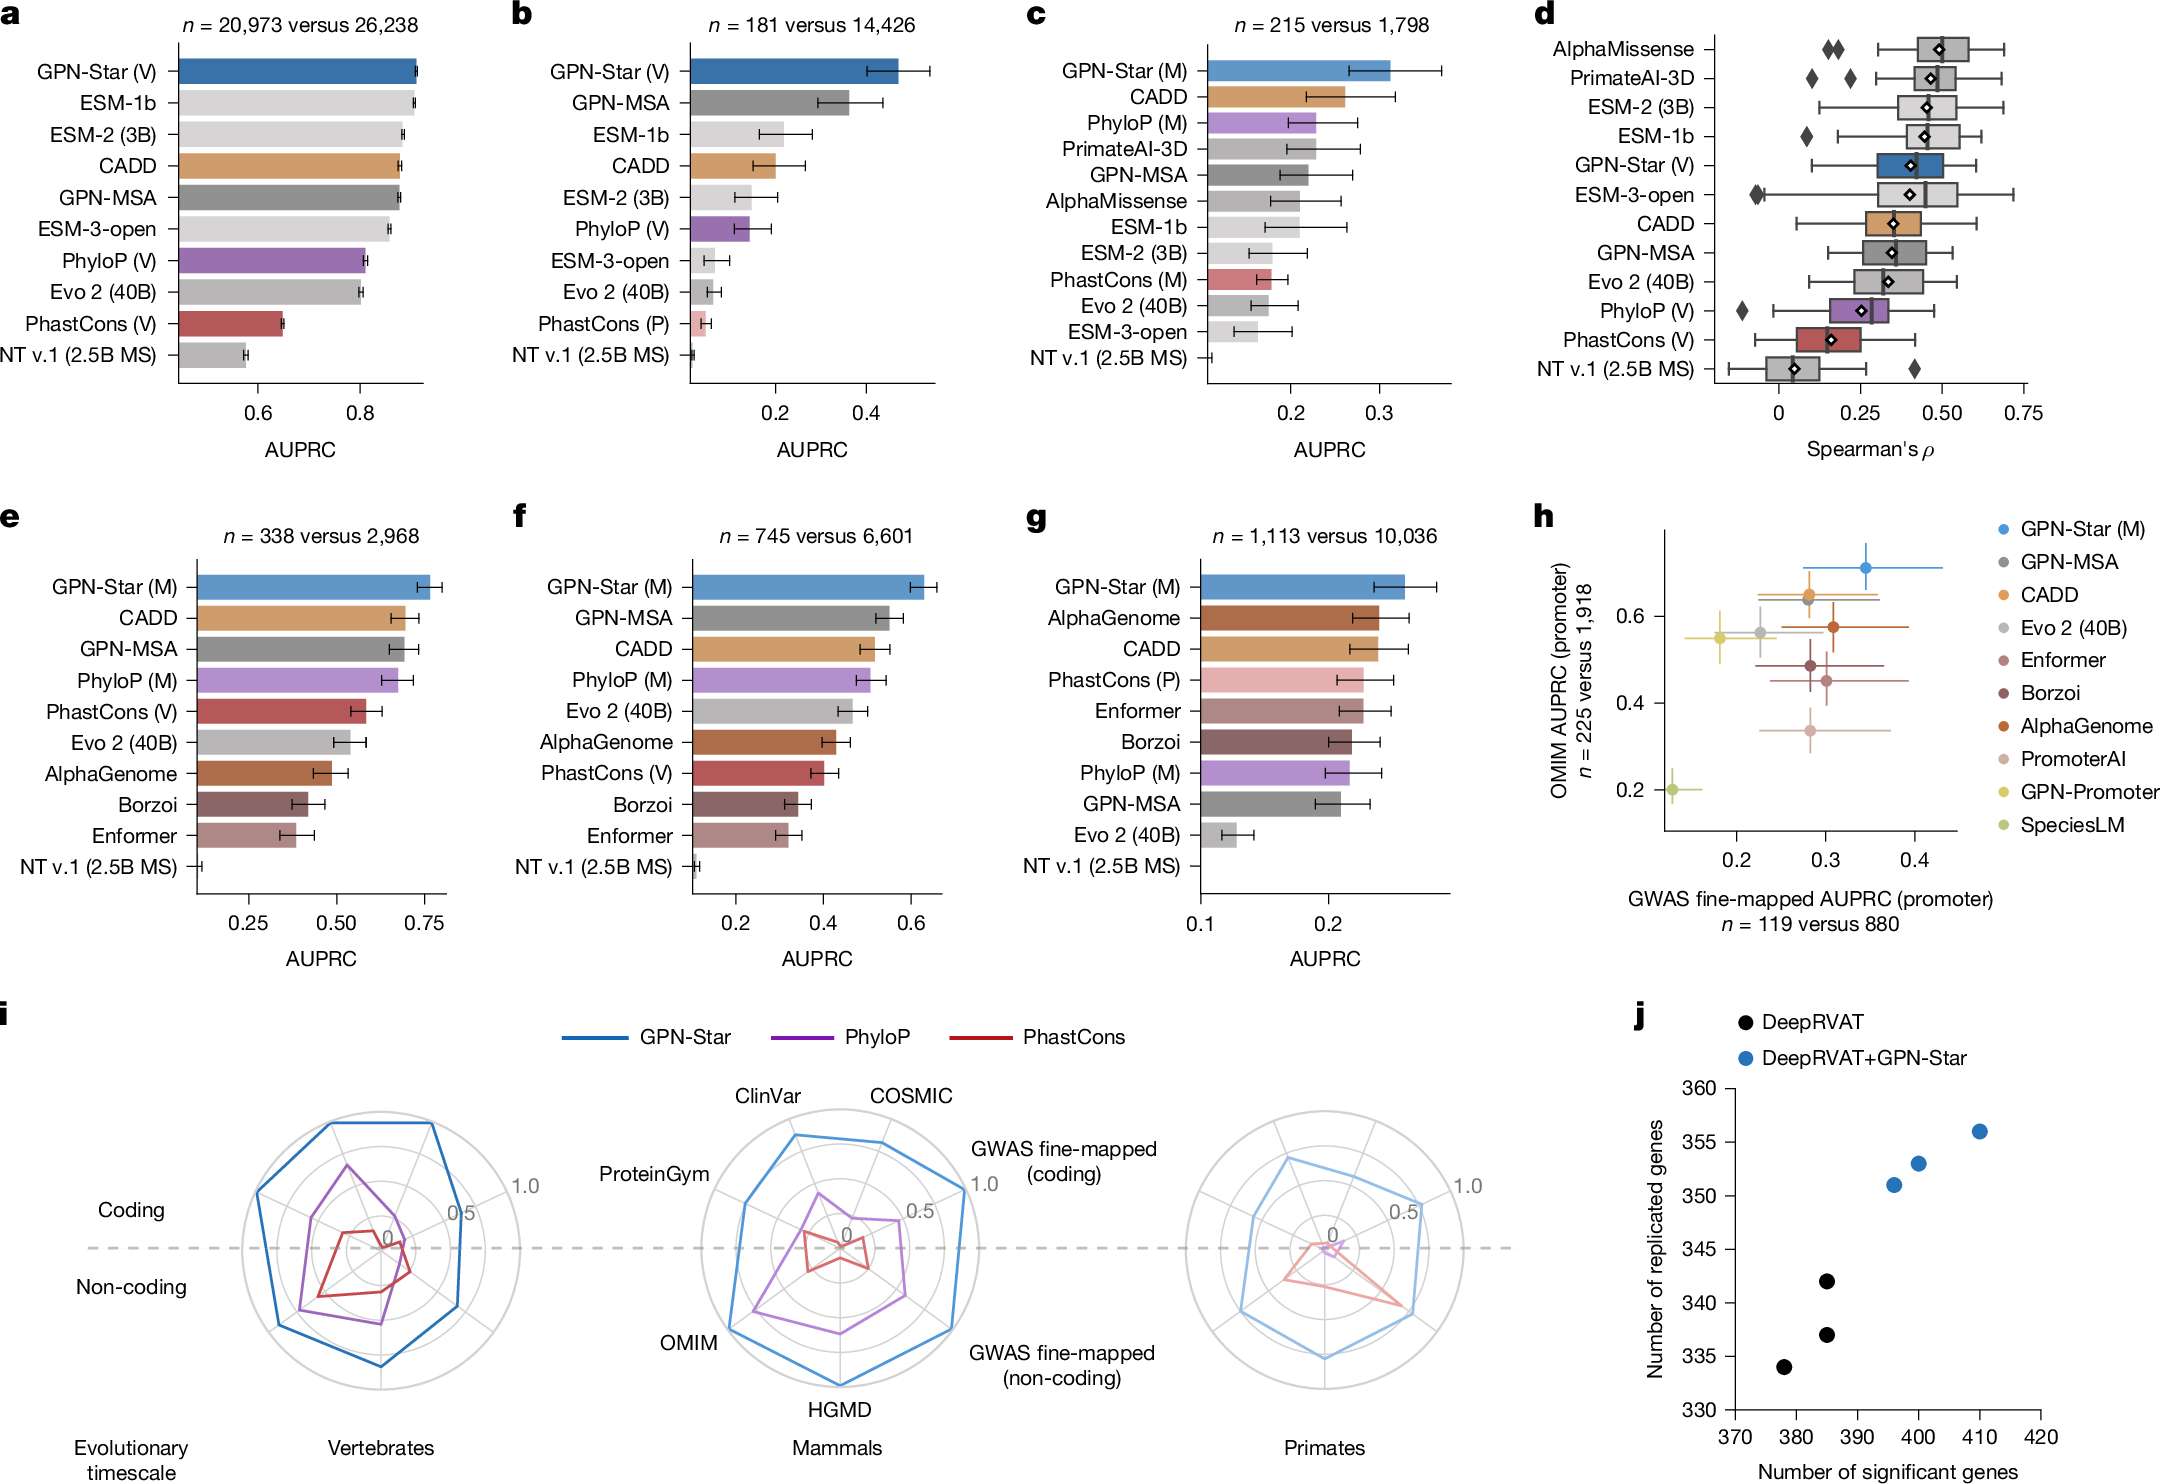
a–h 是不同标注任务,不共享相同阳性比例;各面板突出最佳 GPN-Star 时间尺度。j 的 DeepRVAT 比较包含三次随机初始化,复制来自更大但仍为 UKB 的研究,不是独立队列验证。
Ye et al., Nature (2026), Figure 2. · CC BY 4.0 · 原图未修改 · 原文图 · 放大对于 ClinVar,加入 gnomAD 频率的事后调整可提升 GPN-Star (V) 的表现。但临床数据库分类也使用频率信息,因此这个结果与完全不使用群体频率的比较具有不同解释。基准中的 AlphaGenome 也不应被自动等同于同日新公开的 AVI 集成评分;这不是 GPN-Star 与 AlphaGenome Atlas 在完全统一设置下的新一轮全面对决。正文 Figure 2;补充 Evaluation Benchmarks
S-LDSC:区分注释富集与独立条件贡献
作者使用 9,997,231 个参考 SNP,其中 5,961,159 个 MAF ≥5% 的常见 SNP 用于确定注释比例。主分析取最受约束的前 0.1%,加入 baselineLD v2.2 的 96 项特征后,分别运行 S-LDSC,再对 106 项可获取的独立性状做随机效应 meta-analysis。LD 参考来自 479 名 1000 Genomes 欧洲祖源个体。
遗传力富集是注释覆盖的遗传力比例除以覆盖 SNP 比例;它包含与其他注释重叠的贡献。标准化条件系数 则关注在其余注释已入模后,该注释增加一个标准差所对应的每 SNP 遗传力变化。高富集不自动意味着提供独立于所有既有注释的信息,因此 Figure 3 同时展示两类统计量很重要。
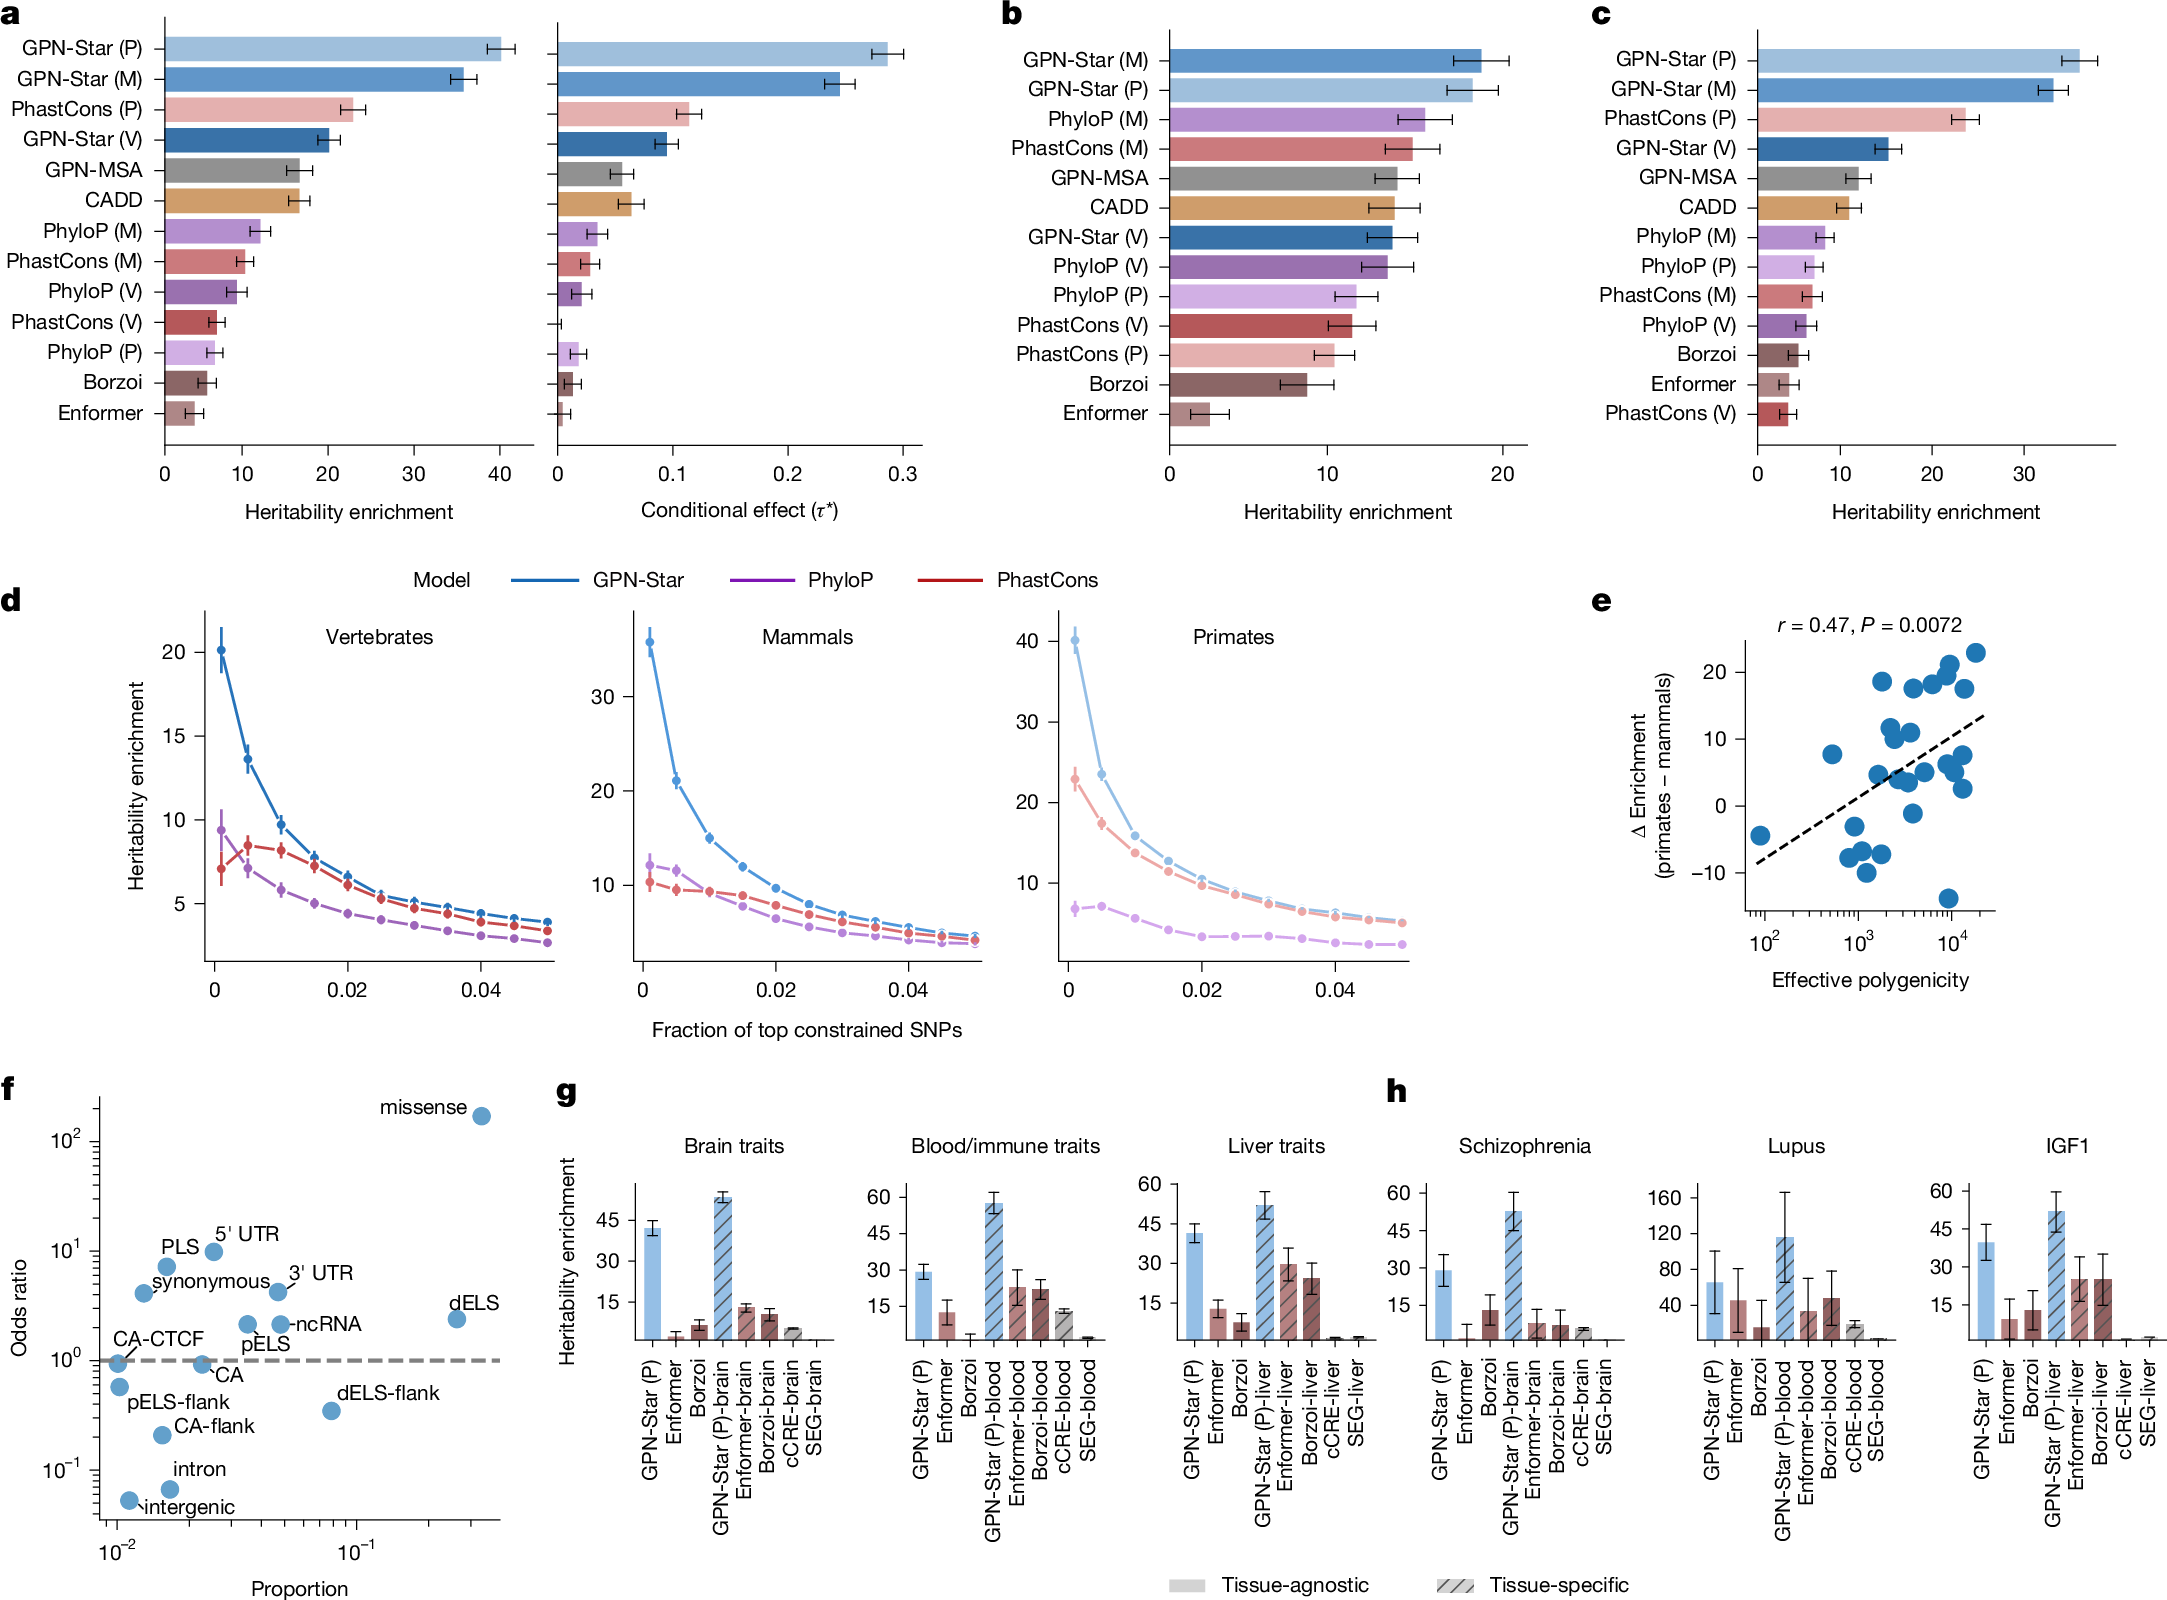
a 同时报告富集和标准化条件系数;b–d 区分编码/非编码与阈值敏感性;e 的时间尺度差异与有效多基因性相关只基于 27 项性状;g–h 的组织信息是额外注释约束,不是 GPN-Star 直接预测组织内分子表型。
Ye et al., Nature (2026), Figure 3. · CC BY 4.0 · 原图未修改 · 原文图 · 放大P 模型整体最突出,M 次之,非编码区域和远端增强子尤值得关注。P 相对 M 的富集优势与有效多基因性在 27 项性状上呈相关(,单侧 );这只是跨性状的关联,不能解释为已证明某种进化机制决定多基因性。
组织特异版本是再把高分变异限制在组织特异表达基因附近或 cCRE 内,并使注释大小可比;不是模型自己生成了该组织的表达效应。这样在脑、免疫等部分设置有改善,但并非总超过组织无关版本。补充材料还以较少共同物种重训,检查 P 模型相对 PhastCons 的优势是否仅来自比对物种更多。正文 Figure 3;补充材料 S-LDSC analysis,PDF pp.18–20
DeepRVAT:有增益,但属于编码数据与同队列扩展验证
作者向已含 AlphaMissense、PrimateAI、DeepSEA 等注释的 DeepRVAT 同时加入 V/M/P 三个分数。样本为 161,822 名无三等亲或更近关系的欧洲祖源 UKB 参与者;训练保留 MAF <1% 的变异,关联检验保留 MAF <0.1%。模型沿用 21 项训练性状,在 34 项定量性状上检验,其中 13 项不在训练性状中。
三个随机初始化下,平均显著发现数从 383 增至 402;可在更大 UKB WES 研究中找到支持的基因–性状关联平均从 338 增至 353。检验使用 DeepRVAT 基因评分与 REGENIE,并采用 Bonferroni 控制。这里的 replication 参照仍来自 UKB,可能包含样本重叠,不能写成独立祖源或外部队列复制。数据是 WES;对非编码 RVAT 的更大收益仍是作者展望,而非本文已完成的验证。正文 Rare variant association testing;补充材料 PDF p.20
可复用之处与研究边界
最值得复用的是把 时间尺度、分数变换与任务 一起选择,而不是把 V/M/P 简单平均。模型仍依赖固定比对,推理需要同源序列;indel、结构变异和人类特有的细粒度选择不是当前框架的强项。约束高不代表一定影响某项研究表型,模型本身也不给组织特异效应方向。
针对注释辅助 fine-mapping,后续可以分别检验 cLLR、绝对 cLLR、校准熵及模态注释的互补信息,按位点留出学习先验,并报告 PIP 校准和 credible set 覆盖率,而不是只用现有高 PIP 标签做排序。以上是研究建议,不是本文已经实现的 SuSiE 方法。
阅读范围与资源
已阅读正文与 Methods,补读独立补充 PDF 的架构、训练、突变率校准、基准构造、S-LDSC 和 DeepRVAT 方法,并核对相关原图及训练表;没有重新训练模型或运行人群关联分析。预计算分数与权重见 作者 Hugging Face 集合,代码见 songlab-cal/gpn。