CASTIE:全 cis 扫描中的细胞状态交互 eQTL
Scalable context-dependent single-cell eQTL mapping reveals disease-relevant regulatory variation beyond static models
CASTIE 用两类随机效应、可复用的基因零模型及自适应供者稳健方差扫描状态交互 eQTL,在免疫细胞与代谢刺激数据中恢复静态模型遗漏的调控关联。
本文目录
全文解读|medRxiv v1,2026-08-14 公开,尚未经同行评议。 本文依据 59 页 PDF 主文、Methods、主图 1–5 和补图 1–19;未附独立 Supplementary Notes 与 Tables 1–19,完整结果清单及基准原始表尚未逐项核验。论文与 PDF · 方法代码 · 分析代码 · 汇总统计量
为什么静态 eQTL 会遗漏信号
同一个等位基因在不同细胞状态下可能改变效应强度,甚至使表达效应反向。将细胞按供者汇总,或先筛出平均效应显著的 eQTL 再检验交互,可能遗漏这些平均效应很小的信号。CASTIE 的目标是直接扫描 ,其中 可表示连续转录程序、拟时序、细胞亚型、实验刺激,也可表示供者年龄或性别。它保留细胞层面的状态差异,但遗传推断仍需处理同一供者细胞之间的相关性;百万细胞不等于百万个独立遗传样本。
模型中为何需要两类随机效应
本文分析使用 SCTransform 校正后的 Poisson-scale counts 并加入测序深度 offset。令 为该预处理后某基因在细胞 的计数, 为供者基因型复制到细胞层面的剂量, 为状态协变量。模型写为
为测序深度 offset; 含年龄、性别、基因型主成分等协变量,实际设计矩阵应避免与 的主效应重复。连续状态先中心化、标准化,多状态模型再除以 。因此交互系数依赖状态的编码与尺度。 表示中心化状态下的静态项,细胞层面的总等位基因效应为 ;它位于对数均值尺度,不能直接等同于表达量的加性差值。
设 是细胞到供者的指示矩阵, 是供者遗传关系矩阵, 为细胞×状态矩阵,则
第一项处理同一供者的重复测量及供者亲缘关系;第二项使残差协方差随细胞状态相似度改变。若 ,可将第二项理解为供者特异的随机状态效应:同一供者的两个细胞会因为状态相似而共享额外波动。有亲缘关系时,公式也允许跨供者相关,不能一概称为严格的供者内块对角矩阵。将 作为固定效应只能解释平均表达沿状态的改变,无法自动消除这种状态相关的残差结构。
这也说明本模型的 Poisson 假设是条件于随机效应的假设;边际分布已可呈过度离散,但仍不保证足以拟合每个基因。作者将负二项等扩展列为后续方向。
从百万细胞到全 cis 扫描:计算与检验如何衔接
每个基因只拟合一次不含基因型的零模型。 CASTIE 用 PQL 与 AI-REML 估计固定效应和两个方差分量,保存稀疏 GRM;利用多细胞共享供者的结构,通过 Sherman–Morrison–Woodbury 恒等式计算工作协方差的逆作用。作者报告,多细胞/供者场景下该步骤比 PCG 快约 10–20 倍。关键是避免为每个 SNP 重新估计整个混合模型,并减少细胞级大型协方差运算。
扫描 SNP 时使用 score test。 用零模型残差 构造 和 。完整模型的 score 方差较昂贵,因此先在一小批随机标记上估计“完整方差/快速近似方差”比值,再用于其余标记;静态项与交互项分别校准。交互检验还条件于边际遗传效应,避免强静态 eQTL 经相关状态变量泄漏成交互信号。稀疏计数和供者细胞数不均衡会影响尾部近似,标准化统计量超过预设阈值时使用鞍点近似 SPA。
两随机效应之外,仍有供者聚类稳健方差。 对细胞层面的状态,CASTIE 额外计算条件交互 score 的 donor-clustered HC1 sandwich 方差。先将细胞贡献按供者求和为 ,再计算
其中 为供者数, 为固定效应参数数目, 为供者级贡献的均值。当校准标记上“稳健方差/模型方差”的中位数超过 ,才对该状态启用替换;供者层面的年龄、性别等状态不启用此步骤。因此与 Dynema 对读时,不能把两者简单划为“混合模型”和“稳健标准误”两派。两者都有供者聚类校准,但拟合和计算组织不同:
| 环节 | CASTIE | Dynema |
|---|---|---|
| 供者相关性 | GRM 随机截距、状态相关随机效应,细胞状态检验自适应追加 HC1 | 按供者聚类的稳健 score,当前假设供者间独立 |
| 极端尾部校准 | score 方差比、SPA | 解析近似及自适应 wild score bootstrap |
| 零模型节省 | 每基因拟合 genotype-free null,复用于 cis 变异 | 每个检验的零模型拟合一次,bootstrap 内不反复拟合;不是所有 SNP 共用同一 null |
| 深度调整 | 本文分析使用固定系数的 log-depth offset | 本文分析中 log 总 UMI 是估计系数的协变量 |
CASTIE 没有提供与 Dynema 的直接基准比较。两篇 OneK1K 的细胞筛选、状态定义、窗口和显著性流程也不同,不能用 eGene 数量或各自报告的秒数直接判断胜负。
显著性落在基因层面。 cis 窗口为基因体两端各扩展 1 Mb,扫描 的常见变异。多状态证据可用 ACAT-O 合并;每个基因窗口内用 ACAT-V 汇总 SNP P 值,静态和交互分别形成基因级证据,多状态基因级证据还可继续用 ACAT 合并。各分析对所有受检基因应用 Storey q-value, 定义 eGene。文中也用 SKAT 合并多状态效应,尤其功效模拟为了与 CellRegMap 对齐使用 SKAT,不能将它与 ACAT-O 混称为同一检验。
效能数字应怎样读
模拟基于 OneK1K B 细胞的 982 位供者、124,968 个细胞,保留真实供者与状态结构。功效在 下比较,固定总遗传方差、改变交互所占比例;CASTIE 的供者基因型置换结果总体校准,简单随机截距 glmer 在所考察场景中膨胀。功效生成模型包含与 CASTIE 一致的 Poisson 和两随机效应结构,因此结果支持这些设定下的表现,尚不是对任意失配模型的全面验证。
作者报告单个 SNP–gene 测试的中位运行量:CASTIE 55 秒、单核、峰值 0.8 GB;CellRegMap 57 分钟、约 13 核、98 GB。作者另汇总为约 500 倍总 CPU 时间节省和约 120 倍内存节省。对约 6,000 个 cis 变异复用零模型的每基因扫描,又报告约 倍计算时间差和 110 倍内存差。这些分母不同,不能写成“每次检验快百万倍”。所提供 PDF 未包含基准 Supplementary Tables 2–3,运行量汇总方式与完整扫描测量范围尚不能独立核对。
OneK1K:新增的是对应细胞群中的状态依赖发现
OneK1K 分析包含 982 位供者、约 120 万个 PBMC。作者在七个主要免疫细胞群中报告 10,516 个 eGenes,其中 3,155 个为 context-dependent eGenes,2,022 个在对应静态分析中未检出。这里是基因级发现,不能解释为同样数量的独立因果 SNP,也不能把“对应细胞群无静态信号”改写成“所有组织均无静态效应”。
T 细胞合并相关亚型,以 16 个功能程序、两个细胞周期程序及年龄、性别构成 20 个状态。结果为 4,606 个静态 eGenes、2,888 个状态依赖 eGenes,两者重叠 987 个;新增 个,相对静态增加约 41%。这一明确分母比跨细胞群总数更易解读。
GCHFR 展示了状态汇总可能遗漏的效应。chr15:40765309 的 T 等位基因在高 CD8 effector-memory/cytotoxic 状态下降低表达,沿 CD4 central-memory 轴则升高表达;T 细胞静态项 。CD8 effector-memory、CD4 central-memory、cytotoxic 三个状态的交互 eQTL 与甘油三酯信号的共定位支持分别为 。相反方向能够解释平均效应被削弱,但相关程序间的信号不能当作三个独立机制。
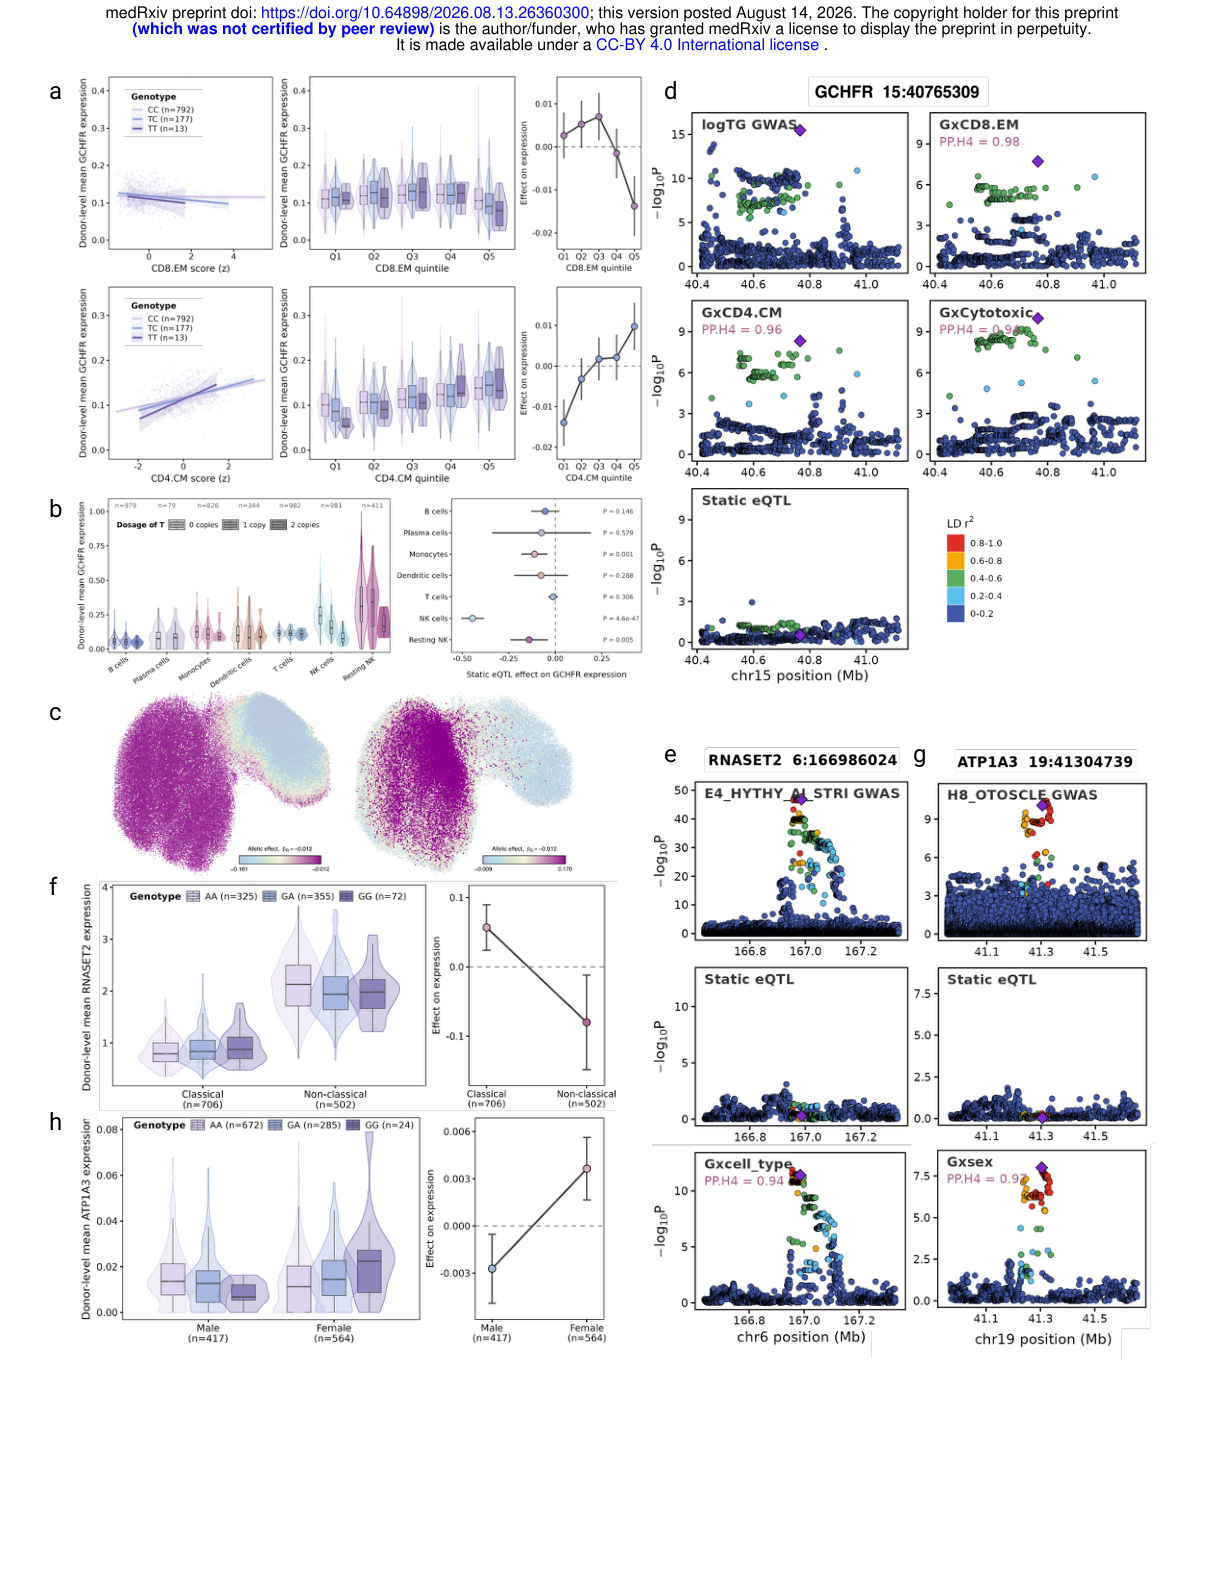
a–d 连接 GCHFR 的供者可视化、细胞总效应与甘油三酯关联;e–f 展示 RNASET2 的亚型差异。正式检验来自单细胞模型。g 的 ATP1A3 共定位在图面及正文为 0.97、原图注为 0.9,存在不一致。原图注在 PDF 第 38 页。
Liu, Cuomo et al., medRxiv v1 (2026-08-14), Figure 4 · CC BY 4.0 · 原图未修改 · 原文图 · 放大共定位结果与不能直接套用普通 LD 的原因
作者用 SMR 作筛选,随后对符合 eQTL、GWAS 显著性及非 MHC 条件的候选进行 coloc.abf。374 个状态依赖 eQTL–性状共定位关联达到 ,涉及 131 个基因和 94 种性状;去掉状态这一维度后,是 270 个 gene×trait×cell-compartment 组合,不是 270 个独立基因组区域。其中 197 个未被对应静态共定位恢复:106 个没有对应静态 eGene,91 个有静态 eQTL 却没有静态共定位。
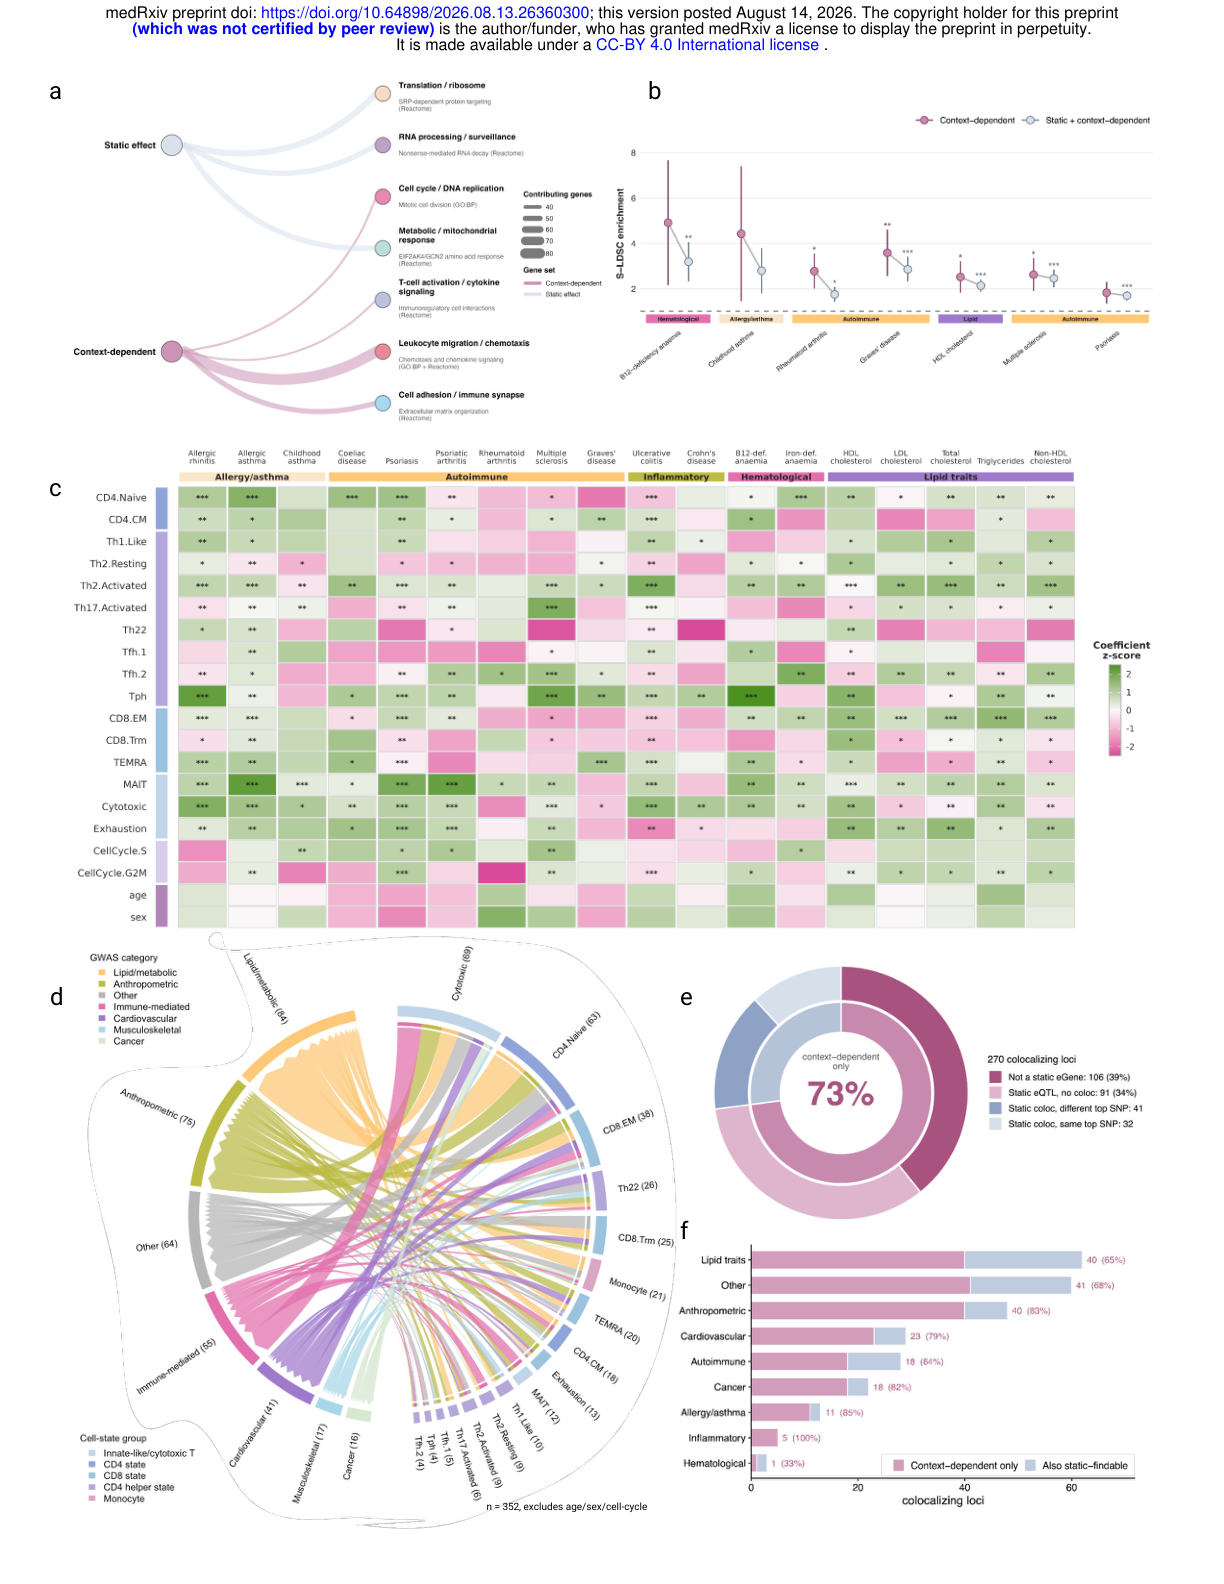
e 将 197/270 个静态未恢复组合拆成无静态 eGene和静态不共定位两类;d 的 352 个关联排除了年龄、性别与细胞周期,计数范围不同。c 的底色是 S-LDSC 系数 z-score,星号对应富集检验的名义 P 值。原图注在 PDF 第 36 页。
Liu, Cuomo et al., medRxiv v1 (2026-08-14), Figure 3 · CC BY 4.0 · 原图未修改 · 原文图 · 放大核心统计问题是:交互检验的预测变量为 ,跨 SNP 统计量的协方差还取决于细胞状态分布、供者细胞组成和模型权重。普通基因型 LD 不能自动充当它的协方差参考。因此作者未进行 HEIDI 过滤,也未直接用标准 SuSiE 做交互信号的精细定位。coloc.abf 无须显式输入 LD,但依赖单因果变异假设,并使用默认先验 。高 支持该假设下的信号共享,不证明表达介导性状,也不必然指向唯一因果变异。RNASET2 的免疫相关实例仍对应外部 GWAS 的 18 变异 credible set。
AMSC:从内源状态扩展到代谢刺激
第二个系统包含 118 位供者的脂肪来源间充质干细胞,组成四个 cell villages,在基础、低葡萄糖、游离脂肪酸及缺氧条件下分化;Fig.5 标出 337,666 个核。静息 AMSC、SWAT 细胞和脂肪细胞分别有 1,598、1,765、1,694 个静态 eGenes;加入状态交互后新增比例分别为 36%、84%、92%。这些比例是相对各细胞群静态发现数的增幅,不是供者数或位点共定位率的提升。
脂肪细胞中 MARK3 的负向等位基因效应在缺氧下更强,交互信号与 2 型糖尿病共定位 ;静态 eQTL 共定位支持较弱。PRRX1 的游离脂肪酸依赖信号与 BMI 共定位 。实验条件较内源表达程序更便于解释,但这些仍是关联与共定位证据;AMSC 生成和部分分析细节另引 Huang 等的配套研究,本 PDF 并未完整提供。
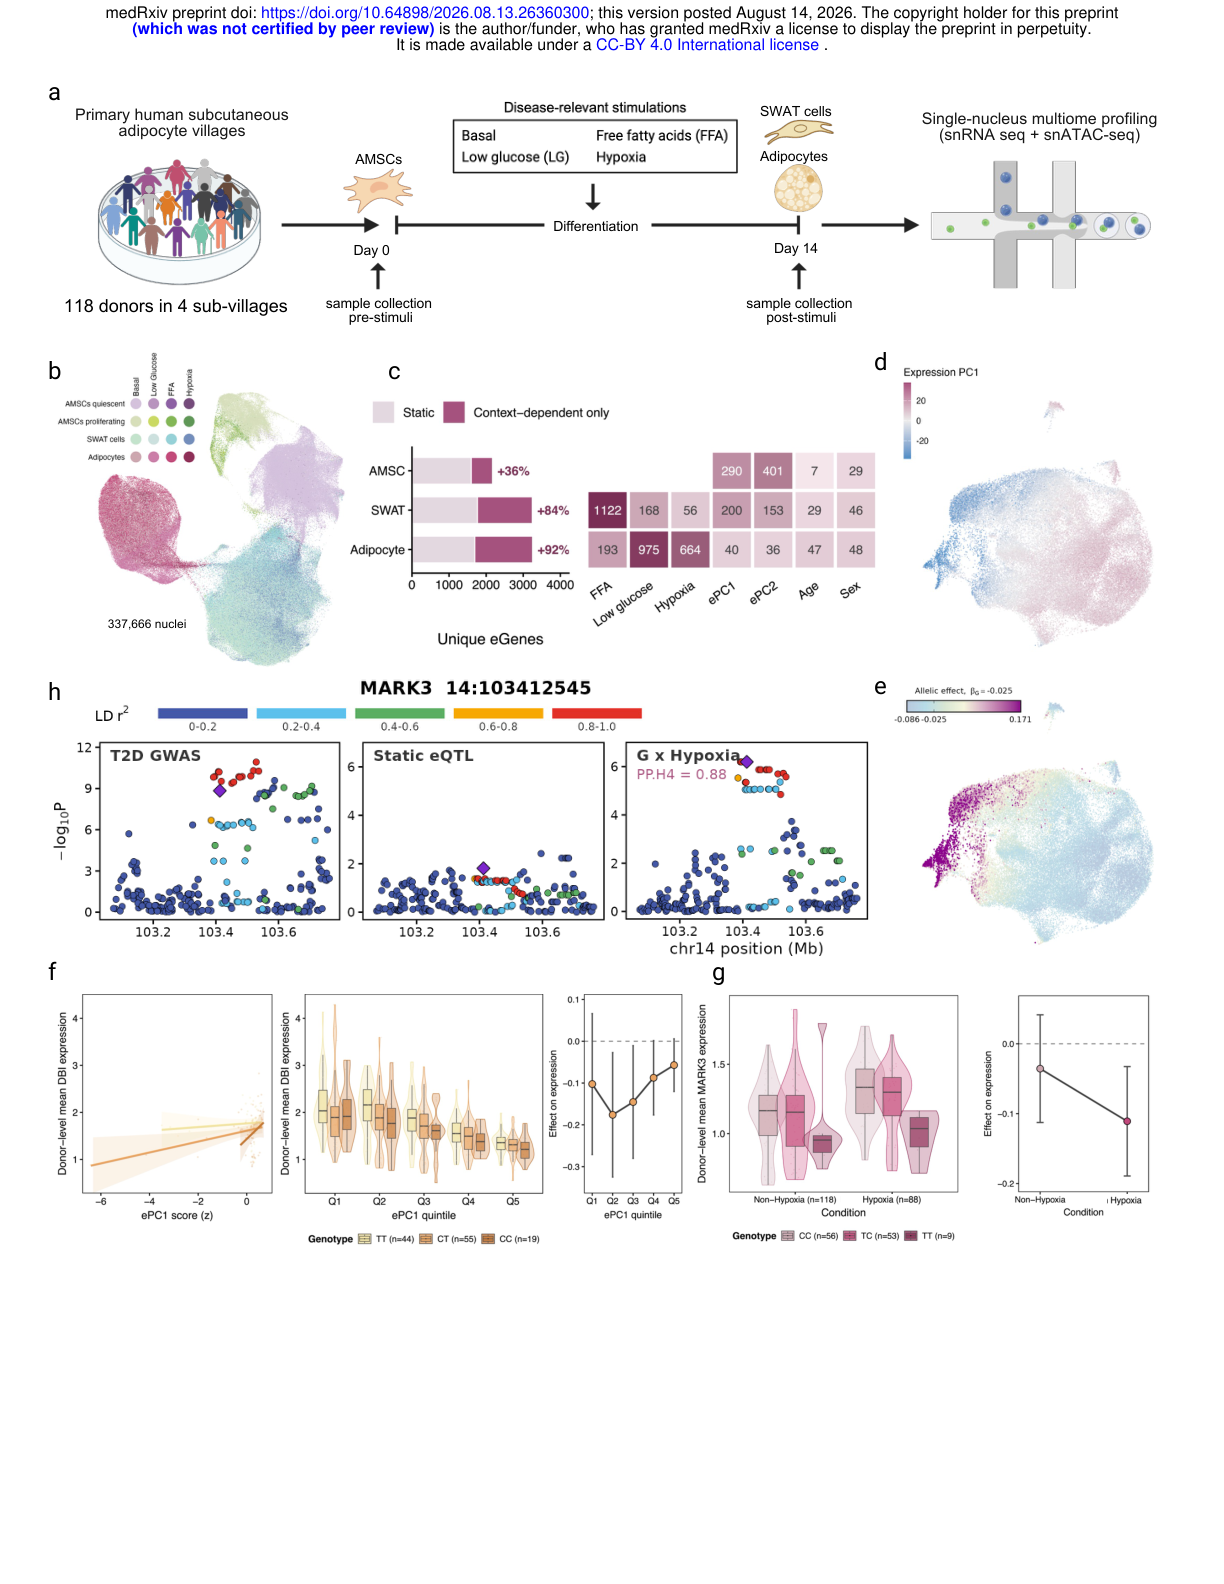
a–c 展示 AMSC 实验与各细胞群新增发现的分母;g–h 连接 MARK3 的缺氧依赖效应与糖尿病共定位。e–f 的 DBI 表达 PC1 是推导状态,不能直接当作分化时间。原图注在 PDF 第 40 页。
Liu, Cuomo et al., medRxiv v1 (2026-08-14), Figure 5 · CC BY 4.0 · 原图未修改 · 原文图 · 放大局限与可继续研究的问题
表达推导的状态有循环性:被检验基因若本身参与状态得分构建,其表达同时出现在响应和协变量中。作者按每个程序的前 50 个 loading 基因标记风险,374 个共定位中有 5 个属于“自身程序的 marker”。比例低不能证明其余关联完全免疫于内生性;marker-independent 状态、leave-one-gene-out 或独立数据学习状态是值得验证的方向。相关转录程序之间也不能直接作独立遗传力归因;作者联合静态与状态特异注释后的 S-LDSC 系数证据有限,并未充分证明额外独立遗传力贡献。
两队列主要为欧洲祖源,当前常见变异筛选也限制稀有变异推断。合并亚型与分层分析存在取舍:单核细胞联合模型恢复分层扫描 1,081 个 eGenes 中的 916 个,另外仍有 165 个只被分层分析发现。因此合理目标是比较不同状态结构下的校准、功效与计算代价,而不是把连续交互建模视为亚型分层的普遍替代。